Agent Harness
13 章 · 约 80 千字
目录
- 智能体框架(Harness)到底是什么?
- Harness到底是什么?一篇给你讲透
- 模型不是关键,Harness 才是
- 高效Agents的尽头是,Harness
- 模型越来越强,为什么大家却开始重写 Harness
- Harness驱动的Agent
- Harness is the New Dataset:模型智能提升的下一个关键方向
- 长时自主Agent,先解决这8个Harness核心问题
- AI Harness 工程:Agent 能跑起来的那一层到底是什么?
- Harness Engineering 深度解析
- Harness Engineering:同一个模型,从42%到78%——Vibe Coding时代真正的护城河
- 我的Harness Engineering实践
- Claude Harness Engineering 操作手册
智能体框架(Harness)到底是什么?
智能体 = 模型 + 框架
如果你不是模型,你就是框架。这个公式听起来简单,但真正理解它需要费点功夫。
所谓框架(Harness () ),就是除了模型本身之外的所有东西——代码、配置、执行逻辑。一个裸模型不是智能体,它只是个能输出文字的"大脑"。但当框架给它装上状态管理、工具执行、反馈循环和各种约束之后,它才真正变成一个能干活的智能体。
具体来说,框架里包含这些东西:系统提示、工具和技能(包括 MCP 及其描述)、捆绑的基础设施(文件系统、沙箱、浏览器)、编排逻辑(子代理生成、任务交接、模型路由),以及用于确定性执行的钩子和中间件(压缩、延续、代码检查)。
这样划分模型和框架的边界,最大的好处就是——它强迫你围绕模型智能本身来思考系统设计,而不是把两者混为一谈。
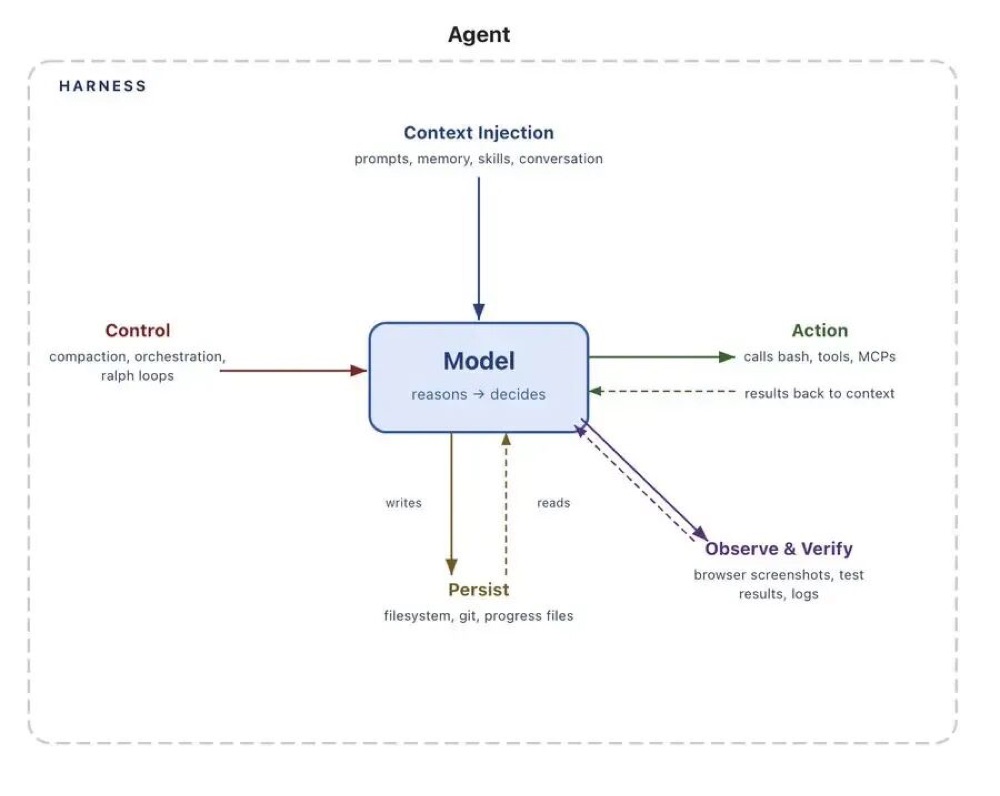
为什么需要框架?从模型的局限说起
模型本身其实很简单:输入文本、图像、音频、视频,输出文本。就这样。
开箱即用的模型做不到这些事:跨交互保持持久状态、执行代码、访问实时信息、自己配置环境装依赖包。这些全都是框架层面的能力。
举个最朴素的例子——大家天天用的"聊天"产品,本质上就是把模型包在一个 while 循环里,记录历史消息、追加新消息。这就是最基础的框架。核心思路就一条: 把期望的智能体行为,翻译成框架里的实际功能。
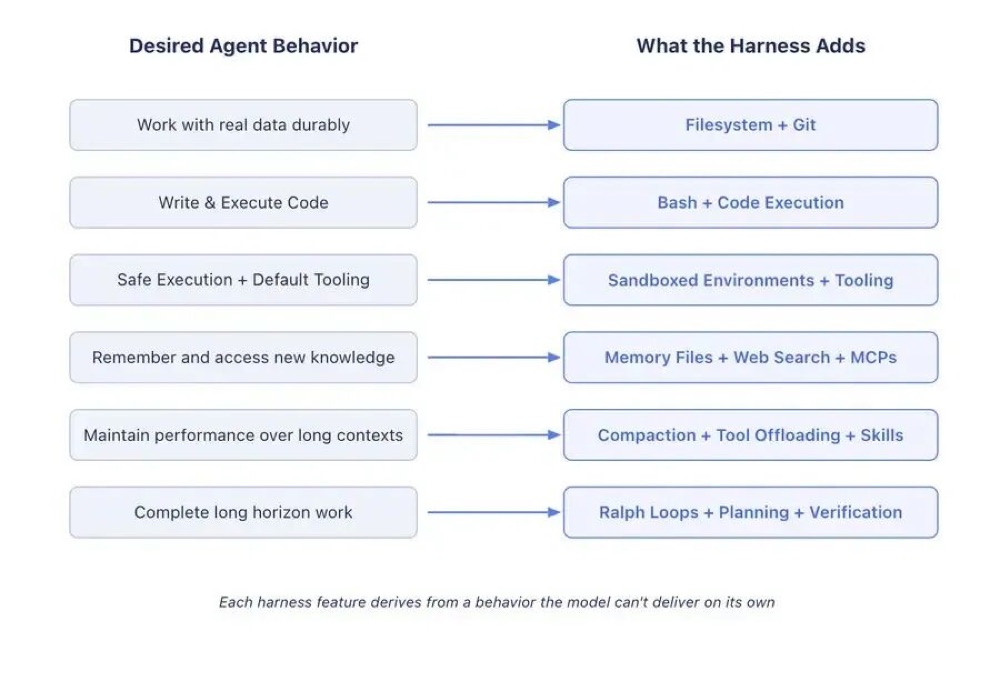
文件系统:框架最底层的基石
想要什么: 让智能体有持久存储,能跟真实数据打交道,能把放不进上下文的信息卸载出去,还能跨会话保存工作成果。
模型的知识边界就是它的上下文窗口,别的什么都没有。没有文件系统之前,用户得把内容手动复制粘贴进去,这对自主智能体来说根本行不通。
解法很自然: 框架附带文件系统抽象和文件操作工具。
文件系统可以说是最基础的框架原语,它解锁了几件关键的事:智能体有了工作区,能读数据、读代码、读文档;工作可以增量写入和卸载,不用把所有东西都塞进上下文;状态可以跨会话持久化;多个智能体和用户还能通过共享文件来协作——那些"智能体团队"架构就是靠这个跑起来的。
在文件系统上再叠一层 Git,就有了版本控制,智能体可以追踪工作进度、回滚错误、开分支做实验。文件系统不只是存储,它实际上是后面所有能力的地基。
Bash () + 代码执行:通用工具的正确打开方式
想要什么: 让智能体能自主解决问题,而不是每次都要用户预先设计好每一个工具。
当前智能体的主流执行模式是 ReAct 循环——推理、用工具执行、观察结果、循环往复。问题是,如果只给固定的工具集,智能体的能力上限就被死死卡住了。
与其让用户为每一个可能的操作都写工具,不如直接给智能体一个 Bash 工具,让它自己写代码解决问题。 框架附带 Bash 工具,模型通过编写和执行代码来自主应对各种情况。
这是让模型"拥有一台电脑"的关键一步。它不再被限制在预配置的工具集里,而是可以通过代码动态设计自己需要的工具。当然框架里还是会有其他工具,但代码执行已经成为自主解决问题的默认通用策略。
沙箱:给执行装上安全网
想要什么: 智能体需要一个有正确默认配置的环境,能安全执行操作、观察结果、推进任务。
已经有了存储和代码执行能力,但这一切得有个地方跑。在本地直接跑智能体生成的代码风险很大,而且单台本地机器根本撑不住大规模的智能体工作负载。
沙箱解决了这个问题——它为智能体提供了隔离的安全执行环境。框架连接到沙箱来运行代码、检查文件、安装依赖、完成任务,而不是在本地执行。沙箱还能按需创建、分发到多个任务、任务完成后销毁,天然支持横向扩展。
好的执行环境还需要好的默认工具:预装的语言运行时和常用包、Git 和测试用的 CLI、用于 Web 交互和验证的浏览器。有了浏览器、日志、截图、测试运行器这些工具,智能体就能形成自我验证的闭环——写代码、跑测试、看日志、修 bug,一条龙搞定。
智能体在哪里跑、有哪些工具、能访问哪些资源、怎么验证自己的工作——这些都是框架层面的设计决策,模型本身管不了这些。
记忆与搜索:让智能体不断"长知识"
想要什么: 智能体应该记得已经见过的东西,还能访问训练截止日之后出现的新信息。
模型除了权重和当前上下文,什么知识都没有。既然不能直接改模型权重,"加知识"的唯一方式就是往上下文里注入。
文件系统在这里依然是核心。框架支持类似 AGENTS.md 这样的记忆文件,在智能体启动时注入到上下文里。智能体更新这个文件,框架下次启动时就把最新版加载进来——这就是一种持续学习:把某个会话里学到的东西持久化,带进未来的会话。
至于知识截止的问题,网络搜索工具和 MCP 工具(比如 Context7)可以帮助智能体访问训练截止日之后的信息,比如新版本的库文档、最新的实时数据。 Web 搜索和查询最新上下文的工具,是值得直接集成进框架的基础能力。
对抗上下文衰减
想要什么: 智能体的表现不应该随着工作推进越来越差。
上下文衰减描述了一个真实存在的现象:随着上下文窗口被填满,模型的推理和任务完成能力会明显下滑。上下文是稀缺资源,框架必须有策略来管理它。
压缩机制 处理上下文窗口快满的情况。没有压缩,对话一旦超出上下文窗口,轻则 API 报错,重则任务直接崩掉。压缩机制会智能地卸载并汇总已有上下文,让智能体能继续工作。
工具调用卸载 解决大型工具输出污染上下文的问题。对于超过一定长度的工具输出,框架只在上下文里保留头尾部分,完整内容卸载到文件系统,需要时再取。
技能(Skills) 解决工具过载的问题。如果启动时把所有工具和 MCP 服务器都加载进来,上下文还没开始工作就已经被占满了。技能通过渐进式披露来解决这个问题——启动时只加载前端元数据,用到什么再展开什么。
长期自主执行:真正难啃的骨头
想要什么: 智能体能在较长的时间跨度内,自主、正确地完成复杂任务。
自主软件开发是智能体编程的终极目标,但现有模型有几个老毛病:过早停止、复杂问题分解困难、跨多个上下文窗口时表现不一致。一个好的框架必须正面应对这些挑战。
在长期任务里,前面提到的那些原语开始变得不够用。需要持久状态、规划、观察和验证机制,才能在多个上下文窗口里持续推进。
文件系统 + Git 用来跨会话追踪任务进度。长时间任务会消耗大量 token,文件系统把工作状态持久化下来,让新加入的智能体或者下一个上下文窗口能快速接手。对多个并行工作的智能体来说,文件系统还是共享账本。
Ralph 循环 用来保持持续工作。这是一种工具模式:通过钩子拦截模型的"退出"企图,在干净的新上下文窗口里重新注入原始目标,强迫智能体继续完成任务。每次迭代从新的上下文开始,但会读取前一次的状态——文件系统让这一切成为可能。
规划和自我验证 保证任务真正推进而不是在原地打转。框架通过提示和计划文件来支持规划,智能体把目标拆成步骤逐一推进。完成每个步骤后,框架里的钩子可以运行预定义的测试套件,失败时把错误信息反馈给模型;或者让模型自己做代码评估。验证把解决方案建立在测试基础上,同时提供自我改进的反馈信号。
模型训练和框架设计已经深度耦合
像 Claude Code 和 Codex 这样的智能体产品,模型和框架在训练后期就已经深度绑定在一起。这让模型在框架设计者认为关键的操作上持续提升——文件系统操作、bash 执行、任务规划、用子智能体并行化工作。
这形成了一个反馈循环:有用的框架原语被发现,加进框架,用来训练下一代模型,模型在这些框架里越来越强,然后继续发现新原语。
但这种协同演化有个副作用—— 泛化能力会变差 。改变工具逻辑可能直接导致模型性能下滑。Codex-5.3 的提示指南里就有个典型案例:换一种补丁应用方式,模型就跟不上了。一个真正通用的智能模型应该能轻松切换不同的补丁策略,但过度拟合训练时用的框架让它做不到。
更重要的是: 最适合你任务的框架,不一定是模型后训练时用的那个框架 。Terminal Bench 2.0 排行榜是个很好的例证——同样是 Opus 4.6,在 Claude Code 里的得分远低于其他框架里的表现。仅仅通过换框架,就能把编码智能体的排名从前 30 提到前 5。针对具体任务优化框架,潜力是真实存在的。
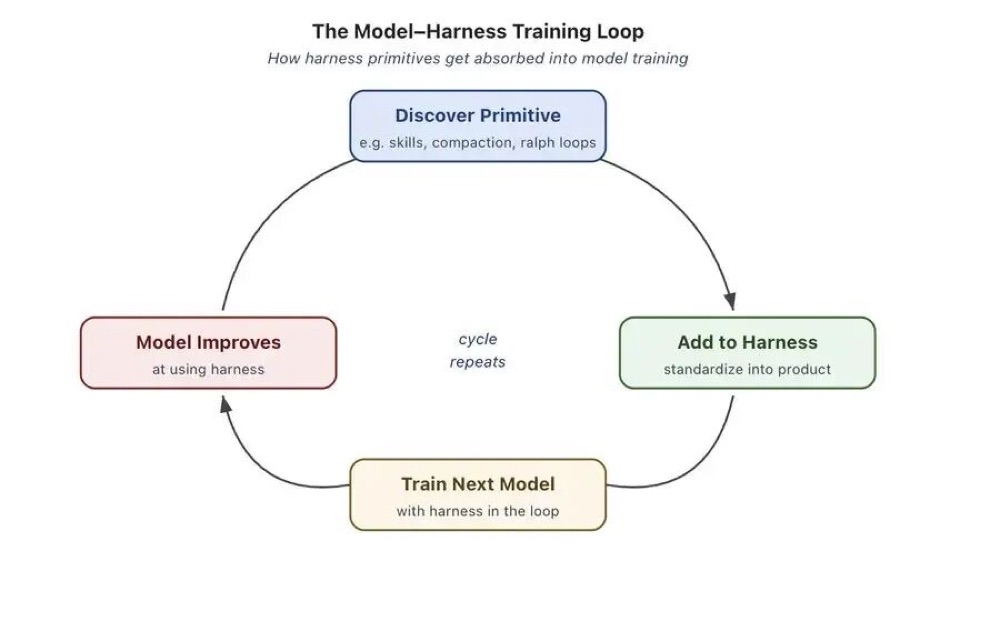
框架工程的未来走向
随着模型能力的提升,现在框架里做的一些事情会逐渐被模型自身吸收。规划、自我验证、长期一致性——这些都会变得越来越不依赖上下文注入。
这是否意味着框架会越来越不重要?不太可能。就像提示词工程在今天依然至关重要一样,框架工程大概率也会长期发挥作用。框架的价值不只是弥补模型的短板,它是围绕模型智能构建系统、让模型更高效发挥的那层"放大器"。一个配置良好的环境、合适的工具、持久状态和验证循环,无论底层模型有多强,都能让它跑得更稳、更快。
目前还有几个方向值得持续关注:如何协调数百个智能体在同一个代码库上并行工作;让智能体能够分析自身的运行轨迹,识别并修复框架层面的故障模式;以及框架能否根据具体任务动态组装合适的工具和上下文,而不是在启动时全部预配置好。
模型负责提供智能,框架负责把这种智能变成真正有用的东西。
Harness到底是什么?一篇给你讲透
一、为什么Harness突然火了
这个词在2025年末到2026年初明显升温。
Anthropic在2025年11月就已经公开讨论“long-running agents”的effective harnesses,核心问题是:agent 做长任务会跨多个上下文窗口,而每次新会话都像“一个新工程师接班”,没有之前发生过什么的记忆。
到2026年2月,Mitchell Hashimoto在自己的文章里直接把一个阶段命名为 “Engineer the Harness”;几天后,OpenAI又发布了 “Harness engineering”,把这个概念进一步推到台前。
也就是说,行业开始意识到:2025年大家比的是模型和prompt;2026年开始,真正拉开差距的是模型外面的系统设计。 这就是harness () 变热的根本原因。这个判断能从OpenAI 和Anthropic的工程文章里直接看出来。
总之,它是大佬们提出的概念,大家伙自然会追捧,然后大佬说的好像还是蛮有道理的,关键是觉得它“牛逼”,所以它就火了!
二、Harness到底是什么
一个更工程化的定义是:
Harness = 围绕LLM/agent的执行与治理层。
Salesforce的定义很直白:agent harness是一层operational software layer,负责管理AI的 tools、memory、safety,从而让autonomous task execution更可靠。
OpenAI的表述更偏工程实现:
在Codex体系里,harness包含core agent loop + execution logic + client/runtime integration;它不是单次对话,而是一个能驱动工具调用、状态流转、事件流、客户端交互的长期运行系统。
所以,harness不是一个具体模型,也不是一句prompt,更不是某个单独框架。
它更像这几个东西的合体:
agent runtime
tool orchestrator
memory/state manager
permission/safety wrapper
failure recovery system
human approval/workflow layer
这些拼在一起,才叫harness。
三、和prompt、workflow、agent、framework的关系
最容易混淆的是这四个:
它不是prompt
Prompt只是给模型的文字说明。
Harness则负责:什么时候给什么prompt、何时压缩上下文、何时调用工具、失败后怎么恢复、哪些动作需要审批。
它不等于agent
Aent 通常指“会规划、会调用工具、会迭代执行”的智能体行为。
Harness则是agent背后的基础设施。OpenAI把agent loop视为harness的核心逻辑之一,但完整harness还包括更多supporting features和runtime结构。
它不等于framework
框架更像“开发工具箱”;
Harness 更像“真正跑在线上的运行环境”。
Salesforce 明确区分了:framework提供构建agent的库,而harness是现实世界里约束、管理和运行agent的实际runtime system。
它也不只是workflow
Workflow 是流程;
Harness不仅管流程,还管 状态、记忆、权限、恢复、验证、日志、审批、客户端协议。
四、一个harness里通常包含什么
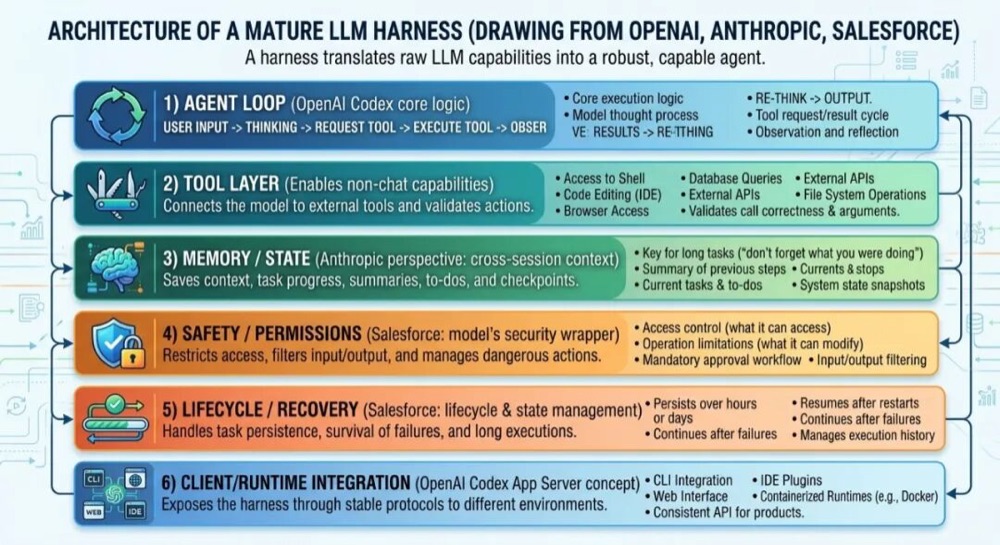
结合OpenAI、Anthropic、Salesforce的公开工程文章,一个成熟harness 大致会有这几层:
Agent loop
就是“用户输入 → 模型思考 → 请求工具 → 执行工具 → 观察结果 → 再思考 → 输出”的循环。OpenAI把这称作Codex的核心逻辑。
Tool layer
给模型接上shell、代码编辑、浏览器、数据库、API、文件系统等能力,并校验工具调用是否合法、参数是否正确。没有这层,模型只能聊天。
Memory / state
保存中间状态、任务进度、摘要、待办、检查点。这是解决长任务“做着做着就忘了”的关键。Anthropic讲得很清楚:跨context window工作的agent必须弥补“新会话没有前情记忆”的问题。
Safety / permissions
限制模型能访问什么、能改什么、什么动作必须审批、怎么过滤输入输出。Salesforce直接把harness描述成model的security wrapper。
Lifecycle / recovery
任务崩了能不能续跑,重启后能不能接着干,长任务能不能跨小时甚至跨天继续。Salesforce把这叫lifecycle and state management。
Client/runtime integration
尤其在产品化场景里,harness还要对接CLI () 、IDE、Web、后台容器。OpenAI的Codex App Server就是在做这件事:把harness以稳定协议暴露给不同客户端。
五、Harness Engineering又是什么
既然harness是那层运行系统,Harness Engineering 就是专门设计和迭代这层系统的工程实践。
OpenAI在2026年2月把它明确写成主题,核心思想不是“怎么把prompt写得更花”,而是:
怎么让仓库对agen 更可读
怎么把知识沉淀到repo里
怎么通过反馈回路让agent持续纠错
怎么控制“熵增”和系统漂移
怎么让humans steer, agents execute
所以你可以把Harness Engineering 理解成:从“提示工程”升级到“智能体运行系统工程”。
Harness Engineering和过去的“Prompt Engineering () / Context Engineering”有什么区别呢?
Prompt engineering:教模型这一轮怎么答
Context engineering:给模型这一轮喂什么上下文
Harness engineering:设计整个系统,让模型在很多轮、很多工具、很长时间里都能稳定完成任务
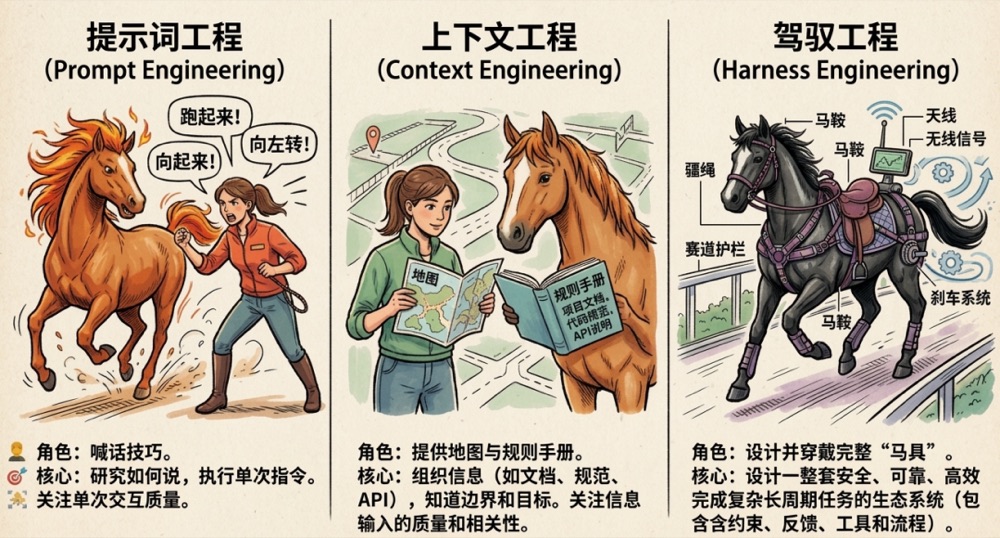
也就是说,harness关心的是连续执行能力,而不只是单轮输出质量。这个区别在OpenAI对agent loop/app server的描述,以及Anthropic对long-running agents的描述里都提到了。
最后再总结一下: Harness不是新模型,也不是新框架,而是“大模型外面的那层执行与治理系统”。它负责把会推理的LLM变成能长期、稳定、安全完成任务的agent。
模型不是关键,Harness 才是
同一个模型,换一套运行环境,编程基准的成功率就从 42% 跳到了 78%。
这个数据来自 Nate B Jones 的一项研究,只有一个变量:模型外面包裹的那层「壳」。模型没换,数据没换,提示词也没换,只是改了壳,性能翻了将近一倍。
这层壳,现在有了一个正式的名字: Harness 。
而围绕它展开的工程实践,叫 Harness Engineering ,是 2026 年 AI 工程圈话题之一。
三层进化
要理解 Harness Engineering,得先看它是怎么一步步「长」出来的。
其核心思路是,单条 prompt 不够用了,你得为模型动态构建整个上下文环境,包括相关文件、历史对话、工具定义、知识库检索结果……让模型在做每一个决策时,都能看到要看到的信息。
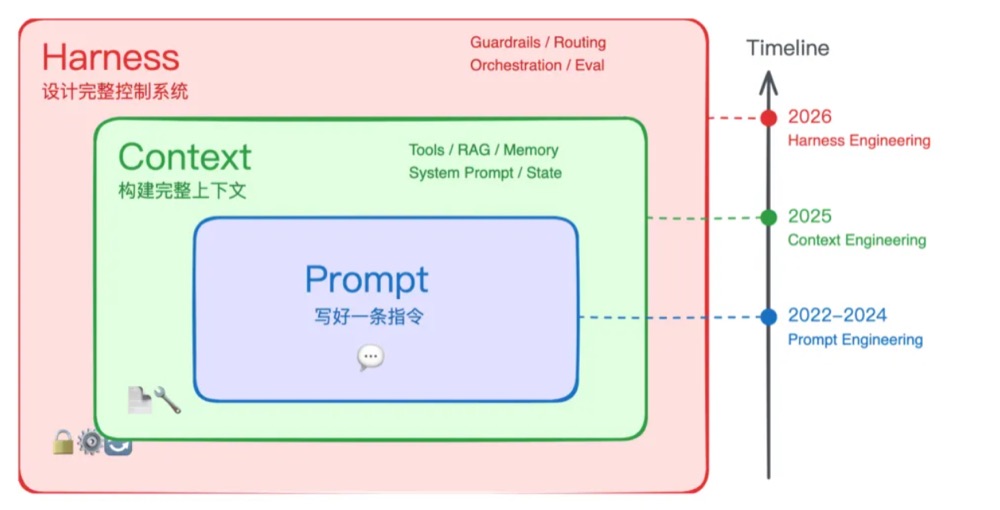
然后到了 2026 年 2 月, Harness Engineering 来了。
它和前两个词的关系,打个比方:Prompt Engineering 是教你怎么写一封好邮件;Context Engineering 是教你怎么把相关附件都带上;而 Harness Engineering,是教你怎么搭建整个办公室,让员工(Agent)能持续、稳定、高质量地工作。
它包含了 Context Engineering,但在更高的层面运作:
约束、反馈循环、架构规则、工具链、生命周期管理,以及对抗熵增的持续治理。
阶段
时间
核心关注
Prompt Engineering
2022-2024
精心构造单次指令
Context Engineering
2025
为每个决策点动态构建上下文
Harness Engineering
2026 年 2 月起
设计完整的控制系统
第五阶段
故事得从 Mitchell Hashimoto 说起。
这位 HashiCorp 的联合创始人、Terraform 的缔造者,今年 2 月 5 日写了篇博客,记录自己用 AI 编程的「进化史」。他把采纳之旅分成了六个阶段,从最初用 chatbot 聊天写代码,到后来全天候跑 Agent。
第一阶段叫「Drop the Chatbot」,别用聊天界面了。第二阶段叫「Reproduce Your Own Work」,强迫自己用 Agent 重新做一遍手动完成的工作,哪怕做两遍也要做。第三阶段开始利用下班时间跑 Agent,第二天早上来收获「warm start」。第四阶段,把简单任务交给后台 Agent,自己专注深度工作。
而 第五个阶段 ,他给了一个名字: Engineer the Harness 。
他的定义只有一句话:
每当你发现 Agent 犯了一个错误,你就花时间去工程化一个解决方案,让它再也不会犯同样的错。
这句话看起来平平无奇,但它击中了一个很多人隐隐感觉到、却没有说清楚的痛点: 模型能力够了,可它就是不听话。
他在 Ghostty 项目中实践了这个理念。AGENTS.md 文件里的每一行规则,背后都对应着 Agent 曾经犯过的一个错。他说:
那个文件里的每一行都基于一次 Agent 的不良行为,而且几乎完全解决了这些问题。
几天之后,OpenAI 发了一篇重磅博文。再几天,Martin Fowler 团队的 Birgitta Böckeler 跟进分析。
这个词,在几周内就火遍了整个 AI 工程圈。
百万行代码,零行手写
OpenAI 的 Codex 团队做了一件事,让整个行业重新思考「工程师」这个词的含义。
从一个空的 git 仓库开始,5 个月,大约 100 万行代码,1500 个 PR,全部由 Agent 生成。
人类一行代码都没写。
团队一开始只有 3 个工程师,后来扩到 7 个。他们用 GPT-5 驱动的 Codex CLI,从零开始构建了一个完整的生产级应用。平均下来,每位工程师每天合并 3.5 个 PR。
他们估算,如果用传统方式手写,这个项目的工期应该是现在的 10 倍 。
而这里面最让人意外的一点是:这 100 万行代码里,不只是业务逻辑。测试、CI 配置、文档、可观测性、内部开发者工具,全都是 Agent 写的。
Ryan Lopopolo,这个项目的核心工程师,写下的一句话是:
Agent 不难,Harness 才难。
这句话,可以说是本次实践的重点。
因为 OpenAI 这篇博文真正的价值,在于他们把 5 个月的实战经验提炼成了一套可复制的方法论。
仓库就是大脑
他们的第一个核心理念是: 仓库是 Agent 唯一的知识来源。
代码、markdown、schema、可执行计划,全都版本化地存在仓库里。没有外部 wiki,没有 Notion 文档,没有「口口相传」的潜规则。Agent 看不到仓库之外的东西,所以仓库必须包含 Agent 工作所需的一切。
这倒是跟传统软件工程的「文档即代码」理念一脉相承。只不过以前是为了让人类开发者少踩坑,现在是为了让 Agent 少犯错。
而且随着项目推进,他们发现需要把越来越多的「隐性知识」显性化,推入仓库。以前靠老员工口头传授的东西,现在必须写成文档,因为 Agent 不会来问你、也不会去茶水间聊天。
给 Agent 写的代码
第二个理念则跟传统认知完全相反: 代码不仅要对人类可读,更要对 Agent 可读。
传统的代码可读性,讲的是命名规范、注释、模块化,让下一个接手的程序员能看懂。但 OpenAI 团队发现,Agent 理解代码的方式跟人类不一样。
它们更依赖结构化的线索:严格的分层架构、一致的命名模式、显式的类型定义。那些对人类来说「一看就懂」的隐含约定,对 Agent 来说可能是致命盲区。
所以他们在架构设计上做了大量工作,确保代码结构本身就能引导 Agent 做出正确的决策。这是一种新的可读性标准: application legibility ,应用的可读性。
自主性分级
第三个理念是渐进式的自主性提升。
他们没有一上来就让 Agent 全权负责所有事情。而是从简单任务开始,逐步提升 Agent 的自主权限。随着 Harness 越来越成熟,Agent 获得的自由度也越来越大。
到了后期,单个 Codex 任务可以 连续运行 6 个小时以上 ,自主完成复杂的功能开发。
这也呼应了一个规律: 自主性的提升,必须建立在约束系统成熟的基础上。 你不会让一个实习生第一天就独立负责核心模块。
合并哲学
他们的 PR 合并策略也值得一说。
每个 Codex 任务产出的 PR,在合并前会经过 linter、结构化测试和自动化检查。工程师做的是「审查」,不再是「修改」。
如果一个 PR 需要大量修改才能合并,他们会反思:Harness 哪里出了问题,为什么 Agent 会产出这样的代码?
然后把修复方案反哺回 Harness,让这类问题下次不再出现。
团队增长反而提升了吞吐量 ,这个结论也有些违反直觉的。
传统团队加人往往有「布鲁克斯法则」的问题(加人反而更慢),但在 Agent 驱动的模式下,每个工程师都是独立的「Harness 调参师」,互相之间的协调成本很低。
他们的工程师角色发生了根本性的变化。OpenAI 团队自己描述:
我们现在最大的挑战,在于设计环境、反馈循环和控制系统。
换句话说,他们不写代码了,写的是规则。
像操作系统
那么……Harness 到底是个什么东西呢?
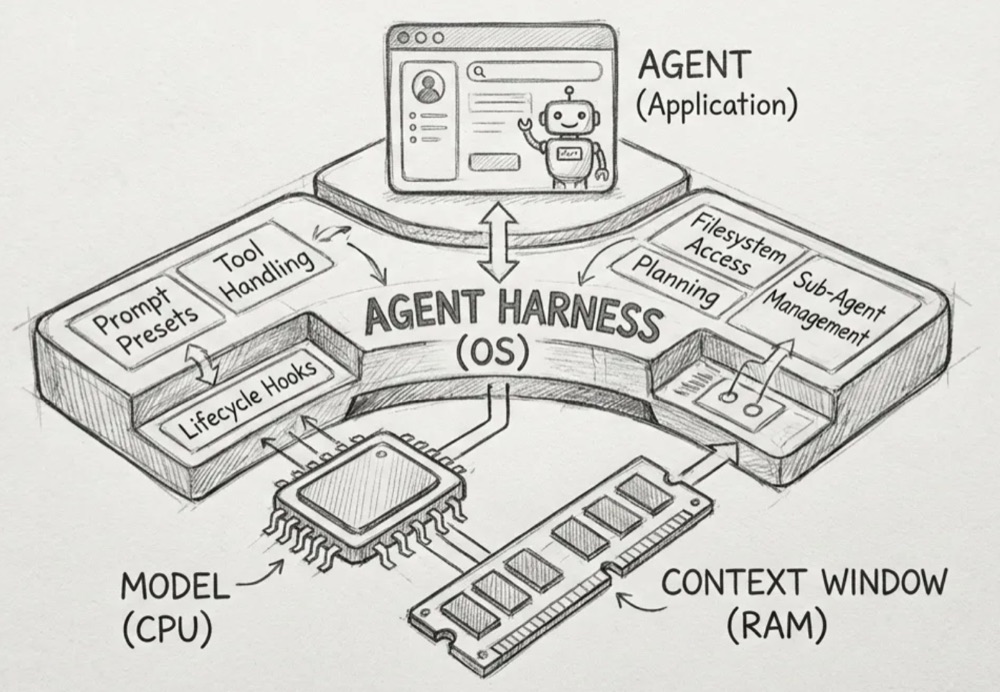
Philipp Schmid 给了一个特别好懂的类比:
计算机组件
Agent 对应物
角色
CPU
模型
原始算力
内存
上下文窗口
有限的、易失的工作记忆
操作系统
Agent Harness
管理上下文、处理启动流程、提供标准驱动
应用程序
Agent
跑在操作系统上的用户逻辑
模型就是 CPU,算力再强,没有操作系统也跑不起来。
而 Harness,就是给 AI Agent 套上的那层操作系统。
它包括上下文管理(怎么把信息喂给 Agent)、架构约束(什么能做什么不能做)、反馈循环(怎么让 Agent 知道自己做对了没)、工具链(Agent 能用哪些工具),以及整个生命周期的管理。
这个类比其实揭示了一件事:过去两年,我们一直在升级 CPU,更大的模型、更长的上下文、更强的推理能力。
但操作系统呢?还停留在 DOS 时代。
大多数人用 AI Agent 的方式,还是「打开终端,输入命令,看结果」。没有文件系统的概念,没有进程管理,没有标准驱动,没有权限控制。
难怪它不好用。
arxiv 上的一篇论文,Building Effective AI Coding Agents for the Terminal: Scaffolding, Harness, Context Engineering, and Lessons Learned,(2603.05344)给出了一个更精确的技术定义,把 Agent 的运行架构分成了三层:
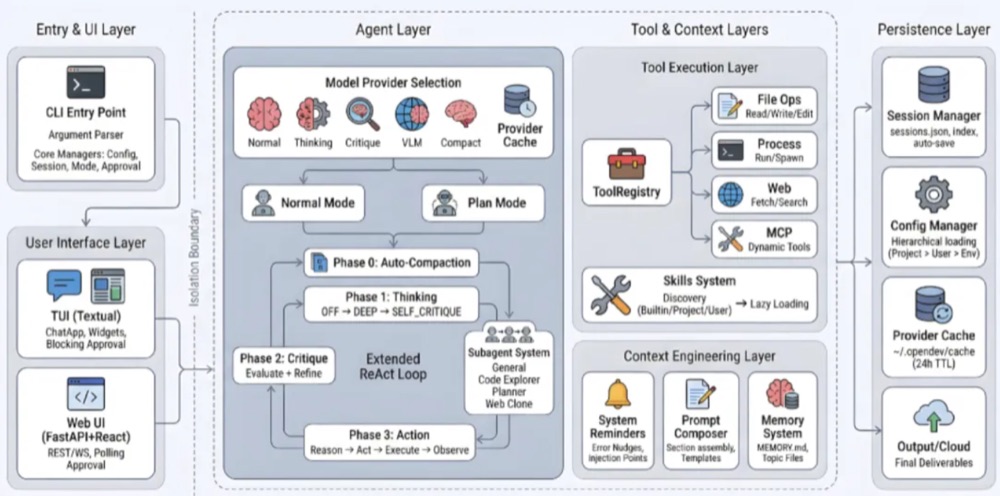
Scaffolding (脚手架):预执行阶段的组装,包括系统 prompt 编译、工具 schema 构建、sub-agent 注册表填充。相当于操作系统的 BIOS 和引导程序。
Harness (运行时编排):核心推理循环的包装层,协调工具执行、上下文管理、安全执行和会话持久化。相当于操作系统的内核。
Context Engineering (上下文工程):Token 预算管理,决定什么信息该进来、什么该压缩、什么该丢弃。相当于操作系统的内存管理。
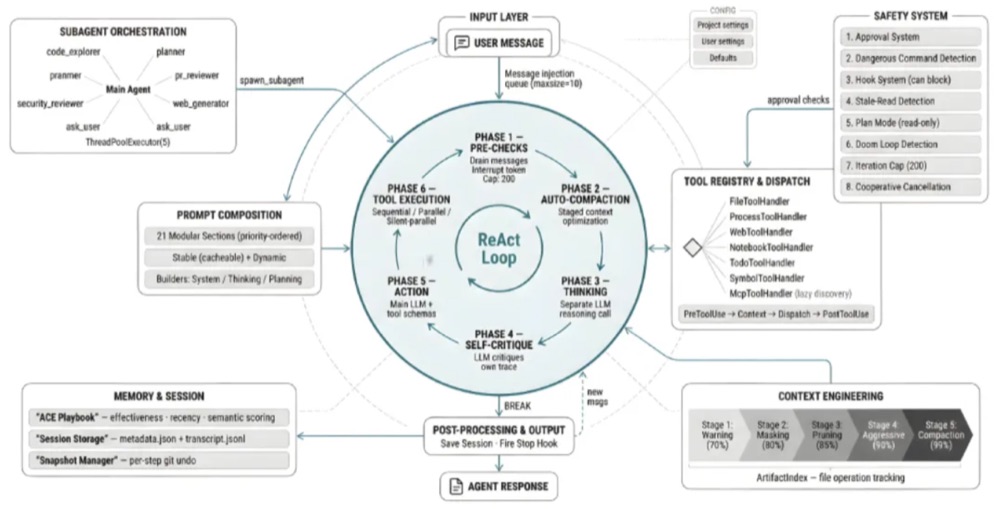
用一个公式来表示: coding agent = AI model(s) + harness
三根支柱
OpenAI 团队把他们的 Harness 拆成了三个部分。
上下文工程
也就是怎么把正确的信息喂给 Agent。
他们在仓库根目录放了 AGENTS.md 文件,Agent 每次启动都会自动读取。但这个文件更像「目录」,大概只有 100 行左右,告诉 Agent 到哪里去找更详细的信息。
这是个值得注意的设计选择。ETH Zurich 的一项研究发现,CLAUDE.md / AGENTS.md 文件应该控制在 60 行以内。过长的指令文件反而会降低 Agent 的表现。
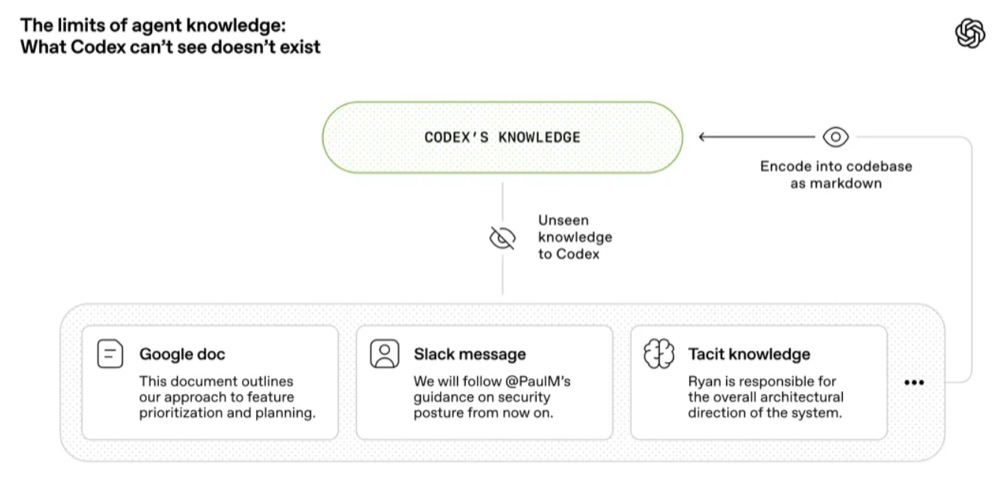
但上下文工程远不只是一个 markdown 文件。
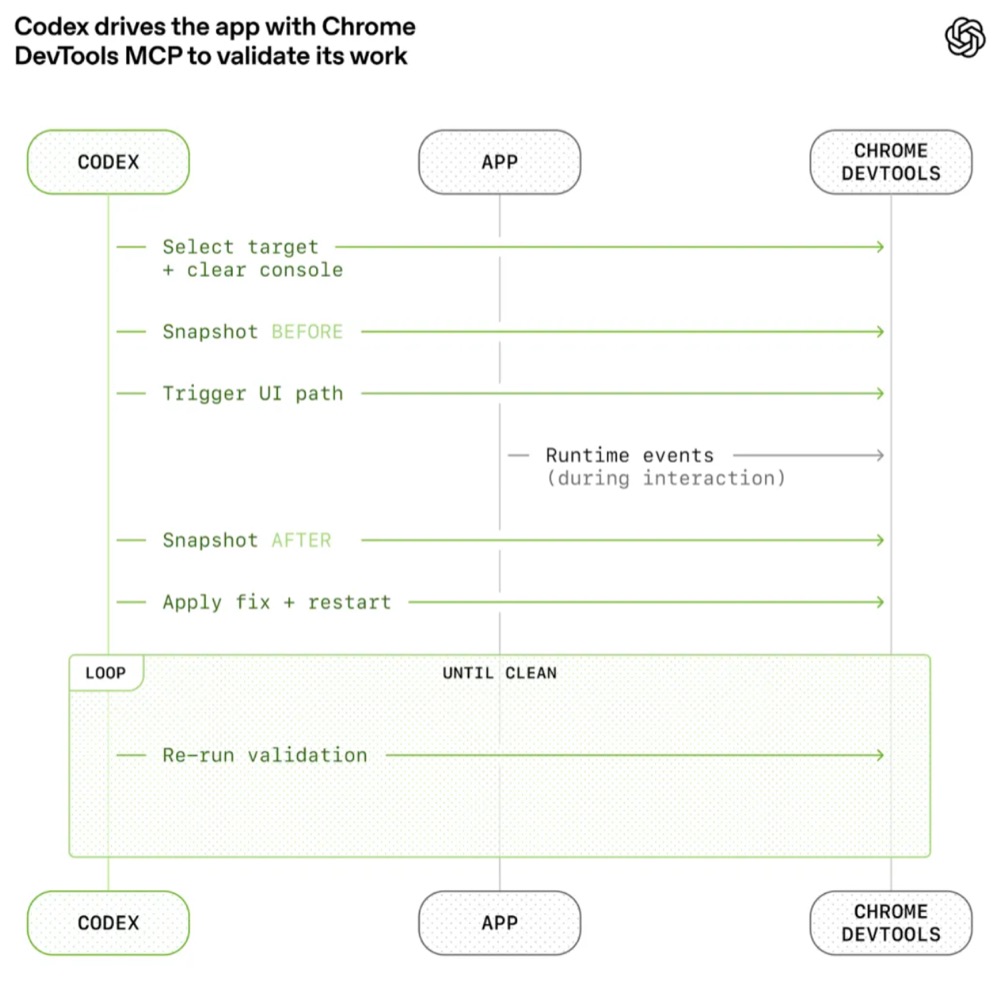
他们还给 Agent 接了 浏览器 (通过 Chrome DevTools Protocol),让它能看到 UI 渲染结果,自己判断页面做得对不对。
接了完整的 可观测性栈 (基于 Vector、Victoria Logs/Metrics/Traces),而且是每个 worktree 都有一套本地的日志、指标和链路追踪。Agent 可以自己查报错,自己看性能数据,自己定位问题在哪一层。
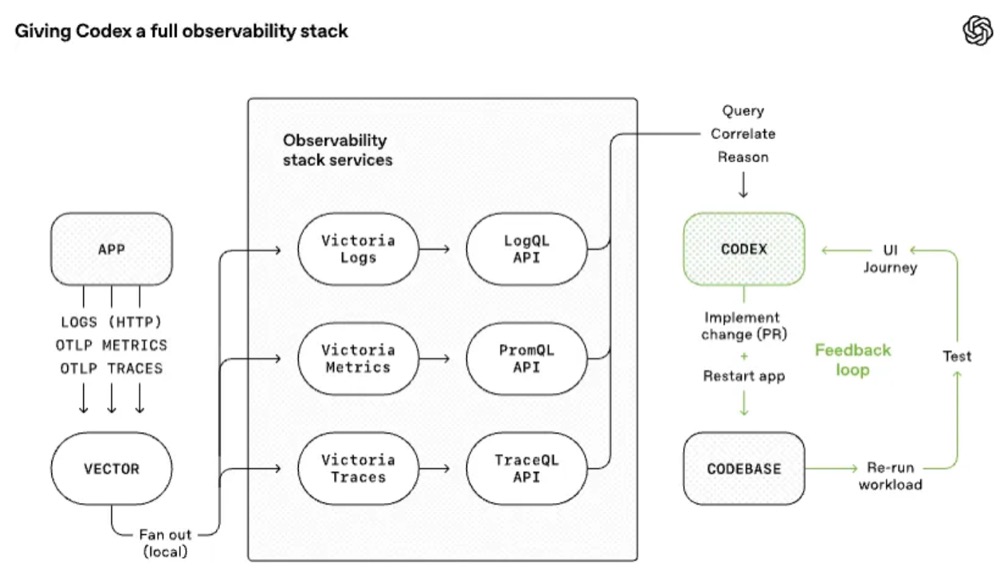
这就好比,你不仅给新员工发了入职手册,还给了他所有系统的监控大屏的权限。大多数公司连人类工程师都没配这么齐全的可观测性,OpenAI 倒先给 Agent 配齐了。
架构约束
这才是 Harness 最核心的一环。
他们设计了严格的分层架构:Types → Config → Repo → Service → Runtime → UI,每一层只能依赖下面的层。
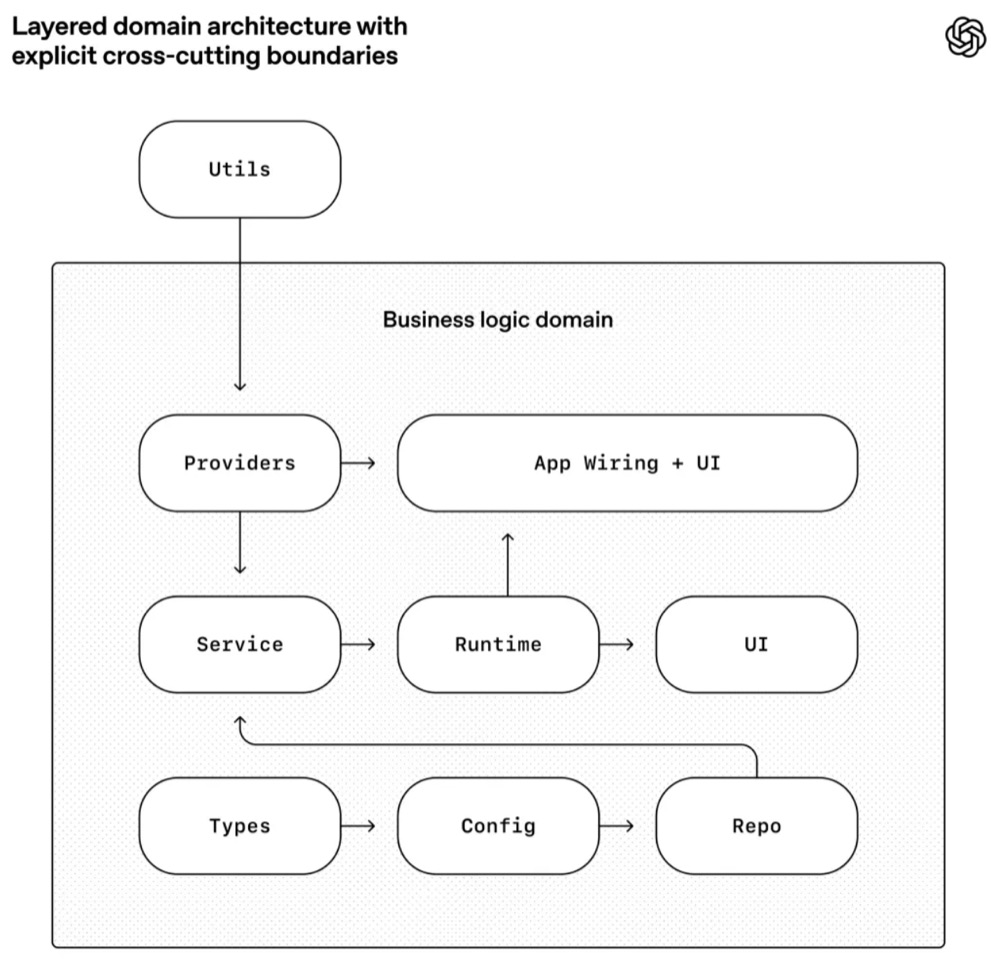
这些规则没有靠 prompt 告诉 Agent「请遵守」,用的是 确定性的 linter 和结构化测试 来机械执行。Agent 违反了架构规则?CI 直接挂掉,没得商量。
而且 linter 的报错信息里,还嵌入了修复指引,告诉 Agent 应该怎么改。这一招,相当于把「老师傅的经验」写进了编译器。
Cursor 团队在他们的「Self-Driving Codebases」研究中,也得出了类似的结论:
约束比指令更有效。告诉 Agent「不要留 TODO」比告诉它「完成所有实现」效果更好。
这背后有一个反直觉的洞察: 约束解空间反而让 Agent 更有生产力。 当 Agent 可以生成任何东西时,它会浪费 token 探索死胡同。当 Harness 定义了清晰的边界,Agent 反而更快收敛到正确答案。
熵管理
他们管这个叫「垃圾回收」。
AI 生成的代码写多了,文档会过时,架构会漂移,风格会走样。所以他们定期启动专门的 Agent,去扫描文档不一致、架构违规等问题,提交修复 PR。这些 PR 大多能在一分钟内审查并合并。
就像你家如果不定期打扫,再好的装修也会变成垃圾场。
OpenAI 团队把这种心态总结成了一句话:
当 Agent 遇到困难时,我们把它当作一个信号:找出缺了什么,是工具、是护栏、还是文档,然后把解决方案反哺回仓库。
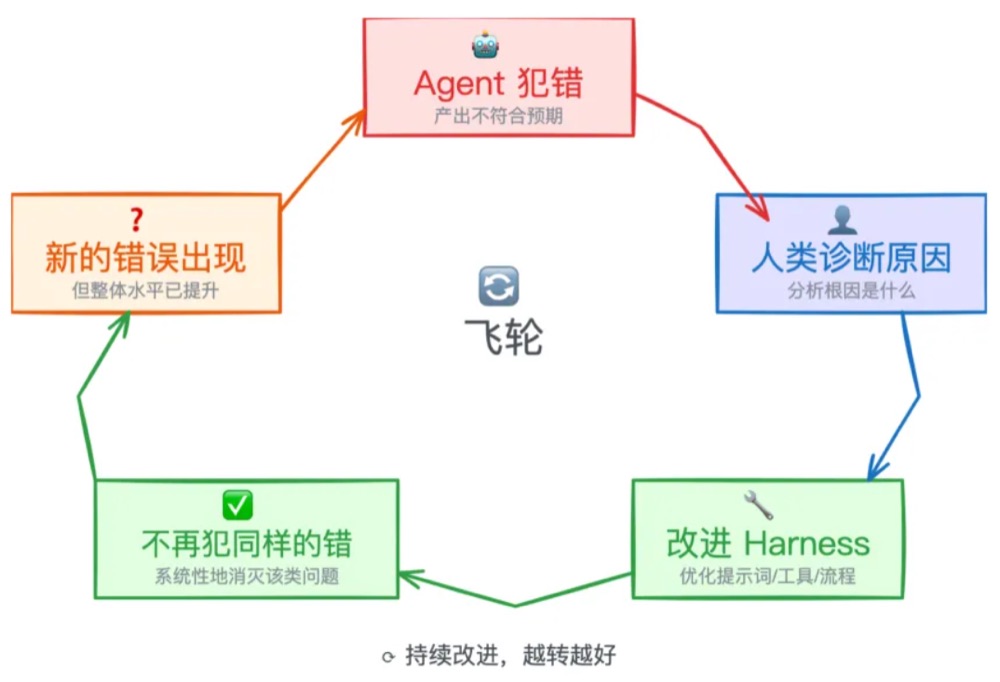
这其实构成了一个持续改进的飞轮:
Agent 犯错 → 人类诊断原因 → 改进 Harness → Agent 下次不再犯同样的错 → 新的错误出现 → 循环继续。
行业共识
如果只有 OpenAI 一家在做,Harness Engineering 可能只是个噱头。但事实上,多家公司几乎同时走向了同一个方向。
Stripe:每周 1300 个 PR
Stripe 内部的「Minions」系统,可能是目前规模最大的 Agent 编程实践。
每周合并 1300 多个 PR,全部由无人值守的 Agent 完成。 这些 Agent 没有人在旁边盯着,也没有人在引导。
它的架构有个值得细看的设计: Blueprint 编排系统 ,把工作流拆成确定性节点和 Agentic 节点的混合体。
确定性节点(比如「运行 linter」「推送更改」)按固定路径执行,不调用 LLM。Agentic 节点(比如「实现这个功能」「修复 CI 失败」)才让 LLM 行使判断。
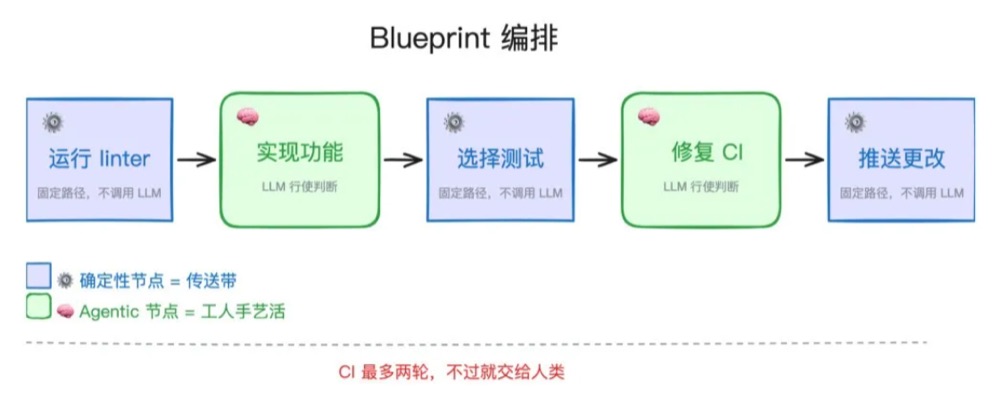
这就像一条生产线:传送带是确定性的,工人的手艺活是 Agentic 的。你不会让工人自己决定传送带往哪走。
Stripe 还有一个硬性限制: CI 最多跑两轮 。第一轮 CI 失败了,Agent 自动修复,再跑一次。如果还失败,直接转交人类。不允许 Agent 在 CI 上无限重试。
它们的内部工具平台「Toolshed」挂载了大约 500 个 MCP 工具,但给每个 Agent 的只是精心筛选过的子集。因为他们发现了一个关键规律: 更多的工具并不等于更好的表现。
Stripe 工程团队的总结:
成功取决于可靠的开发者环境、测试基础设施和反馈循环,跟模型选择关系不大。如果对人类友好,对 LLM 也一样友好。
Cursor:每小时 1000 个 commit
Cursor 的「Self-Driving Codebases」研究走得更远。
他们搭建了一个多 Agent 系统,能实现约 每小时 1000 个 commit ,一周内超过 1000 万次工具调用 。启动后无需任何人工干预。
但值得注意的是,他们走过的弯路恰恰说明了 Harness 设计的难度:
第一版,单 Agent,复杂任务扛不住。第二版,多 Agent 共享状态文件,结果锁竞争严重,Agent 之间互相打架。第三版,结构化角色分工(Planner → Executor → Workers → Judge),太僵硬了。第四版,持续执行器,角色过载导致各种诡异行为。
最终版本是递归 Planner-Worker 模型 :一个根级 Planner 拥有全局视野,生成子 Planner 处理细分任务,Worker 在仓库副本上独立操作。
他们还发现了一个有点黑色幽默的现象:差的初始指令会在数百个 Agent 间被放大。一条模糊的指令,一个 Agent 犯的错,乘以几百个并发 Agent……结果可想而知。
Peter Steinberger:一个人的军队
Peter Steinberger 的故事可能更能说明 Harness Engineering 在个人开发者层面的威力。
这位前 iOS 圈的知名开发者,靠着 Agent 驱动的工作流,2026 年 1 月单月产出了 6600 多个 commit 。他同时运行 5 到 10 个 Agent,OpenClaw 项目在 4 个月内拿到了 18 万 stars,成了 GitHub 上增长最快的仓库。
他的做法相当激进: 他不逐行审查 Agent 生成的代码。
在他看来,代码审查应该变成「prompt review」。他更关心的是生成代码的那个提示词写得好不好,代码本身长什么样倒在其后了。
他花大量时间跟 Agent 做前期规划,挑战和完善方案,然后一键执行,转身去做下一件事。
他还发现了一个反常识的现象:
喜欢算法谜题的工程师反而很难适应 Agent 工作流,而产品导向的工程师适应得更快。
今年 2 月,他加入了 OpenAI。这件事本身,大概也算是对 Harness Engineering 价值的一种认可吧。
壳比模型值钱
前面说了不少案例,这里把关键数据集中拉出来对比一下。
Nate B Jones 的研究 :同一个模型,编程基准成功率从 42% 到 78%,差了将近一倍,变量只有 Harness。换句话说, Harness 带来的提升,相当于换了一代模型。
LangChain 的案例 :用同一个模型(gpt-5.2-codex),只改 Harness,Terminal Bench 2.0 的成绩从 52.8% 升到 66.5%。排名呢?从三十名开外直接冲进前五。
Pi Research 的发现 更是直接:他们在一个下午内,仅通过修改 Harness,就提升了 15 个不同 LLM 的编程能力。标题就叫《Improving 15 LLMs at Coding in One Afternoon. Only the Harness Changed》。
Vercel 的经验 :把 Agent 的工具从 15 个砍到只剩 2 个,准确率反而从 80% 升到了 100%。
工具越少,怎么反而越准呢?这听起来有点反直觉。但道理其实不复杂,就像你给一个实习生 15 把不同的螺丝刀让他修电脑,他可能会手忙脚乱;给他一把十字和一把一字,他反而知道该怎么干了。
Terminal Bench 2.0 排行榜上也有个值得注意的现象 :Claude Opus 4.6 在 Claude Code Harness 上排名第 33,但换一个不同的 Harness 就冲到了第 5。同一个模型,同一个基准,排名差了 28 位。
这说明模型可能对特定的 Harness 存在过拟合。 在 A 环境下如鱼得水的模型,换到 B 环境可能就水土不服了。
Aaron Levie(Box CEO)感叹:
Agent Harness 目前的乘数效应太疯狂了。行业在架构上已经有了一些共识,但在具体怎么做上,还有太多不同的打法。
拐杖论
当然了,Harness Engineering 也不是没有人唱反调。而且反对者的来头都不小。
OpenAI 的 Noam Brown 在 Latent Space 的一次访谈中直接表态:
Harness 就像一根拐杖,我们终将能够超越它。
他的论据也有历史支撑。在推理模型(reasoning models)出现之前,开发者们在 GPT-4o 上搭建了大量复杂的 Agentic 系统来模拟推理能力。路由器、编排器、multi-agent 协作……一整套基础设施。
然后呢?推理模型一出来,这些基础设施一夜之间就不需要了。
之前投入了大量工程来构建这些 Agentic 系统……结果我们造了推理模型之后,你根本不需要那些复杂的行为了。事实上,在很多时候,这些东西反而让效果更差了。
他的预判是,OpenAI 将走向一个 统一模型 的未来:
我们公开说过,我们想要走向一个单一统一模型的世界。你不应该需要在模型上面再加一个路由器。
他给开发者的建议,只有一句话:
别花六个月搭建一个可能六个月后就被淘汰的东西。
METR(一个专注 AI 安全评估的研究组织)的数据也给了 Harness 阵营一记闷棍。
他们找了 scikit-learn、Sphinx、pytest 三个知名开源项目的 4 位活跃维护者,让他们审查 296 个 AI 生成的 PR。结果发现: 维护者的合并率,大约只有自动化评分通过率的一半。
以 Claude Sonnet 4.5 为例,自动评分器给出的成绩对应大约 50 分钟的任务范围,但维护者实际愿意合并的 PR 对应的任务范围只有 8 分钟左右。 这代表了 7 倍的能力高估。
而在他们的测试中,Claude Code 和 Codex 并没有比一个基础脚手架表现更好。Harness 的选择,基本落在误差范围内。
Scale AI 的 SWE-Atlas 基准测试也指向了类似的结论。
Latent Space 给 Noam Brown 这一派的观点起了个名字,叫「Bitter Lesson 阵营」。出自 Rich Sutton 那篇著名的 AI 随笔: 别在工程花活上下太多功夫,算力的增长终究会碾平一切。
你那些花里胡哨的 AI 脚手架,终将被规模冲走。
路线之争
Latent Space 在 3 月初做了一期专题分析,标题就是《Is Harness Engineering Real?》,把整个行业分成了两大阵营。
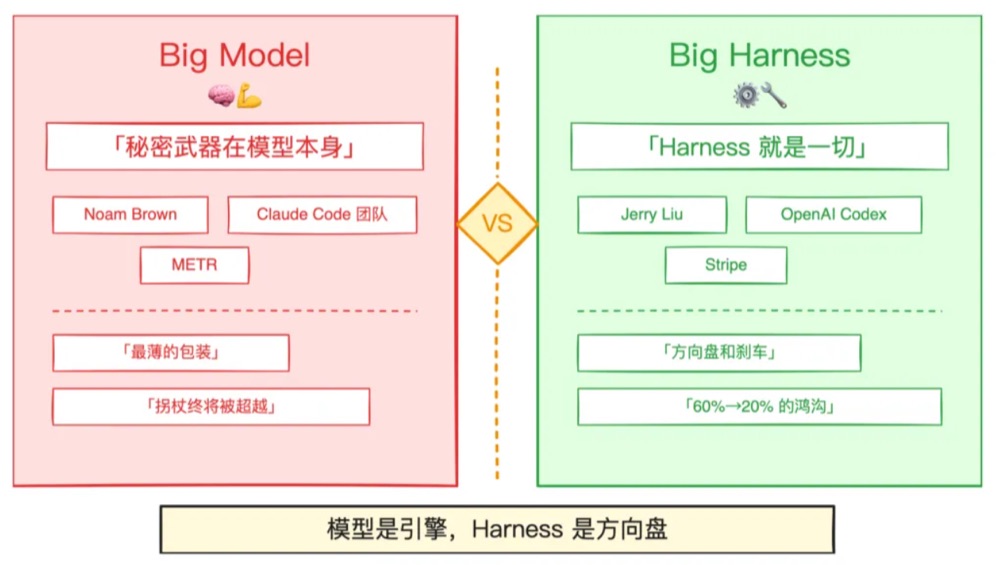
Big Model 阵营
核心观点 :模型能力的增长才是主旋律,Harness 只是权宜之计。
Claude Code 团队的 Boris Cherny 和 Cat Wu 在受访时表示:
所有的秘密武器都在模型本身。我们追求的是最薄的那层包装。
他们强调的是持续简化,别往上堆复杂性。Claude Code 本身就是这个理念的产物,它的 Harness 层尽可能地薄,把更多的事情交给模型自己判断。
Big Harness 阵营
核心观点 :模型是引擎,Harness 是方向盘和刹车。引擎再强,没有方向盘你也到不了目的地。
Jerry Liu(LlamaIndex 创始人)的话代表了这一派的立场:
Model Harness 就是一切。从 AI 那里获取价值的最大障碍,是你自己为模型做上下文工程和工作流工程的能力。
支撑这个观点的数据也不少。调研显示,开发者在 60% 的工作中使用 AI,但 真正完全委托给 AI 的任务只有 0 到 20% 。这中间的巨大鸿沟,在 Harness 阵营看来,问题出在 Harness 上,跟模型本身关系不大。
Cursor 的 $50B 估值(应该算是 Harness 公司的代表了),某种程度上也在印证这个方向的价值。
那……到底谁对呢?
护栏悖论
我觉得两边都对了一半,但都忽略了一个更深层的东西。
Philipp Schmid 观察到一个现象: Harness 本身也在不断被简化。
Manus 在 6 个月内重构了 5 次 Harness。LangChain 一年内重新架构了 3 次研究型 Agent。Vercel 砍掉了 80% 的 Agent 工具。
这说明 Harness 并非一劳永逸的。它需要跟着模型能力一起演化。模型变强了,Harness 就该变薄。
但「变薄」和「消失」是两回事。
Böckeler 在 Martin Fowler 网站上的分析提出了一个关键洞察: Harness 真正的价值,其实在于约束解空间。
她认为,要大规模维护 AI 生成的代码,关键在于通过特定的架构模式、强制的边界、标准化的结构,把解空间收窄到一个可控的范围内。
这就是我想说的「护栏悖论」:
车速越快,护栏越重要。
公路上,时速 30 公里的自行车道可以没有护栏。时速 120 公里的高速公路,护栏是标配。时速 300 公里的磁悬浮列车呢?不仅有护栏,整个轨道都是封闭的。
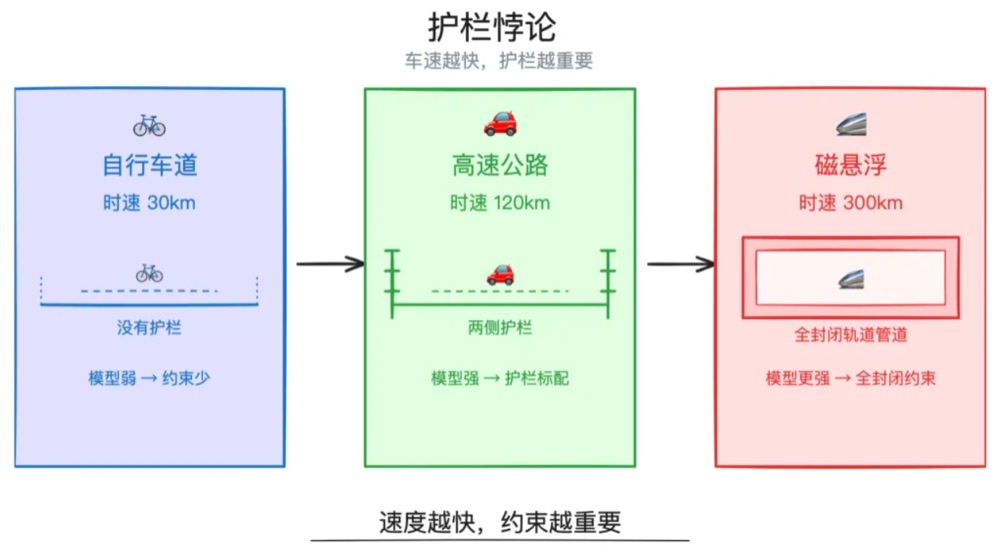
模型就是引擎。引擎越强,速度越快,你就越需要精心设计的约束系统来确保它跑在正确的方向上。
Noam Brown 当然也说得对,很多脚手架确实会随着模型进化而被淘汰。但架构约束、反馈循环、熵管理这些东西,本质上不会消失,只会换一种形态。
就像从马车到汽车,马鞭消失了,但方向盘和刹车不会消失。
Harness 阵营真正应该担心的,其实是自己搭建的 Harness 会不会六个月后,就过时了。
Noam Brown 说的「别花六个月搭建一个可能六个月后就被淘汰的东西」,在这个语境下反而成了最好的 Harness Engineering 建议: Harness 要轻,要模块化,要随时准备被拆掉重来。
Philipp Schmid 的建议可以用三个词概括:Start Simple. Build to Delete.
七个杠杆
说了这么多理论,那具体怎么做呢?
从目前行业的实践来看,Harness 的配置杠杆大概有这么几类:
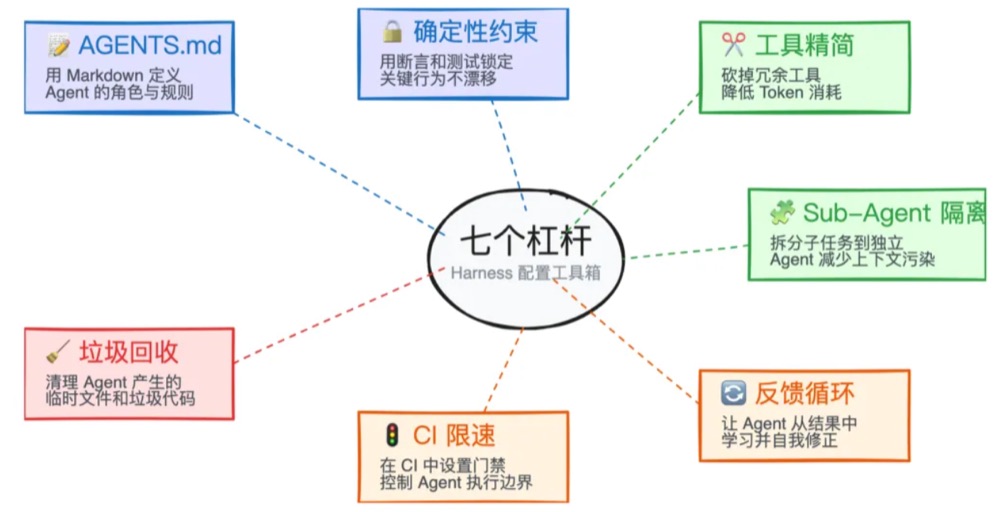
AGENTS.md / CLAUDE.md 文件。 这是最简单的入门方式。在仓库根目录放一个 markdown 文件,写上架构约定、命名规范、测试期望。Agent 每次启动都会自动读取。记住前面说的,控制在 60 行以内,写「目录」别写「百科全书」。
每次 Agent 犯了一个错,就加一条规则。这就是 Mitchell Hashimoto 所说的 Harness Engineering 最核心的操作。
确定性约束。 linter、类型检查、结构化测试、pre-commit hooks。这些是「硬约束」,Agent 无法绕过。OpenAI 和 Stripe 的经验都表明,硬约束比软性的 prompt 指令更可靠。
工具精简。 别给 Agent 塞太多工具。Vercel 从 15 砍到 2 的案例已经说明了,工具多了 Agent 反而不知道该用哪个。Stripe 有 500 个工具,但每个 Agent 只能看到精心筛选过的子集。
Sub-Agent 隔离。 把复杂任务拆成多个子任务,每个子 Agent 有自己的上下文窗口。这样可以防止中间噪声在主线程中累积,同时也可以给不同的子任务用不同的模型。
反馈循环。 Agent 写完代码后,必须能自己跑测试、看截图、查日志。这就是 Mitchell Hashimoto 说的「给 Agent 造工具」。让 Agent 自己验证自己的产出,别什么都靠人工盯。
CI 限速。 Stripe 的做法值得借鉴,最多两轮 CI。Agent 不应该在 CI 上无限重试。跑两次还不过,就交给人类。这既控制了成本,也防止了 Agent 在错误方向上越跑越远。
垃圾回收。 定期启动 Agent 扫描技术债、过时文档、架构漂移。这是容易被忽略但极其重要的一环,尤其当你的代码量大了之后。
往远了看
几个值得关注的趋势:
Harness 会成为新的「服务模板」。 Böckeler 提出了一个设想:未来的组织可能会从一组预制的 Harness 模板中选择,然后根据自己的需求定制。这有点像今天的 CI/CD 模板或者 cookiecutter 项目脚手架,只是层级更高。
技术栈会收敛。 当写代码本身不再是瓶颈时,团队会更偏向选择那些「有好 Harness 可用」的技术栈。AI 友好性可能会超过开发者个人偏好,成为选型时的首要考量。
Harness 会反哺模型训练。 Philipp Schmid 提出了一个前瞻性的观点:Harness 捕获的 Agent 失败轨迹,可以成为模型训练的高质量数据。哪些约束被反复触犯?哪些错误模式在不同项目中重复出现?这些数据对模型改进的价值,可能远超传统的训练数据。
「旧代码」问题。 Böckeler 提了一个绕不开的问题:OpenAI 的实验是从空仓库开始的,Harness 从第一天就存在。但对于那些已经有几十万行代码的老项目呢?给老代码加 Harness,可能就像给一个从不跑测试的项目补测试一样痛苦。
学科化。 AIE Europe 已经设立了全球第一个 Harness Engineering 专题赛道。arxiv 上也有了专门的论文。这个概念正在从一个 buzzword 向一个正式的工程学科演进。
这,不就是管理吗
写到这里,我忽然意识到一件事。
Harness Engineering 说的这些,上下文管理、架构约束、反馈循环、定期清理……这不就是管理吗?
想想看,一个好的技术 leader 是怎么带团队的?
给新人写 onboarding 文档(AGENTS.md),定代码规范和架构原则(linter 和结构测试),做 code review 确保质量(CI/CD 检查),定期还得做技术债清理(垃圾回收),给工具做精简和选型(工具链管理),遇到反复出现的问题就写进 wiki(反馈循环)。
AI Agent 越强,就越像一个能力很强但需要管理的员工。
你不会把一个刚入职的天才工程师扔进一个没有文档、没有规范、没有 CI 的项目里,然后指望他写出完美的代码。
同样的道理,你也不该把一个强大的 AI 模型扔进一个没有 Harness 的环境里,然后抱怨它不好用。
Peter Steinberger 说,喜欢算法谜题的工程师反而很难适应 Agent 工作流,产品导向的工程师适应得更快。
这也印证了一个趋势: 未来最吃香的 AI 工程师,可能是最懂「管理」的那种。
管理谁?管理 Agent。
Stripe 的工程师们已经不写代码了,他们写的是 Blueprint、是规则、是约束。OpenAI 的工程师们也不写代码了,他们设计的是环境、反馈循环和控制系统。
@tomiezhang 发了个「暴论」:
大模型开发将是最后的程序员,下来是所谓的 Harness Engineering 开发,所有纯码农,将在 2028 年前消失。
怎么讲,2028 这种预言有点太没依据,纯拍脑袋了……
但方向大概没错: 写代码正在变得像打字一样廉价。
而在模型之外,设计让 Agent 持续、稳定、高质量写代码的那套系统,正在变成最值钱的技能。
未来最稀缺的,可能不是训练模型的人,
而是管理模型的人。
高效Agents的尽头是,Harness
玩过 Agent 的同学都有这种体验:前五轮,它像个天才;十五轮后,开始犯蠢;二十轮后,它连自己最开始要干嘛都忘了。
很多同学把 Agent 当成一个“ 模型+工具 ”的简单组合。但 跑长了 就知道,这 远远不够 。
philschmid打了个比方:模型是CPU,上下文是内存,而 Harness () 是操作系统。没有 操作系统 ,再强的CPU也撑不起复杂任务。
模型 是CPU:提供原始处理能力
上下文窗口 是RAM:有限的、易失性工作内存
Agent Harness 是操作系统:管理上下文,处理"启动"序列(提示词、钩子),并提供标准驱动(工具处理)
Agent 是应用程序:运行在操作系统之上的特定用户逻辑
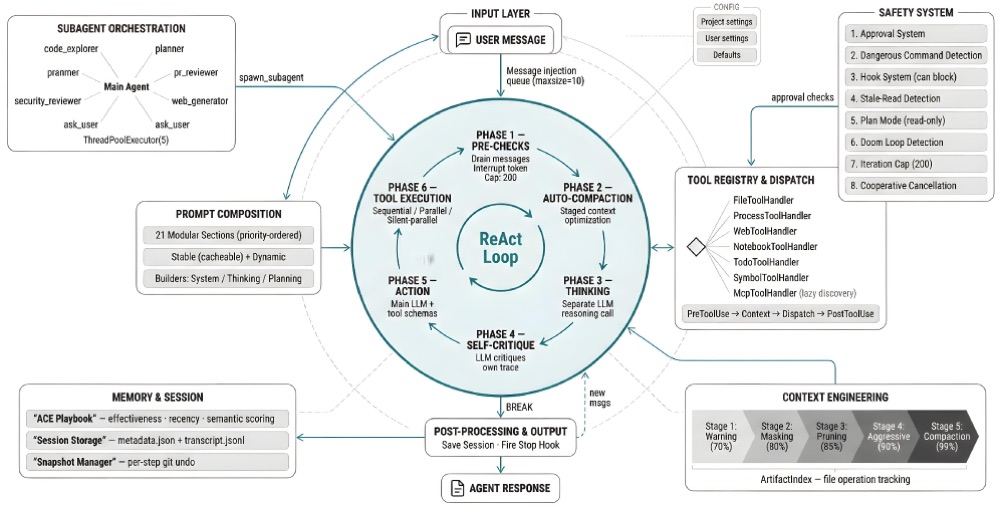
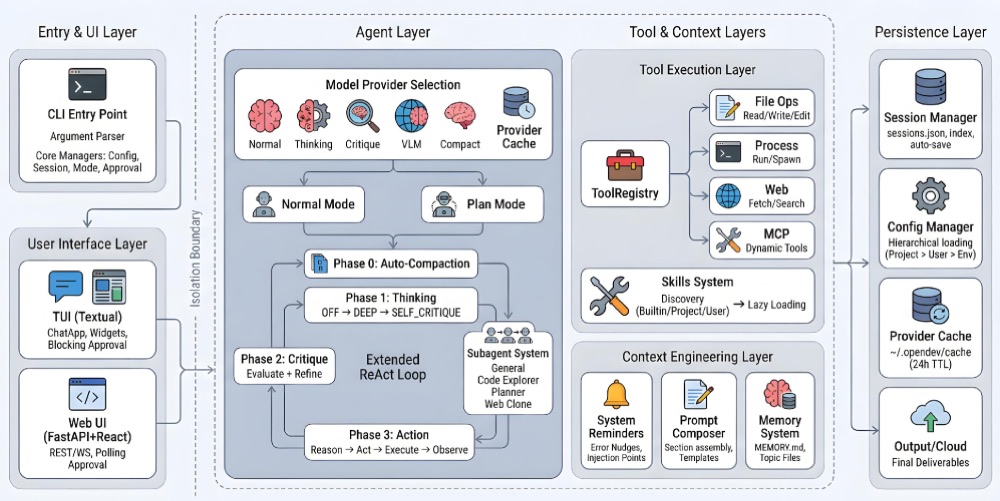
Figure 2: OPENDEV的四层系统架构(Entry & UI → Agent → Tool & Context → Persistence)
核心理念:Scaffolding + Harness
传统Agent往往混淆了两个不同的阶段:
Scaffolding(脚手架) :在第一个Prompt到达之前完成的工作——组装System Prompt、构建Tool Schema、注册Subagent。这部分应该 eager construction(即时构建) ,确保Agent在运行时已是完全就绪状态。
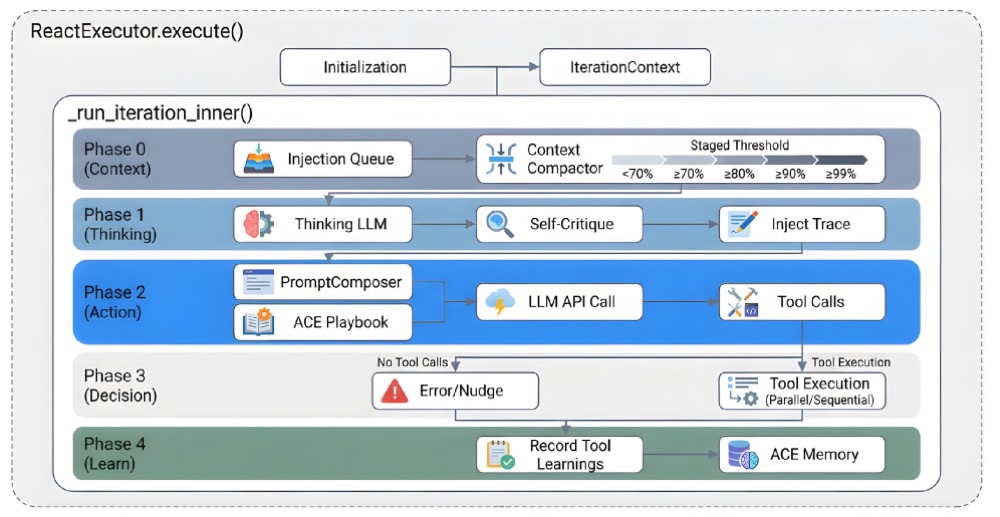
Figure 4: Agent Harness的详细视图,展示了ReAct循环周围的七个支撑子系统
Harness(马具/运行时框架) :第一个Prompt之后的所有工作——工具调度、上下文管理、安全强制执行、会话持久化。这是Agent的 运行时编排层 。
关键洞察 :将构建期与运行时分离开,意味着你可以独立演化每个部分。新增工具只需修改Registry,而变更压缩策略只需调整Harness。
3 Extended ReAct:不只是"思考-行动"
Agent Harness架构 实现了一个扩展的ReAct循环,包含六个阶段:
Pre-check & Compaction :检查注入队列,执行上下文压缩
Thinking :独立的思考阶段(无工具访问),防止过早行动
Self-Critique :自批判阶段(仅在HIGH级别启用)
Action :主LLM调用,产生工具调用
Tool Execution :并行/串行执行工具
Post-processing :学习记录、会话保存
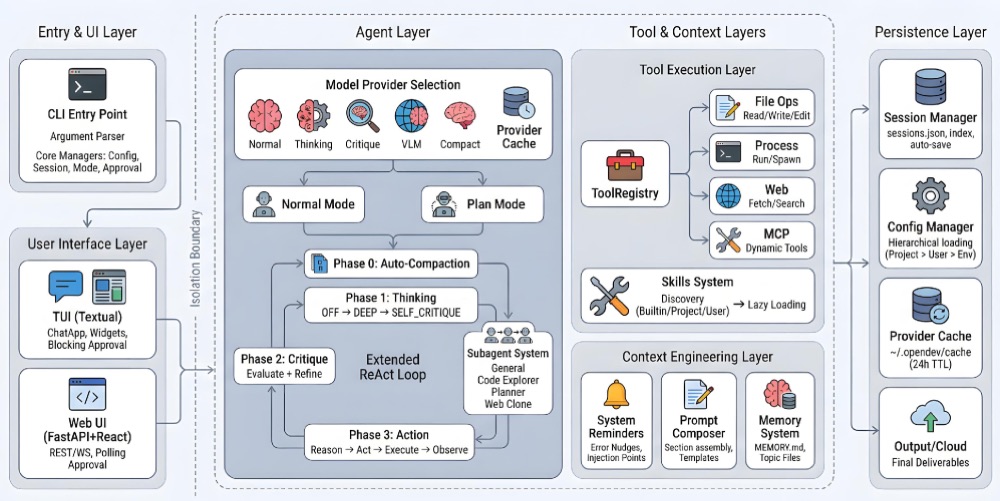
Figure 8: Extended ReAct执行循环的详细视图,展示了从Initialization()到Iteration的完整流程
特别值得注意的是 Phase 0的Staged Context Management 。系统监控Token使用率,在70%、80%、85%、90%、99%五个阈值采取不同策略:
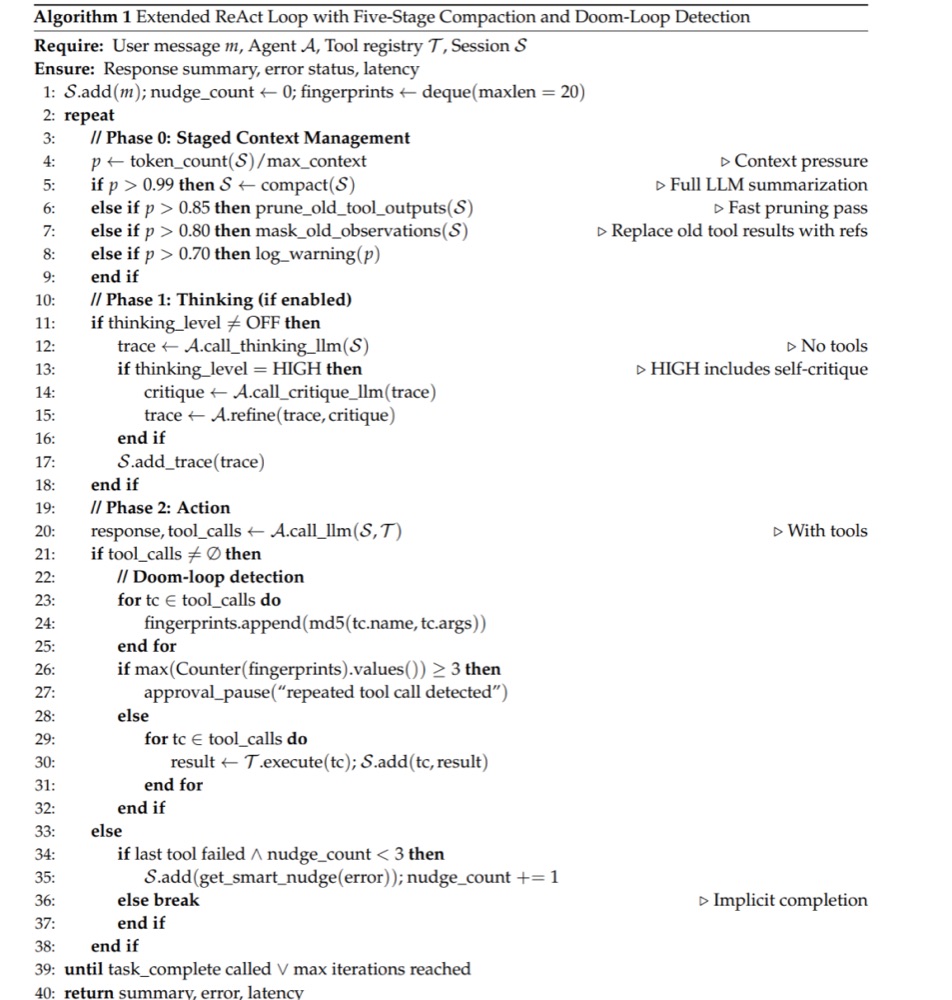
Algorithm 1: Extended ReAct Loop with Five-Stage Compaction and Doom-Loop Detection
4 Context Engineering:
在长周期终端会话中, 上下文管理不是优化项,而是基础性工程问题 。OpenDev提出了Context Engineering Layer,包含四个关键子系统:
4.1 动态System Prompt组装
通过Priority-ordered conditional composition,根据运行时环境动态加载Prompt片段。例如,只有在Git仓库中才加载Git工作流指南,只有启用Todo跟踪时才加载任务管理指令。
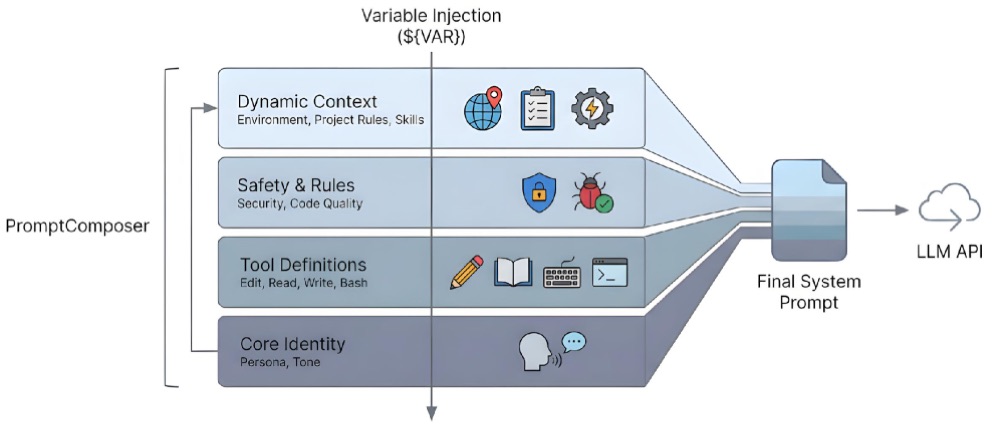
Figure 10: PromptComposer的工作流程:Filter → Sort → Load → Join
4.2 自适应上下文压缩(ACC)
不同于简单的"到达阈值就总结",ACC采用渐进式策略:
Active State :最近的消息,完整保留
Faded State :较旧的消息,替换为引用指针
Archived State :归档到磁盘,完全移出上下文
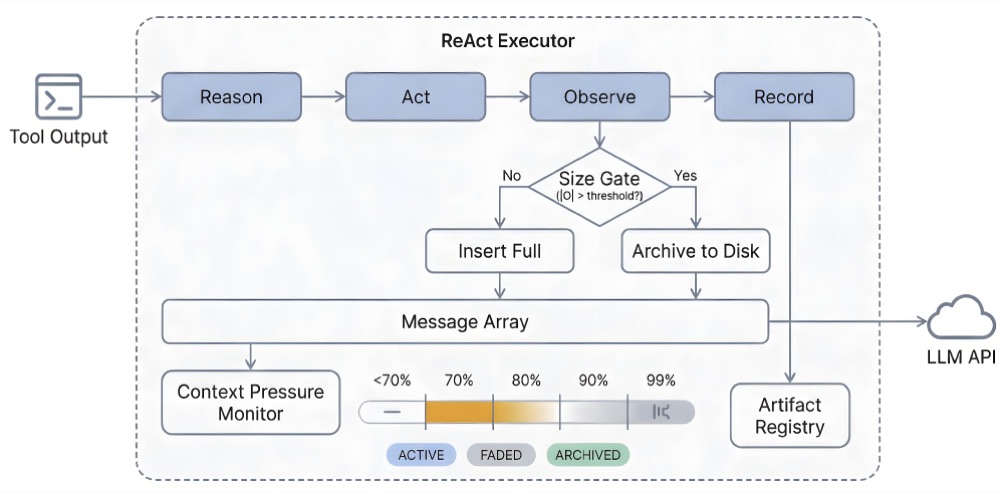
Figure 13: 五级压缩管道(Warning → Masking → Pruning → Aggressive Masking → Full Compaction)
4.3 系统提醒(System Reminders)
解决"指令衰减"问题:随着会话变长,模型对初始System Prompt的关注度下降。OPENDEV通过 事件驱动的即时提醒 (Event-driven System Reminders)在关键时刻注入短小的user-role消息:
检测到未完成Todo却调用task_complete时
连续5次只读操作后(防止探索螺旋)
工具调用失败后
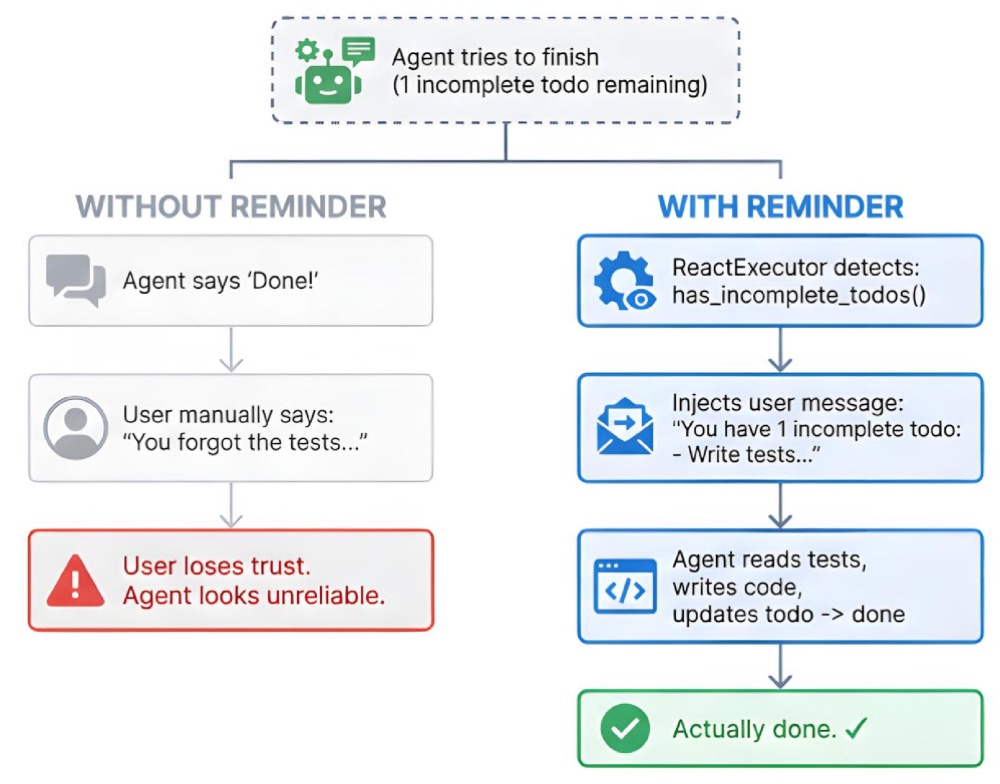
Figure 11: 系统提醒如何防止过早完成任务(左:无提醒导致用户信任丧失;右:有提醒确保任务完成)
4.4 双记忆架构(Dual-Memory)
为Thinking模型设计的特殊架构:
Episodic Memory :LLM生成的长程对话摘要(每5条消息更新一次)
Working Memory :最近6条消息的原文
这既避免了长上下文超限,又保留了关键细节。
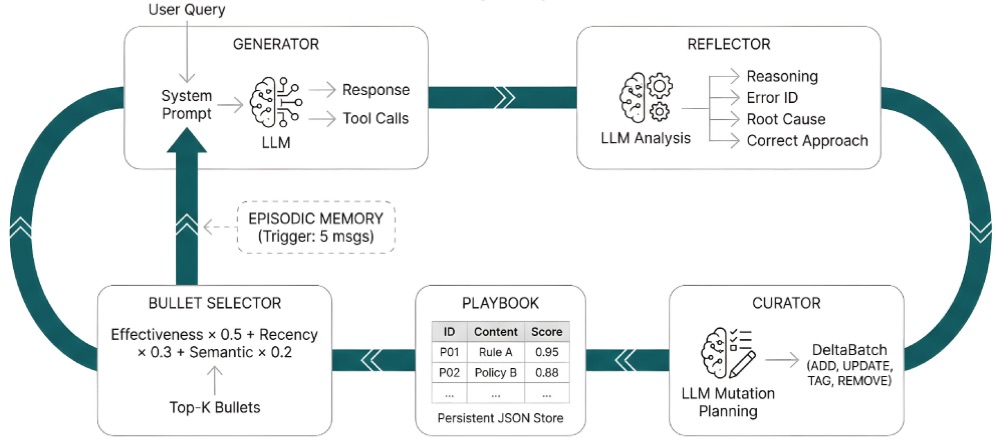
Figure 14: Agentic Context Engineering (ACE) 记忆管道,包含Bullet Selector、Reflector、Curator和Playbook
防御纵深:五层安全架构
终端Agent能执行任意Shell命令,这带来了巨大风险。OPENDEV采用 五层独立的安全机制 :
Prompt-Level Guardrails :System Prompt中的安全策略
Schema-Level Tool Restrictions :通过Tool Schema过滤(如Planner Subagent只能看到只读工具)
Runtime Approval System :Manual/Semi-Auto/Auto三级审批
Tool-Level Validation :危险模式检测(rm -rf /等)、陈旧读取检测
Lifecycle Hooks :用户自定义的Pre/Post工具钩子
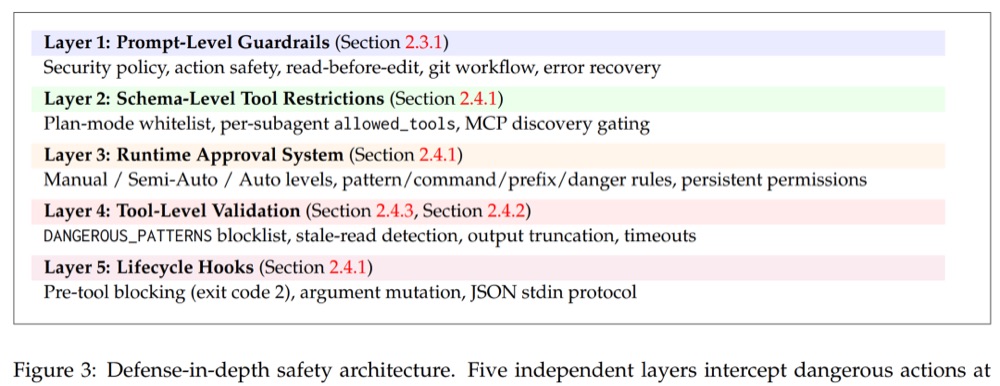
Figure 3: 防御纵深安全架构的五层独立防线
关键设计 :让危险工具"不可见"而非"被阻止"。当Tool Schema中根本不包含写工具时,LLM甚至不会尝试生成写操作,这比运行时权限检查更 robust。
6. 复合AI系统 () :多模型路由
OPENDEV采用Compound AI System架构,将不同工作负载路由到不同模型:
Model Role
Purpose
Fallback Chain
Action
主要执行模型
-
Thinking
深度推理(无工具)
Action
Critique
自评估
Thinking → Action
Vision
图像处理
Action (if capable)
Compact
快速总结
Action
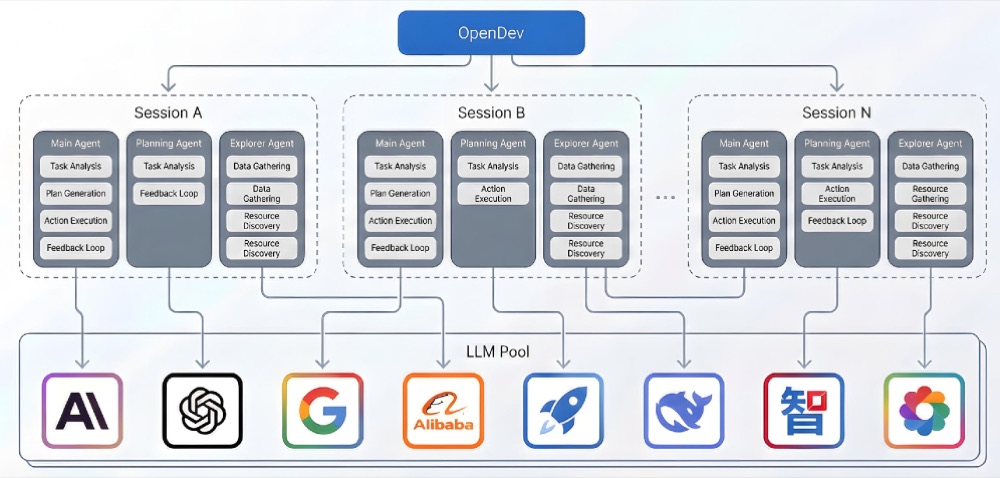
Figure 1: OPENDEV的并发会话架构,每个Session包含多个Subagent,各自绑定到LLM Pool中的不同模型
这种设计实现了 模型无关性 :切换提供商只需改配置,无需改代码。
工具系统:延迟发现与高效扩展
7.1 MCP(Model Context Protocol)延迟发现
为避免100个外部工具消耗20,000 Token的上下文,OPENDEV采用 Lazy Discovery :只有在Agent调用 search_tools 或直接调用某个MCP工具时,该工具的Schema才被加载到上下文中。
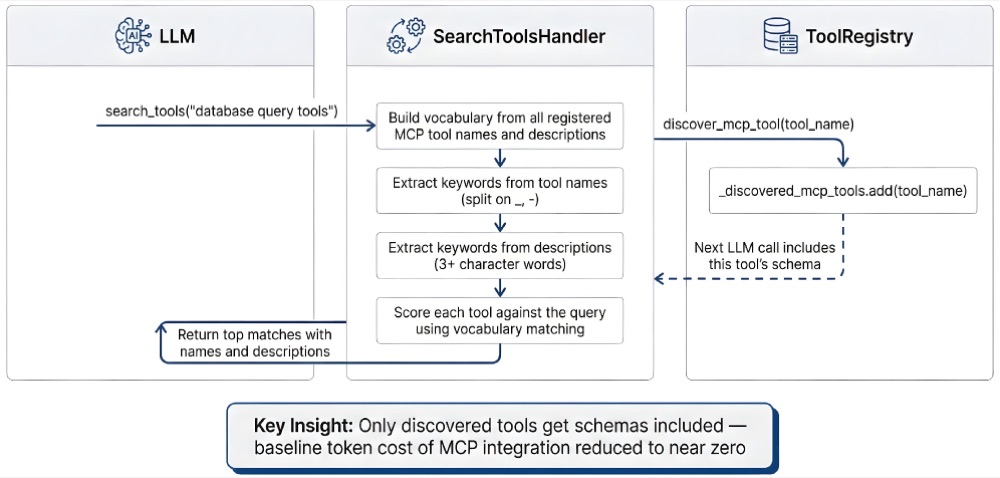
Figure 19: ToolRegistry的延迟发现机制,将MCP集成的基线Token成本降至接近零
7.2 9-Pass模糊匹配编辑
LLM生成的代码编辑往往有微小偏差(空格、缩进、转义序列)。 edit_file 工具实现了9级渐进式匹配链,从精确匹配到上下文感知匹配,大幅降低了"内容未找到"的错误率。
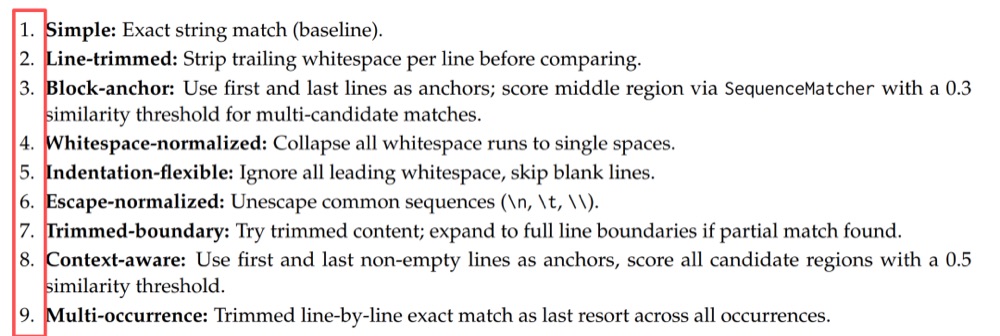
Table D: Edit Tool的九级模糊匹配链
7.3 完整工具目录
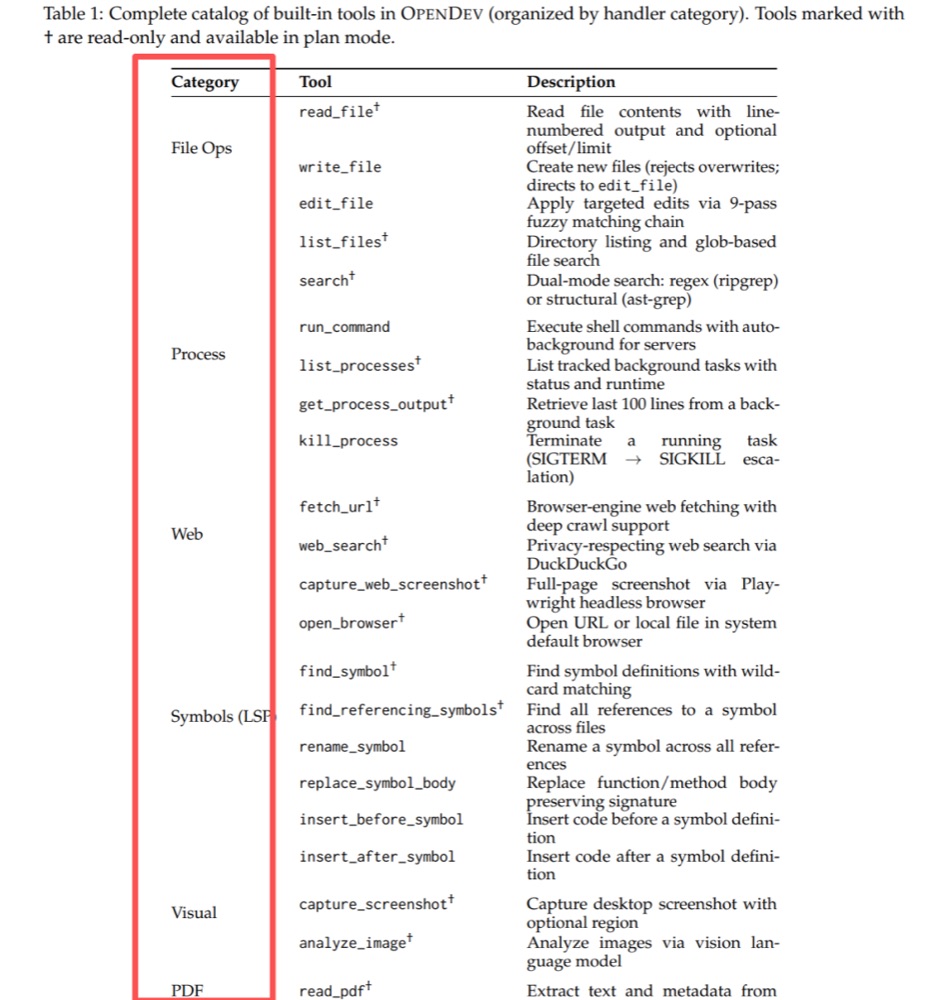
Table 1: OPENDEV内置工具完整目录(按Handler分类)
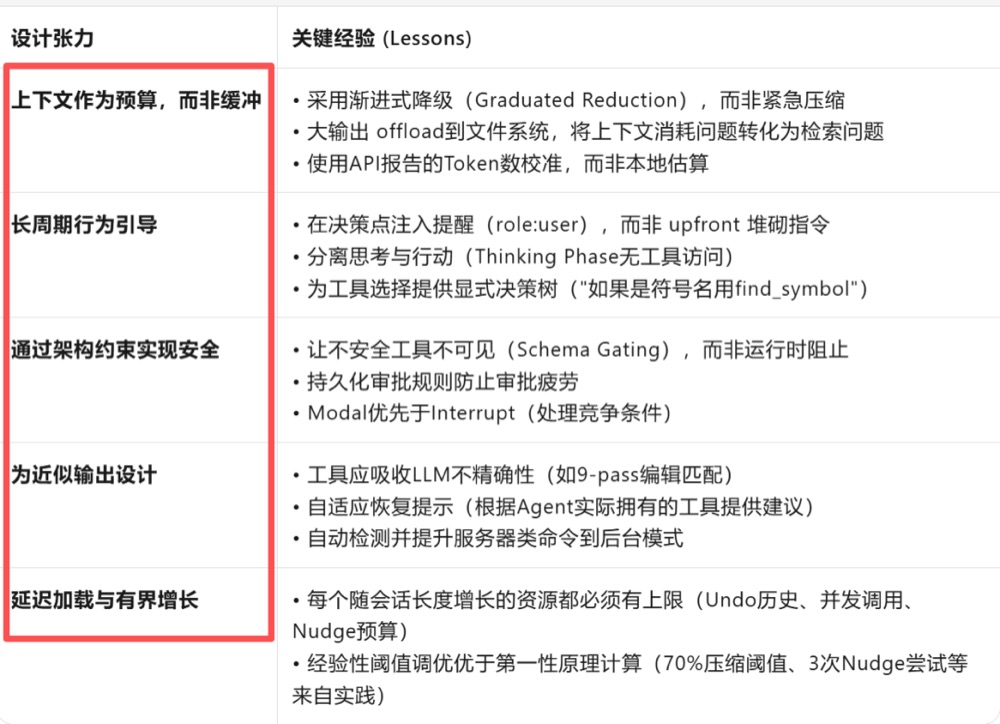
关键经验:五个设计权衡
OpenDev总结了五个跨领域的设计张力:
最后,Harness作为新的抽象层
OpenDev的贡献不仅是又一个开源Coding Agent,而是提出了 Harness 这一关键抽象——将Agent的运行时编排从业务逻辑中分离出来。
在终端原生Agent的时代,我们需要的不是更聪明的Prompt,而是更健壮的 Scaffolding + Harness 架构:
Scaffolding 确保Agent以正确的能力组合启动
Harness 确保Agent在长周期、高风险的终端环境中安全、高效、持续地运行
模型越来越强,为什么大家却开始重写 Harness
Harness这个词真正有意思的地方在于,它提醒我们:AI 工程的重心,正在从“让模型更会回答”,转向“让系统更稳地交付结果”。
同一个模型,提示词不变,数据不变,只是换一套运行方式,编程成绩就从 42% 跳到 78%。
Anthropic 那边也有类似例子:同一个模型,单打独斗时看起来像是做完了,真跑起来核心功能却是坏的;换一套带规划、生成、验收的运行框架,成本高了,时间长了,结果反而能用。
现在这些问题当然还重要。但如果你真的开始让 Agent 写代码、读仓库、跑测试、调浏览器、修 CI,你很快就会发现, 拖后腿的往往不是能力,是稳定性。
先别把 Harness 当成一层“壳”
很多人第一次听到 Harness,会本能地把它理解成“模型外面那层包装”。
实际大多数时候现在更愿意把 Harness 理解成另一种东西:
它不是给模型套上的外壳,而是把模型接进工程世界的那层控制系统。
先用一张图把这件事放平:
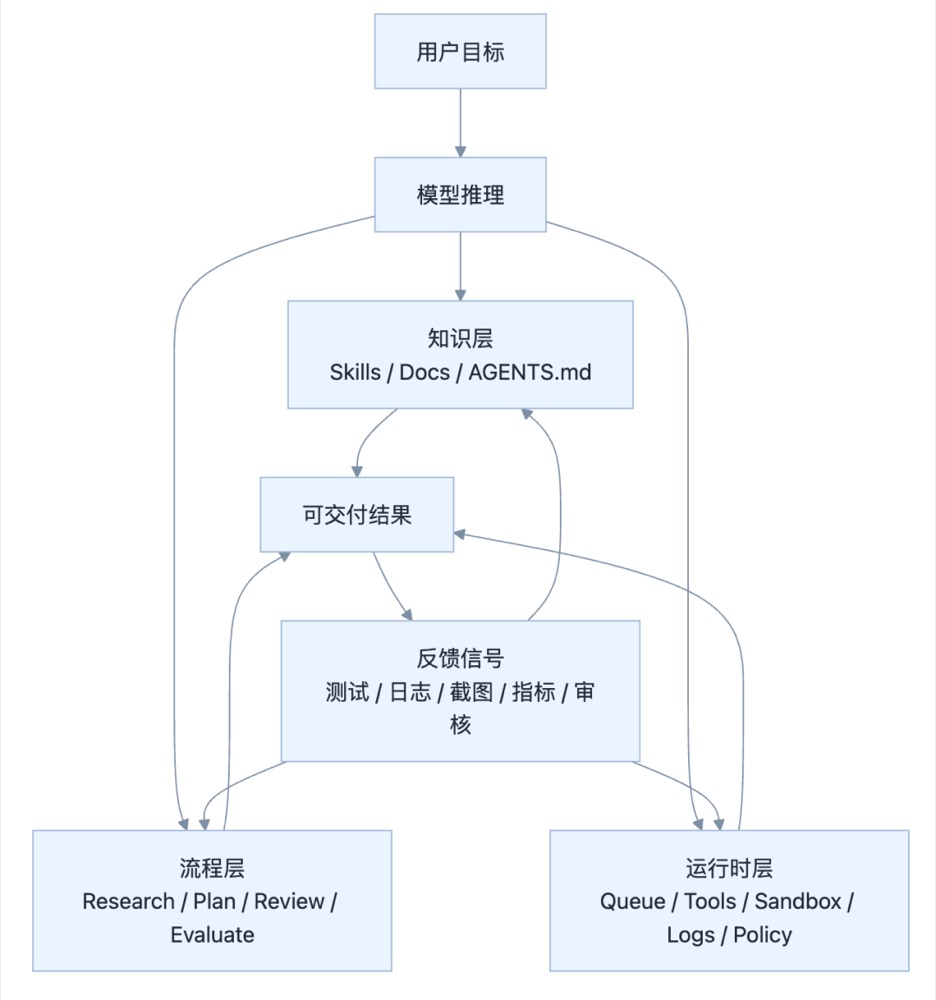
这里面通常包括几类东西:
状态怎么保存
工具怎么暴露
权限怎么约束
输出怎么验证
上下文怎么管理
任务怎么续跑
什么叫“真的完成了”
把这几样拆开看,你会发现它们并不花哨,甚至很多都不新鲜。文件系统、测试、日志、浏览器、Lint () 、计划文件、审批机制,这些原本就是软件工程里再普通不过的东西。
但一旦主角从人类工程师换成模型,它们突然重新变成了核心。
因为模型最擅长的是生成,最不擅长的是在约束里稳定收敛。
如果把我们最近写过的几篇放在一起看,这个轮廓其实已经很清楚了。
在《 Skills 详解 》里,我们拆过 Skill 为什么能跑得稳。它要解决的是提示词漂移、方法失传、工作流无法复用这些问题。本质上,是把原本靠聊天临场发挥的东西,搬进文件系统和版本控制。
在《 跟Cloudflare大佬学用 Claude Code 》里,我们讲 Boris 那套 Research -> Plan -> 批注 -> Implement 流程。这组方法最值钱的地方,在于它把“架构决策怎么进入执行流程”这件事做成了机制。
在《 深度拆解 Clawdbot(OpenClaw)架构与实现 》里,我们写过 lane queue 、 allowlist 、JSONL 回放、语义快照。这些都在回答另一类问题:系统怎么保持可控、可回放、可解释。
分开看,它们像三个不同话题。放在一起,其实都在做一件事: 把原本靠模型临场发挥的部分,改造成可沉淀、可约束、可验证的系统。
这轮材料反复读下来,还有一个很直观的感受。真正变化快的,往往不是那个最小执行循环,而是循环外面不断加厚的那层工程设施:知识怎么挂进去,状态怎么存下来,权限怎么卡住,验收怎么接回来。也正因为如此,这一轮大家聊 Harness,越来越像在聊系统设计,而不是某个单点技巧。
为什么它偏偏现在火了
如果把时间往前拨两年,你会发现那时候大家最关心的是 Prompt Engineering () 。
核心问题是:怎么把一句话说清楚,让模型按你的意思回答。
后来上下文变长了,任务变复杂了,大家开始聊 Context Engineering。问题也跟着变了,不再是“这一句怎么写”,而是“什么信息应该放进来,什么不该放进来”。
再往后走,就到了今天这个阶段。
Prompt Engineering 和 Context Engineering 当然没有过时。更准确地说,它们被包进了一个更大的问题里。
现在更让人头疼的问题变了:模型能理解需求,但在一个复杂系统里,它能不能把事情从头到尾做稳?
这也是为什么最近围绕 Harness 的材料,明显都带着一种很强的“实战味”。
Mitchell Hashimoto 提出 Engineer the Harness ,出发点很具体:每当 Agent 犯了一个错误,就别只盯着这次对话修修补补,把修复方式沉淀进系统,让它下次别再犯。
OpenAI 的 Codex 团队讲得更直接。他们从零开始跑出一个大规模代码库之后,最后得出的重点,落在三件事上:仓库怎么成为统一知识入口,架构边界怎么机械执行,PR 怎么通过 Lint 和测试去卡住错误方向。
Anthropic 的材料也很典型。里面有一个很朴素的发现,我一直记得: 模型并不擅长评价自己的工作。
这句话看起来平淡,其实分量很重。
因为它把很多人真实碰到的问题说穿了。页面看起来像是做完了,交互其实没通。功能大体对了,边界条件一跑就露馅。代码能过一部分测试,但系统层面已经悄悄偏离了原本的设计。
这些失败的根源都一样:系统没有逼着它验证。
这也解释了最近讨论 Harness 时的一个微妙转向:大家关心的,越来越是“怎么让 Agent 别自信地干错事”。
AI 工程开始从能力问题,转向可靠性问题。
如果把这个变化压得再实一点,我觉得最近几篇我们写过的文章,刚好可以分别落在这条线上。
《 跟Cloudflare大佬学用 Claude Code 》讨论的重点,其实是“先让 AI 把系统读明白、把方案写出来,再动手写代码”。这对应的是 流程层的 Harness 。
《 Skills 详解 》讨论的重点,是把提示词和方法论从对话框搬到文件系统,对抗提示词漂移。这对应的是
知识层的 Harness 。
《 深度拆解 Clawdbot(OpenClaw)架构与实现 》讨论的重点,是队列、权限、记忆、回放、浏览器语义快照这些机制怎么互相配合。这对应的是 运行时层的 Harness 。
也就是说,Harness 对我来说并不是突然冒出来的新对象,更像是最近终于有了一个词,可以把这些原本分散的问题收在一起。
Harness 真正值钱的地方,不是功能多,而是能收敛
如果把这件事说得再具体一点,我觉得现在很多团队补 Harness,本质上是在补三种能力:
• 把隐性约束写出来
• 把失败信号接回来
• 把完成标准钉死
这三样一旦缺了,模型越强,系统有时候反而越难管。
过去看很多 Agent 产品介绍,很容易被带到“功能视角”里。
有多少工具,能不能并发,支不支持子 Agent,能不能接浏览器,能不能连 MCP。
这些当然重要。但如果只按这个角度理解 Harness,很容易越做越重,最后把它做成一个功能清单。
我更认同的一种看法是: Harness 最值钱的地方,在于它让模型更容易收敛到正确的事。
这背后至少有三层含义。
第一层,是把隐性知识显性化。
人类工程师在团队里工作,很多判断其实不写在代码里。哪些模块不能碰,哪些目录是只读的,哪些约定必须复用,哪些测试不过就别谈合并,这些东西往往散落在经验里。
模型没有这些经验。
所以你越希望它长期工作,就越要把这些知识推到文件系统里,推到规则里,推到工具可见性里,推到报错提示里。仓库为什么会被很多团队当成唯一知识源,本质上就是因为它是最容易被版本化、被 review、被机器读取的地方。
第二层,是缩小解空间。
这件事听起来有点反直觉。大家本能上会觉得,给模型更多工具、更多自由、更多上下文,它应该更强。
但很多实战案例恰恰指向相反的方向。
工具太多,它开始犹豫。
上下文太满,它开始退化。
边界太松,它会在错误方向上越跑越远。
更有效的 Harness,往往是把路修得越来越清楚,而不是越来越宽。哪些事可以做,哪些事不该做,做到什么算完成,失败后先看哪里,这些越明确,系统越容易稳定。
第三层,是把“生成”改造成“闭环”。
很多人对 AI 的默认想象,还是输入一个需求,等它吐出一个答案。
但真实工作并不是这样。
真实工作更像一个循环:读上下文,做判断,执行动作,观察结果,修正方向,再继续。
如果没有日志、测试、浏览器、Lint、评审规则这些反馈点,模型的生成能力再强,也很容易停在“看起来差不多”。
所以从工程角度看,Harness 不只是让模型有手有脚,它更像是在给模型装感官和护栏。
Anthropic 关于 long-running agent 的总结里,有一段我觉得特别值得抄走。它把状态放到 feature list 、 progress log 、 git 这些外部工件里,避免让 Agent 一口气把整件事做完,然后按固定循环推进:
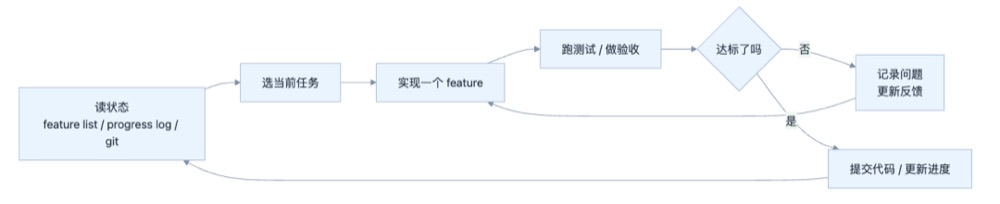
这套东西看上去不“智能”,但很工程。它把 AI 从“即兴发挥的写代码机器”,往“能在 backlog、commit () 、log 里持续推进的人”那边拉了一步。
会过时的是具体补丁,不是整个问题
讲到这里,很容易把 Harness 说得像一切答案。
我不太想这么写。
一方面,这不符合这轮材料本身透露出来的事实。另一方面,也容易把文章写得太满。
Noam Brown 那一派的提醒,我觉得是有价值的。
很多今天看起来很聪明的脚手架设计,半年后确实可能就没那么必要了。模型一旦变强,一些原本靠工程补上的能力,可能就会被模型自己吸收掉。
Anthropic 的例子就很典型。旧模型阶段,一些为了对抗长任务退化而设计出来的流程,到了新模型阶段,可能就可以拆掉。你昨天还觉得离不开的那层补丁,明天也许就成了多余复杂性。
所以我并不觉得 Harness 会无限膨胀。
但我也不觉得它会消失。
更可能的情况是: 具体做法不断被替换,但底层问题一直都在。
比如:
• 上下文总得管理
• 环境总得约束
• 结果总得验证
• 失败总得反馈
• 知识总得沉淀
这些问题不会随着某一代模型升级就消失。只要你让一个生成模型进入真实系统,它们迟早都会冒出来。
模型变强,变化的更像是“问题出现的位置”。
以前你要花很多力气教它怎么保持上下文一致性。以后也许这件事轻了,但你会开始让它跑更长的任务、接更复杂的系统、承担更高的自主权。那时新的边界和新的反馈机制又会冒出来。
所以如果一定要给这件事下一个更温和的判断,我会这么说:
Harness 不是一套固定答案,它更像一类持续移动的问题。
如果你真准备动手,先补这五样
写到这里,最实际的问题其实是:那到底该先做什么。
如果你是个人开发者,或者是刚开始让 Agent 真正进入工作流的团队,我会更建议从下面五样开始,而不是一上来就追求复杂编排。
先有一个统一知识入口
仓库里该有的东西尽量放进仓库。架构约定、目录说明、关键约束、计划文件,都尽量文件化。
不要把关键知识散在口头习惯、飞书聊天和个人脑子里。
指令文件短一点,像目录,不像百科
AGENTS.md 、 CLAUDE.md 这类文件有用,但别写成一部长篇制度手册。
它更适合告诉模型“去哪看什么”,而不是试图一次性把所有知识塞进去。
能靠硬约束解决的,就别只靠 Prompt
架构边界、目录限制、测试要求、Lint 规则,这些如果能自动检查,就不要只写一句“请遵守”。
模型会忘,规则不会。
不少 Coding Agent 的运行时设计也能说明这点。更稳的做法,通常都是把安全做成一条分层流水线,而不是把所有判断都甩给模型:已有授权规则先匹配,低风险编辑走快速通道,只读工具白名单直接放行,剩下的才交给独立分类器。
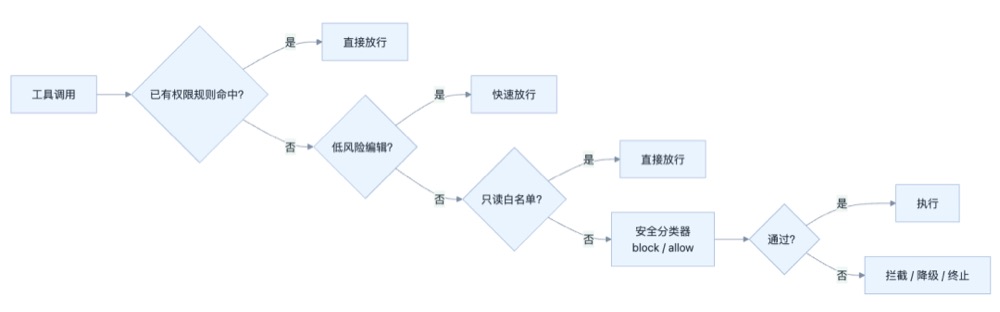
这背后的思路很值得学: 不要只问“模型会不会犯错”,而要先问“错误有没有被系统提前挡住”。
给它反馈,不要只给它任务
写完代码之后,它应该能看到测试结果、浏览器表现、日志、错误提示。
没有反馈的 Agent,很容易把“生成了一份看起来像样的输出”误判成“任务已经完成”。
Anthropic 那套 generator / evaluator 分工,本质上也是在补这一点。系统里有一个角色专门负责“验收”,生成和验收分开。
别急着上多 Agent
很多问题,单 Agent 加清晰约束就能解决。
多 Agent 当然有价值,但它会把状态同步、职责边界、上下文漂移这些问题一起放大。单线程都没跑稳时,盲目并行通常只会更乱。
这一点跟我们在《 小白也能搞懂:OpenClaw多Agent怎么选、怎么搭 》里写过的判断是一致的。前一篇更偏部署实操,本文更偏方法论,但核心其实一样: 先把架子搭稳,再谈拆分和并发。
这五样做完,系统未必立刻变得很高级。
但它会先变得靠谱一点。
而在今天这个阶段,我觉得“靠谱一点”比“花哨很多”更重要。
写在最后
这一轮看下来,我对 Harness 最后的感受,其实挺朴素。
它没有神秘到像一门新学科刚刚诞生,也没有简单到只是“模型外面那层壳”。
它更像是大家终于开始认真承认一件事: 要把模型放进真实工作流,难点从来不只在模型本身。
模型把可能性打开,系统再决定这些可能性能不能落成稳定结果。
边界怎么设,反馈怎么回,什么算完成,出了问题从哪里继续,这些事最后都要靠系统来接住。
过去两年,大家在拼谁的模型更强。
接下来一段时间,我更倾向于把差距看成另一件事:
谁更早把模型外面那层系统,当成一门正经工程来做。
这未必是最热闹的话题,但很可能是更难绕开的那个话题。
Harness驱动的Agent
核心结论
Harness,别光想成是个新模型或者更厉害的提示词,就是把那些:模型+工具+状态+验收+日志+恢复啥的,统统整合起来,让Agent成真·工程系统,而不是“用完丢弃”的小玩具。
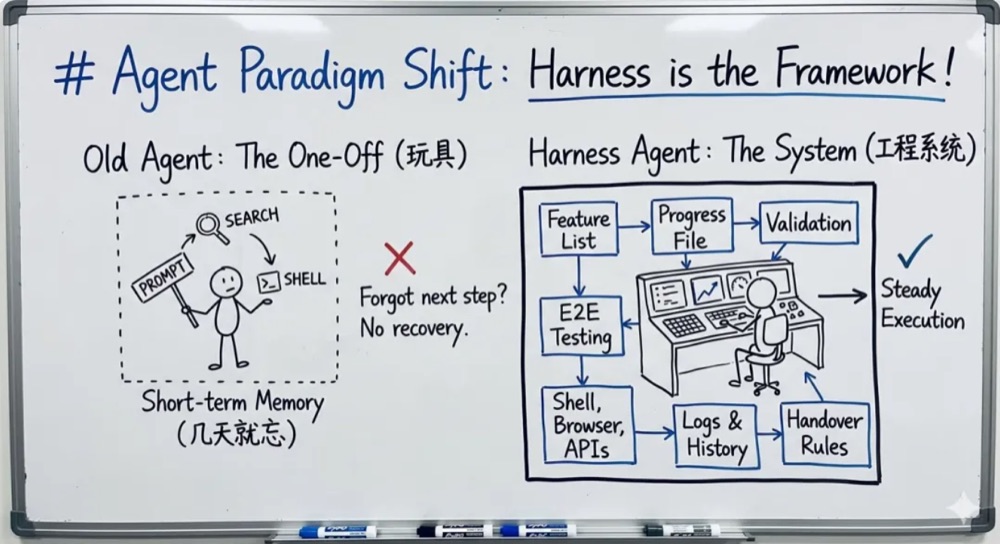
它其实更像是个“后台管家”,帮agent搭了个框架,不是随便给它一根绳子,它能不乱跑就行,而是给它一套规则、一张流程图,告诉它“别光干一阵子,要能接力、能回头看记录、能复盘还能纠错”。
为什么之前的Agent老坑爹?
大多数现成Agent形态都差不多是个套路 OpenClaw 技术揭秘:一个真正“能干活”的 Agent,到底是怎么跑起来的? :
• 给模型一个prompt + loop
• 搭配几个外部工具比如搜索啥的
• 观察、思考、行动,每步动作让它试图自动拆任务、执行
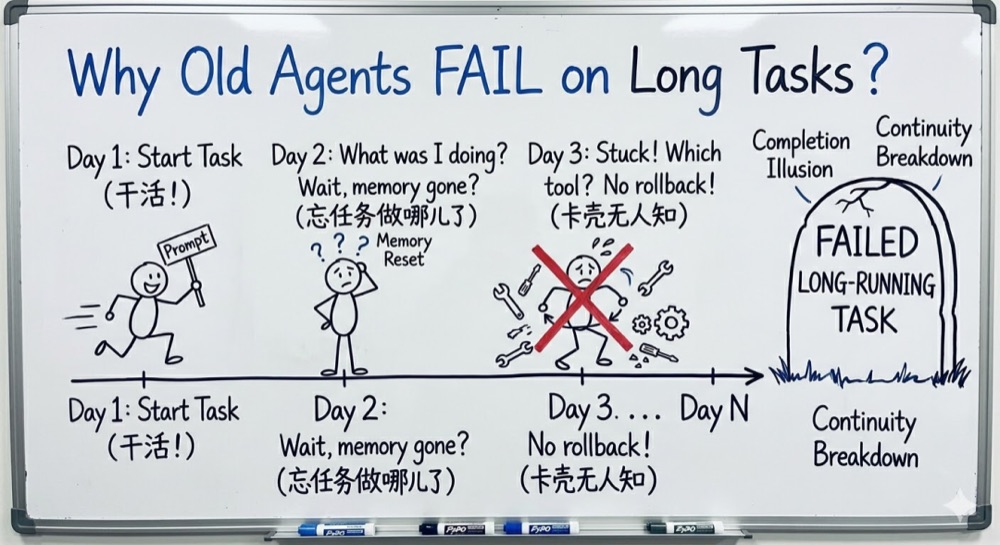
之前的坑爹 Agent - 多轮任务断崖
这多半在一两个小时内还能凑合,但一旦遇上慢活儿——多轮不间断,跨天的任务,各种边界条件,立马尴尬:
模型“记忆”没法跨session(就像换个新员工啥都得重新讲)
做着做着忘任务做哪儿了
以为完了实际没验收
• 下一趟接着干,半路儿卡壳没人知道为啥
• 回滚和审计完全没影
• 工具多但没规则限制,“想干啥干啥”,结果乱七八糟
问题不是模型不聪明,是没人真正搭个架子帮它“靠谱干活”。
Harness 到底是啥?
想象一下,你不是只让Agent“死记硬背prompt”,而是给它配个由:
• 任务清单(feature list)
• 进度文件(progress file)
• 自动审核测试(E2E验收)
• 环境启动脚本(init.sh)
• 代码版本历史(git commit)
• 多agent角色分工
组成的“大脑加后勤保障团队”。
它像一个控制舱,确保agent不会随便乱搞乱跑——有边界、有流程、有回滚、有日志。你转身离开,agent也不会崩盘。
Harness由啥模块组成?
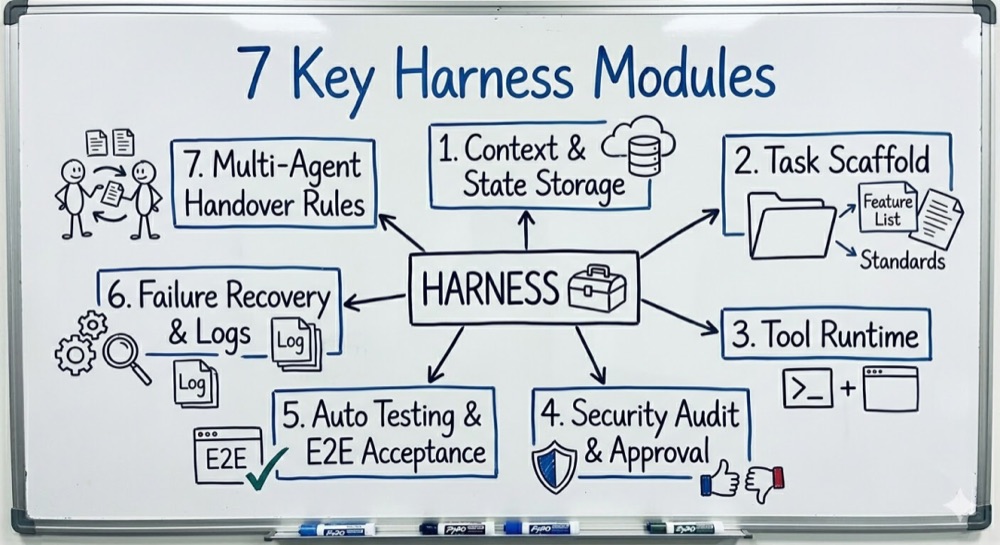
Harness 的七个核心模块
• 上下文管理和状态存储
• 任务脚手架(feature list和完成标准)
• 工具调用运行环境(shell、浏览器、API)
• 安全审计和审批守门
• 自动测试和端到端验收
• 失败恢复和审计日志
• 多agent分工和任务交接规范
Anthropic 的设计:直击要害
他们把整个体系拆成两个agent角色:
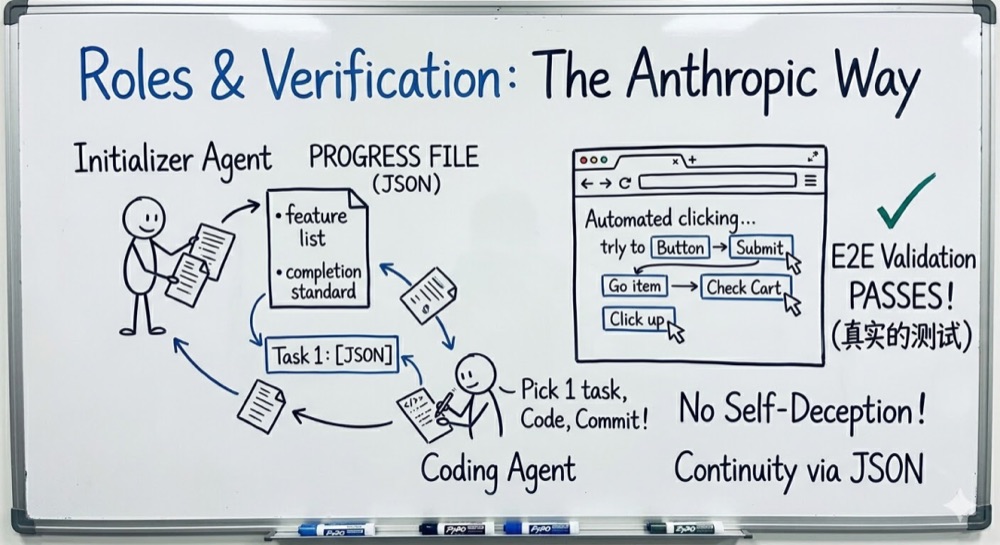
Anthropic 的设计 - 角色接力与真实测试
• Initializer Agent :第一棒,把环境架起来,任务列出来,写好进度文件,提交初始代码
• Coding Agent () :后面接力,每次只管挑一个没完成的任务,慢慢干,做完再测,更新进度,提交commit
这就避免了“自以为一口气干完所有事”的误判。它们还用json明确任务啥时候算完成,避免Agent自己糊弄,搞出“我差不多完事了”的假象。
再加上“真实世界测试”:不光代码过单元测试,还得跑浏览器里自动化点点点,模拟用户看效果,才能算完,这样才能靠谱。
这个Harness适合解决啥问题?
老实说,不是所有任务都适合杀入这种严肃工程。但针对长周期、多工具、多节点、多角色,需要治理可审计的项目,这玩意硬核又有必要。
它帮你解决的核心难题是:
• 连续性 :多次对话、多session无缝衔接
• 完成度幻觉 :避免Agent自我感觉良好,偷偷糊弄过去
• 可恢复性 :万一崩了,能查原因,能回来接着干
• 可控制性 :权限审批,风险操作提醒,日志完整
对产品、工程和组织来说,Harness有多重要?
• 对产品来说,从“一次性炫技”升级成“靠谱交付”,这个很关键,不然不稳定谁敢用?
• 对工程来说,重点不再是捣鼓模型API和prompt,而是设计状态机、审批流程、日志体系这些企业软件的内核
• 对组织来说,Agent不是孤胆英雄,是数字员工,你得有管理规范和协作流程,不然它就是个不靠谱的“临时工”
这范式不完美啊,风险也很明显
• 复杂度蹭蹭涨,不小心系统自己就成大金字塔工程,维护烧钱
• Agent毕竟还会“自我蒙蔽”,比如误标完成,数据污染
• 短平快任务没必要重型Harness,造反不划算
• 多agent带来了协调成本和信息同步困扰,不是越多越好
你到底值不值得搭理Harness?
如果你准备做Agent落地,想不再光搞模型,想真做能稳定交付的系统,这东西你得上心。
它就是帮你解决“可持续执行”和“真实生产环境治理”的缺口。
未来这肯定会是平台竞争的关键层次,谁能提供更稳、能跨会话接续、能快速恢复的agent系统,谁就更牛。
我咋给它下定义呢?
简单粗暴几句话:
Agent 的下一阶段,不是盯着它会说啥,而是盯着它能扛多久、多稳。 Harness就是那个让Agent不再是“闪光弹”,而是企业级“数字员工”的幕后支撑。
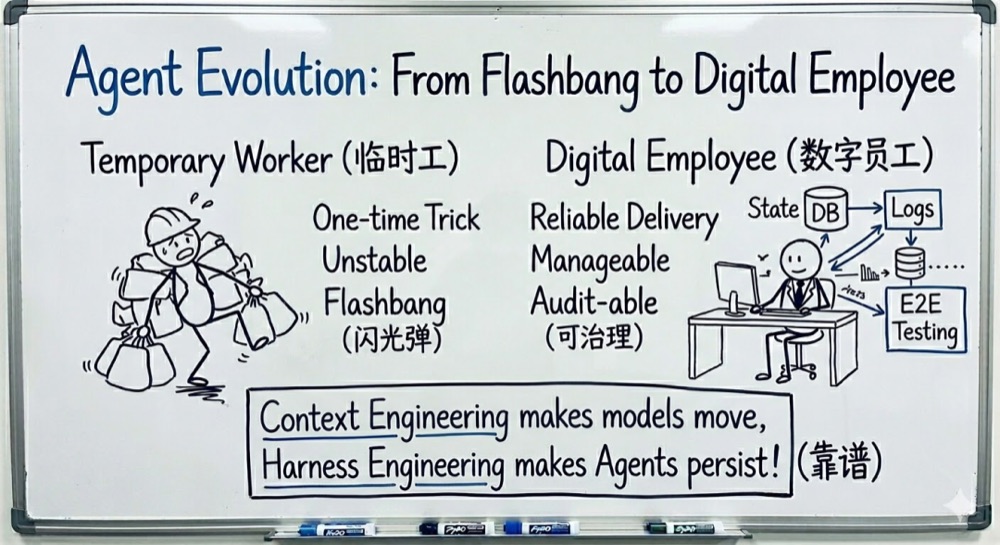
闪光弹 vs. 数字员工
或者更创业味儿点说:
Context engineering 让模型能动,Harness engineering 让Agent能撑住。
总结
Harness被吹成Agent新范式,是对的。不是因为发明啥超强模型,而是说,它把Agent从“能做点事”升级到了“能持续、可治理、可审计、真正落地”的坚实系统。
这对Agent真正走向广泛应用,是决定性的一步。
Harness is the New Dataset:模型智能提升的下一个关键方向
01. 为什么 Harness Engineering 开始变得重要?
从时间线看,AI 工程方法已经经历了三次演进:
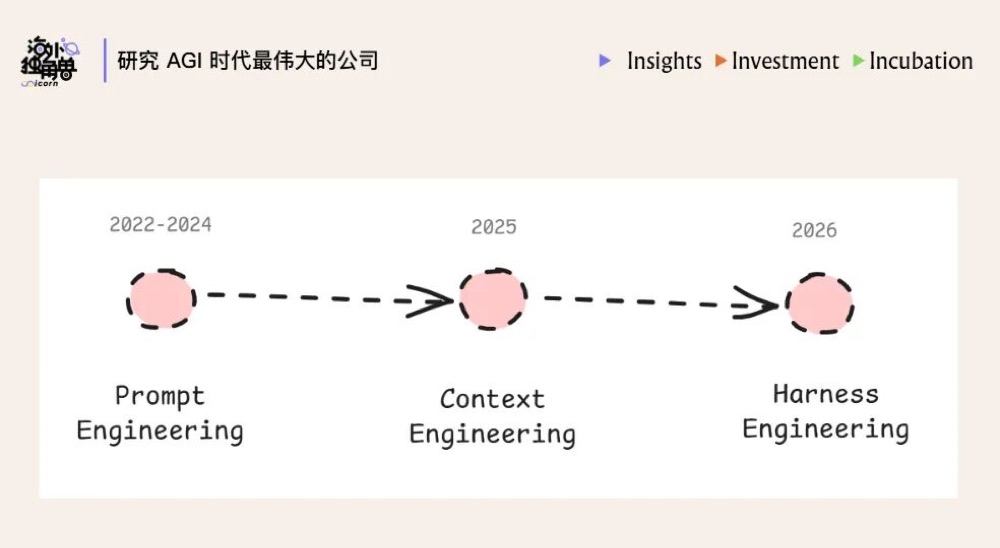
这几层演进背后的共同逻辑是: 一旦模型能力过线,瓶颈就会开始外移。
02. Harness 的 6 个关键组件
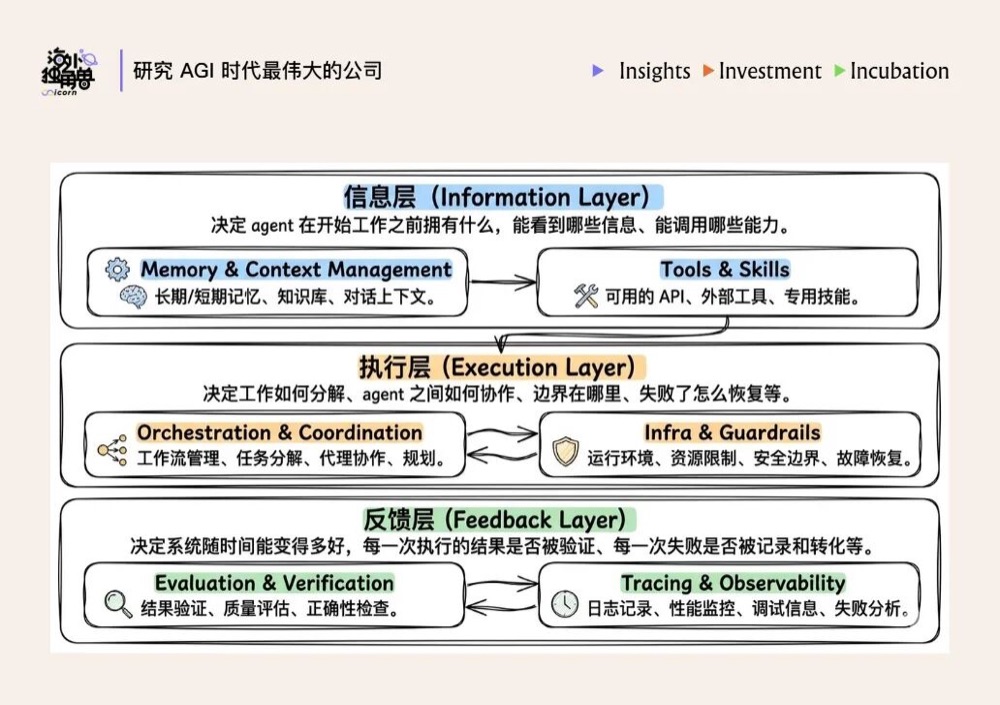
关于 harness 的组件目前在工程实践中还没有绝对共识,但综合目前看到的不同实践,我们认为它大致包括了以下 6 个部分:
1. Memory & Context management (记忆与上下文管理):
这一层解决的是“在当前时刻,Agent 应该看到什么信息”。常见做法包括上下文裁剪、压缩、按需检索,以及外部状态存储等。
2. Tools & skills (工具与技能):
负责扩展 Agent 的行动能力。工具提供可调用的外部能力,skills 提供可复用的任务方法。
3. Orchestration & Coordination (编排与协调):
也就是编排整套任务流程,协调每个 agent 的分工,决定何时规划、何时执行、何时交接,让复杂任务能被拆开、推进并收敛。
4. Infra & Guardrails (基础设施与保障):
负责提供运行环境和边界条件,包括沙箱、权限控制、失败恢复和安全护栏等,确保 Agent 能在真实环境中安全、稳定地运行。
5. Evaluation & Verification (评估与验证):
对于很多复杂任务来说,决定最终成效的往往不是第一次生成,而是有没有验证闭环。所以很多 harness 内置一套测试、检查和反馈机制,让 Agent 能自行验证自己的工作,并在发现问题后及时修正。
6. Tracing & Observability (追踪与观测):
负责还原 Agent 的行为过程,让整个黑箱变得尽量透明可见,例如提供执行轨迹、日志、监控和成本分析等能力。只有当这些过程是可见的,系统才是可调试、可优化、可管理的。
从完成一项真实任务的视角看,这 6 个组件其实对应着一条很清晰的链路:先准备信息,再推动执行,最后复盘结果。所以顺着这条逻辑,它们又可以进一步归成 3 层:信息层、执行层、反馈层。
举个具体的例子,Openclaw 的爆火很大程度上就是 harness engineering 的一次胜利:它并不依赖模型能力,而是完全靠 harness 的设计创造出了 aha monument。Openclaw 的核心亮点就是几个工程组件:
• Gateway 负责破壁,它把 WhatsApp、Discord 等社交软件统一对接给了模型,让小龙虾能像朋友一样出没在任意窗口。
• 内置 Skills 库提供了一个趁手的百宝箱,给了它丰富的能力集合。
• 记忆机制让它能持久地积累经验、不断进化。
• Heartbeat () 补齐了 AI 的“主观能动性”,让它能定时、自发地醒来干活。
• Soul.md 等身份文件则是画龙点睛,给这些冷冰冰的代码注入了一个鲜活的人格。
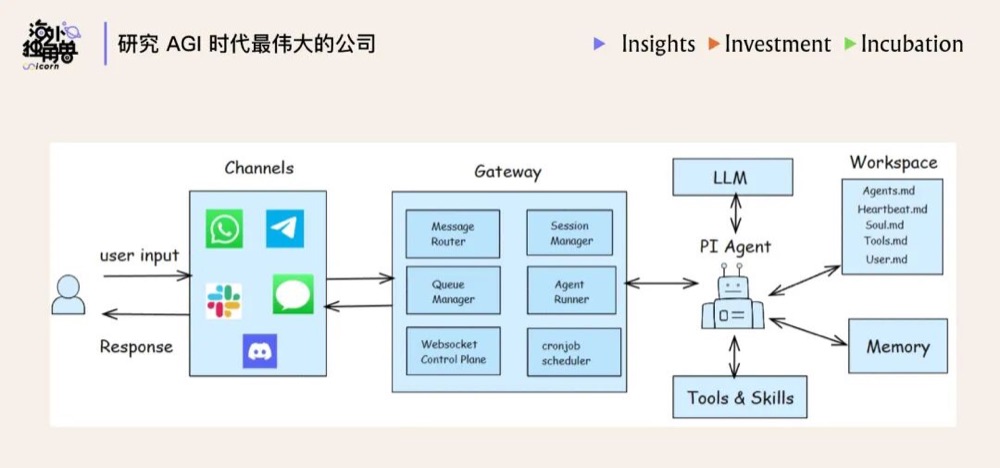
每个组件单看都不复杂,但当这些微小的创新被巧妙地糅合在一起时,跨平台的存在感、主动发起对话的意愿、持续进化的记忆——这些模型本身没有的生命力就出现了。
03.
Harness 的设计原则
这里我们尝试着总结一些 Harness engineering 的核心原则。它们不仅仅适用于 agentic engineer,也适用于每一个想用好 Claude Code () /Codex 的知识工作者 (如果你还没用上的话,还是强烈推荐大家试用一下,彻底改变工作范式!)
总体上,今天 Agent 最大的瓶颈还是 上下文长度的限制 ,所以 harness 的构建基本都围绕这条线展开的。而具体到信息层、执行层和反馈层,因为工程和任务目标的差异,又有着不同的设计原则:
信息层:帮 Agent 任务做资源准备
信息层解决的问题听起来很简单:给 agent 提供它需要的信息。但在实践中,这却是最容易犯错的地方,且错误原因往往不是给得太少,而是给得太多。因为模型存在 context decay (上下文衰减)的问题,随着上下文不断变长,模型并不是线性地 “知道得更多”,而是更容易被无关噪音分散注意力,导致对关键信息点的利用效率下降。
因此,信息层设计的核心原则是:精准,比求全更重要。落实到工程上,通常会对应到下面几种路径:
Trick 1 :渐进式披露
简单来说,就是把信息做成 “分层加载” 的系统,让模型在不同阶段只接触当下需要的那一层,而不是一次性把所有信息都塞给 AI。
比如,OpenAI 就曾试着用一个巨大的 AGENTS.md 把所有规则写全,但后来发现并不可行。Context 资源是极其稀缺的,一个巨大的指导文件会占据 AI 的脑容量,让它忽视真正重要的信息。
所以现在业内的最佳实践是通过文件系统来做分层披露,以 Claude code 为例,它把核心信息做了三层分级:
• Level 1 CLAUDE.md: 这一层只放最关键、最常用的元规则。它更像一个总入口,用来告诉模型:这个项目最基本的情况是什么,应该遵循哪些原则,不同类型的任务大概该去哪里找资料。
• Level 2 : SKILL.md: 这一层更像按需调用的小型能力包。只有在特定任务出现时,模型才会去加载对应的 skill,学习这项任务的做法。
• Level 3 : reference、supporting files、脚本等: 到这一层,模型接触的就不再是抽象原则,而是完成当前任务真正需要的细节:比如说明文档、操作示例、架构信息、日志、配置文件、测试命令,或者直接运行脚本后拿到的结果。
本质上,渐进式披露就是控制信息的出场顺序,让模型的注意力始终集中在当前最关键的 1% 信息上。
Trick 2:Tools 越少而精越好
这一点其实相当反直觉:随着模型能力的提升,它对外部工具的依赖应当是递减的,而不是越加越多。
Agent 的强大不在于工具箱里有多少把扳手,而在于它是否拥有几把完美的 “万能扳手”,以及如何高效地组合它们。与之相对的, 过于复杂的工具是模型幻觉的温床。 一个常见失败模式就是工具集越加越多,导致 agent 陷入决策瘫痪。
Claude Code 目前有大约 20 个工具,即使如此,他们团队也一直在审视是否真的需要所有这些工具,并且在非常谨慎地增加新工具。
Vercel 团队他们最初给 agent 配备了涵盖搜索、代码、文件、API 的完整工具库,结果表现很差;精简到只保留核心工具之后,速度和可靠性都显著提升。
Trick 3:找到 Context window 利用率的 “甜蜜区间”
很多独立的工程实践都得出了一个相同的发现:当上下文利用率超过一个区间之后,性能就会开始下降。也就是说,给 agent 塞太多历史记忆和背景信息,不会让它更强,只会让它更糊涂。
具体的 sweet spot 根据模型、context window、任务类型的不同会有差异,比如下图是一个最新的大海捞针测试,我们可以看到,当输入 token 数量从 256K 逐渐拉满到 1M 时,几乎所有主流大模型的表现都出现了明显下滑。
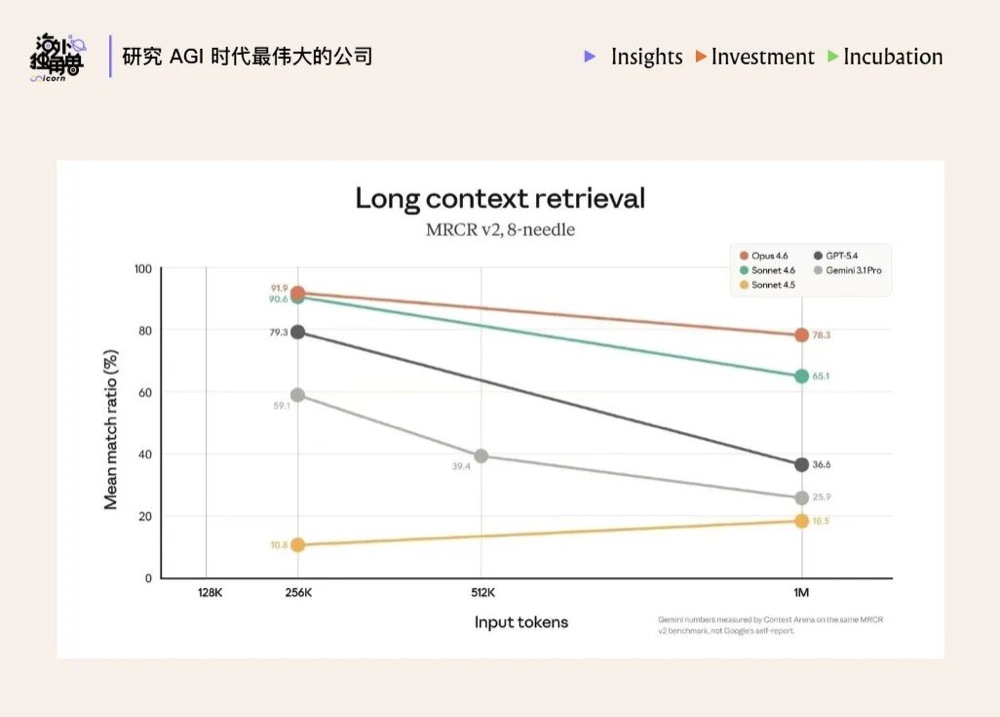
表现最好的模型 (Opus 4.6 系列),长上下文下还能维持七成的检索命中率,表现没那么稳的模型 (GPT-5.4、Gemini 3.1 Pro),命中率会直接掉到三成。
至于为什么有效的 context window 通常没有大家想象中那么长?一个核心原因是 Attention 的 “稀疏性”。随着 context 变长,模型的注意力会被摊薄到更多位置上。它虽然看见了更多 token,但未必还能稳定地把注意力放在最关键的那几个点上。如果关键的 bug 埋在中间,又有大量无关噪音干扰,它获得的权重可能不足以触发模型的警醒。
所以很多顶级工程师会频繁进行上下文压缩,把 context window 利用率控制在 60% 以下。
Trick 4:利用 subagent 做 context 隔离
当主 agent 的 context 开始变重时,把子任务分配给独立的 subagent 也是一个可行的方法。
每个 subagent 都在更小、更干净的 context 里完成自己的任务,少受无关信息干扰。等它们各自产出结果后,再回到主 agent 统一汇总和编排。
Claude Code 负责人 Boris Cherny 把这套方法叫做 context firewall 。当遇到复杂任务时,他会直接让主 agent “use subagents”,把看日志、查代码、搜文档这些事情并行拆开,主线程自己只做两件事:调度,以及收口。
执行层:给 Agent 一套执行规划
如果说信息层关心的是“给 agent 什么信息”,那么执行层关心的就是“让 agent 怎么做事”。这一层最常见的一个问题,是任务结构本身设计得不对。
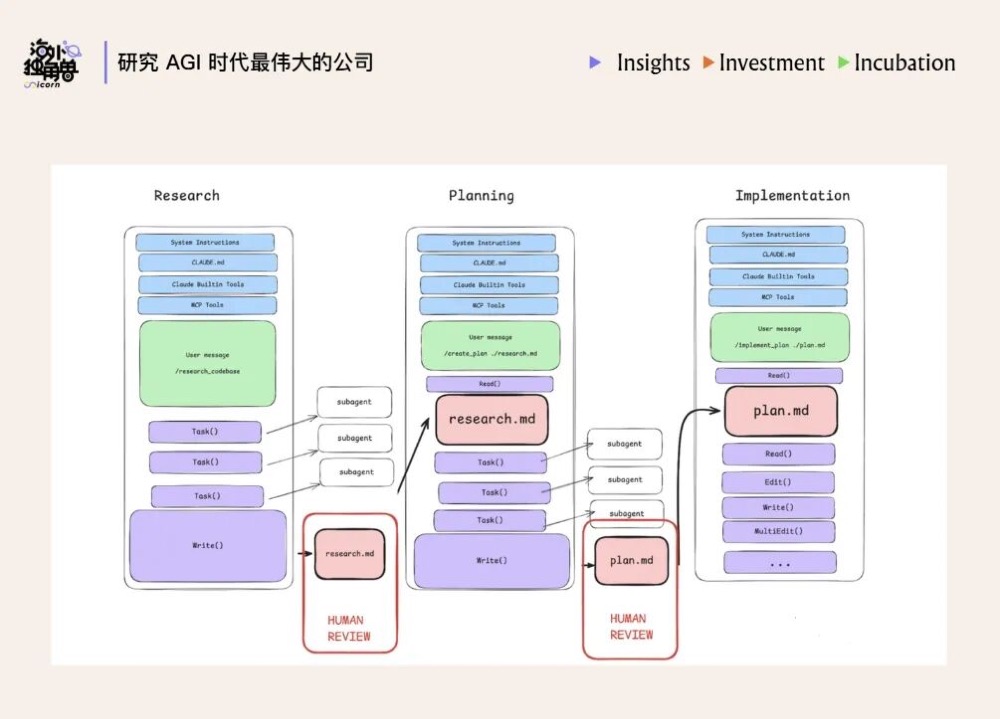
Trick 5:把研究、计划、执行、验证分开
我们在学习 top AI labs 的实践经验时,会发现一个很普遍的做法, 他们会刻意把一条任务链拆开,分成四步:research → plan → execute → verify, 每个阶段是单独的 session,有单独的 context,而不是期待它一气呵成。
这背后同样是因为,Agent 脑容量有限,把四个阶段压进同一个 context,本身会造成一些不必要的 context 污染。所以用尽量用更多算力,完成更简明清晰的任务。
举个例子,假设我们要给产品增加一个身份验证系统,最好不要直接下达一个指令:“给我做一个身份验证系统。”更好的做法是:
(1) 先开一个 research session,专门研究各种可能的实现方案
(2) 确定最终采用的行动方案 (可以你自己来,也可以让另一个 Agent 决定,Claude code 团队中有一个人的工作流就是:先让一个 Claude 写计划,然后再启动第二个 Claude,站在 staff engineer 的视角来做评审)
(3) 开一个全新的 session,专门负责执行这个具体方案
做其它类型的任务也是一样,先让 Agent 研究最佳实践,再列出详细的执行计划,最后执行,效果往往更好。
Boris Cherny 的 CLAUDE.md 里就有一条明确的规则:
Enter plan mode for ANY non-trivial task (3+ steps or architectural decisions). If something goes sideways, STOP and re-plan immediately — don't keep pushing.
(只要任务不算简单,比如步骤超过 3 个,或者牵涉到架构层面的判断,就先做规划。一旦发现哪里不对,就立刻停下来重新做一遍规划,不要硬往下推。)
他在 26 年 1 月还又做了一层强化:用户接受计划之后,Claude Code 会自动清空 context,让执行阶段从一个干净的起点开始。他的观察是,执行阶段如果继续背着研究阶段留下的大量上下文,很容易被噪音干扰;反过来,把研究和执行切开,反而更能保证计划被准确落实。
Trick 6:人最该介入的地方,不是事后审核,而是事前规划
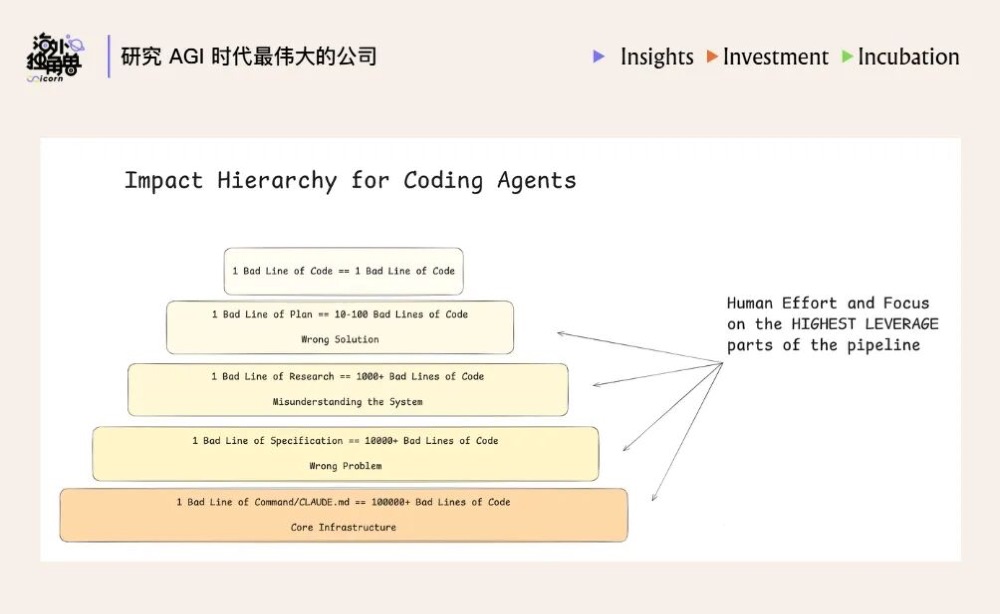
绝大多数人类用户只喜欢验收结果,而不重视前期的规划设计,但实际上,人恰恰应该把精力从事后的 code review,尽量前移到 research 和 plan 这两个杠杆更高的环节。因为一行糟糕的代码,影响的可能只是一行;一行糟糕的计划,往往会长出几百行糟糕的代码。
越是上游环节,带来的单位时间的影响越大。
反馈层:Agent 的复利飞轮
前两层决定了 agent 能做什么,反馈层决定的是系统随时间能变得多好。这是三层里最容易被忽视、也最能产生复利效应的一层。 反馈层的核心逻辑,其实就是 harness engineering 这个概念最原始的定义。Mitchell Hashimoto 在自己的 blog 中是这么写的:
Anytime you find an agent makes a mistake, you take the time to engineer a solution such that the agent never makes that mistake again.
这背后是一种工程纪律:每一次失败都不是终点,而是一次让系统永久变好的机会。他的做法是,每一次真实翻车的问题,都会被他尽量记到AGENTS.md 里。包括 Claude Code 团队也会全员共同维护一个 CLAUDE.md,只要 Claude 做错了一件事,就把这条经验补进去,让它下次不要再犯同样的错误。
Trick 7:构建反馈闭环
在 Harness Engineering 中,最能产生复利效应的投入,就是为 Agent 构建一套自动化的反馈与校准机制。
Boris Cherny 分享过一个数据:只要给 Claude 提供有效的验证手段,其最终产出的质量通常能提升 2-3 倍。他的做法包括:
• 任务完成后,提醒另一个 agent 验证结果,或者开启 stop hook 自发校验。
• 用 ralph-wiggum 插件把整个流程改成“自动迭代模式”,让 Claude 不断做、不断验、不过就继续,直到满足完成条件。
• 让 Claude 自己打开浏览器、测试 UI、反复迭代直到 UX 过关。
Karpathy 最近提出的 autoresearch 的思路同样很有启发。
Autoresearch 的重点不是让 AI 一次性想出最好的答案,而是让 AI 进入一个可控闭环:自主提出 idea → 做实验 → 观察实验结果 → 保留有效策略、丢掉无效分支→ 反思后继续提出不一样的改进策略 → 如此反复循环。
这其中,重点不在于单次输出能有多惊艳,而在于能不能给它设计一个能不断筛选、充分迭代的回路。而这类回路不仅仅是适用于 research,也适用于大多数提高转化率、点击率、分数指标的场合。
04.
模型 vs harness,究竟是怎样一个关系?
关于 harness,所有人都在好奇的一个问题是:模型会吃掉脚手架吗?harness 当下创造的价值多大程度上会被模型厂自己做掉?例如 Claude Code 和 Codex () ,本质上其实就是模型公司的竞争已经从单纯的模型层,转向了 “模型+harness” 的整体。
这个问题很难在今天直接给出一个明确答案,因为模型和 agent 实践的变化相当迅速。但可以确定的是,模型和 harness 的耦合程度是比多数人想象得要深的。
训练即部署
Agent 能力的上限,越来越由环境质量决定,而不只是模型本身, 所以在 agentic RL 的训练逻辑里,模型和 harness 从一开始就不是分开设计的。
如果没有参与过 agent 开发,那么大多数人对于“开发一个 agent”这件事的第一反应可能是:先训练一个能力过关的模型,再给这个模型接工具、接工作流等等。也就是说,模型是主体,harness 是后装件。
但 agentic RL 的训练逻辑和这个直觉正好相反。普通 chatbot 的 RLHF 是单轮的,奖励信号密集,反馈直接。Agentic RL 则非常不同,它涉及到:
• 多轮、长链路、带工具调用 (且一次 rollout 可能调用上百次工具)
• 动作空间极大
• 奖励信号非常稀疏,复杂任务可能 1000 次尝试才成功一次
• 很依赖真实环境中的反馈,比如测试有没有通过、代码跑没跑起来、lint 报没报错
……
这也意味着,训练效果在很大程度上取决于 “训练场设计得好不好,像不像真实世界” 。模型在训练阶段看到什么,往往就是它上线之后真正要面对什么。它在训练时用的是同一套工具、同一种终端、同一类沙盒,接受的也是同一类反馈。
比如,Cursor 在训练 Composer 1.5 时,用的几乎就是一套面向真实用户服务的 coding 环境。它会并发跑数十万个沙盒,让模型在里面反复试:先搜什么,读哪些文件,改多少代码,什么时候该停下来做验证。
在这个过程中,他们发现模型自发涌现了很多能力:
• 它开始学会在复杂代码库里做更深入的搜索
• 会顺手修掉 linter 错误
• 会自己补单元测试,再执行验证
• 也会从一开始动不动大改一片,慢慢转向先多读、少乱改
Windsurf 在训练 SWE-1.5 时,表达得更直接。他们在技术博客里写道:
“We believe that the quality of the coding environments in RL tasks is the most important factor for downstream model performance.”
(我们认为,在 RL 过程中,coding 环境本身的质量,对模型最终表现的影响是最大的。)
“Our vision is to co-optimize models and harness: we repeatedly dogfooded the model, noticed issues with the harness, made adjustments to tools and prompts, and then re-trained the model on the updated harness. ”
(我们的思路是把模型和 harness 当成一个整体来共同优化:一边反复使用模型,一边暴露 harness 中的问题,再去调整工具和 prompt,最后基于新的 harness 继续训练模型。)
Harness 的很多能力,在快速被模型吸收
理解了“训练即部署”这件事,就能理解 harness 为什么是一个奇特的行业:它一边创造价值,一边把自己的能力源源不断地输送进模型本身。
现在模型公司都在把 “模型 + harness” 当成一个整体来优化。很多原本属于 harness 的能力,已经被模型逐渐内生化,比如 tool search、programmatic tool use、compaction / summarization、多步工具调用策略等。这件事通常是这么发生的:
• 模型团队和社区用户在前线摸索,试出哪些方法真的有效;
• 随后训练团队把这些模式拿去做 post-tarining,
• 在这一过程中,模型开始把这些能力慢慢内化,一部分原本必须靠 harness 强行维持的能力,开始变成模型自己的能力;
• 新的 harness 又被重新设计出来支持新的模型能力...
• 如此循环往复。
如今的很多 harness 能力,比如 planning、self-verification,也都在公开采访里被透露过,可能会成为未来后训练的候选方向。
Claude Code 负责人 Boris Cherny 也说过,Claude Code 的 harness 在不断被重写,里面每行代码的保质期可能也就 2 个月。
Harness 即数据
Deepmind 的 Staff Engineer Philipp Schmid 有一个金句: “The Harness is the Dataset. Competitive advantage is now the trajectories your harness captures (Harness 本身就是数据集。现在真正的竞争优势,在于你的 harness 能捕获到怎样的执行轨迹) .”
现在真正有价值的数据,不再只是静态语料,还包括了 agent 在具体业务流程中跑出来的执行轨迹:它看到了什么信息,使用了什么工具,做了什么决策,哪一步容易出错,什么反馈会让它变得更好。
在这种情况下, harness 不再只是模型外面的脚手架,而是模型能力生成的土壤,土壤的质量,会一定程度上决定和反哺智能的生长。
以 Anthropic 为例,它在 harness 上的探索比 OpenAI 领先了一段时间,但就是这几个月的窗口期给了它巨大的机会。
现在市场的情况是:即使目前的模型水平两家已经基本打平了,但大多数人依然在用 Claude Code。
同时,模型和应用的竞争也呈现了一种很有意思的态势,头部的模型公司在端到端做 harness,而应用公司也越来越多开始自己训模型。
我们发现现在湾区已经有很多大的 AI 应用公司 (远不只是 coding 方向) 在搭建自己的 continuous learning 平台,基于自己的 harness 和业务数据,做开源模型的 RL,并且已经开始从头部 AI labs 迁移模型用量。
他们认为,在很多垂直场景里,今天的开源模型能力已经够用了。接下来的差距,未必来自谁有更好的模型,而是来自谁能围绕具体任务,把模型、任务结构、反馈闭环和后训练结合得更好,在特定场景里做出成本更低、效果更好的系统。
这种竞争格局,可能会成为接下来几年 AI 竞争里最有趣的看点之一。
05.
创业公司的机会
随着 harness 的重要性逐渐提升,我们相信这个领域也会有一些创业公司的机会,以下整理了一些比较有代表性的,势头非常好的项目,他们最近也都拿到了知名机构的大额融资。
信息层
今天企业应用 AI 的最大瓶颈之一,是 agent 没有充分的背景信息,所以怎么以 agent 为中心抓取出企业里原本分散的、隐性的知识,会是一个新的创业机会。我们尚不确定它最终能不能成长为一个大的独立赛道,但这些玩家起码是 2B 巨头们很好的收购标的。
代表公司:Edra
Edra 把自己定位为 “Context for Agents at Scale”,专注于把企业里分散的流程知识变成 agent 可执行的动态上下文,会自动读取企业现有的 tickets、logs、emails、chat histories 等数据,然后并行运行数千个智能体来探索这些数据、模拟决策并综合得出反向推理流程,还原公司真实的做事流程,再整理成一套 agent 可以复用的 playbooks。官方 slogan 是 “Edra learns how your business operates. Then automates it.”
今年 3 月,公司完成了约 3000 万美元 A 轮融资,Sequoia 领投。
执行层
方向 1 : Workflow orchestration/durable execution
代表公司:Temporal
Temporal 是做 Durable Execution 的底层 infra,简单讲就是让很长、很复杂、很容易失败的任务,依然能稳定跑完。中间哪怕服务器挂了、网络断了、任务等了三天,它也能记住执行到哪一步,然后从断点继续。
未来随着 Agent 需要完成越来越复杂,长时的任务,尤其是当未来成千上万个 Agent 要互相通信和交易时,对状态管理与失败恢复的要求会越来越高。这种分布式系统的运维非常复杂,而 Temporal 在这方面有深厚的技术积累和很强的先发优势,所以签下了 OpenAI、Replit、Netflix、Stripe、Datadog、Snapchat、JPMorgan 等很多大客户。
26 年 2 月,公司完成了 3 亿美元 D 轮融资,a16z 领投,估值 50 亿美元。
方向 2 : Security/Governance
代表公司:Oasis Security
Oasis 是面向 agentic enterprise 的权限管理平台。它想解决的问题是:现在企业里越来越多去访问系统、调用数据的,是 AI agent。但很多公司并不清楚这些 “数字身份” 到底有多少、分别在做什么、权限是不是开得太大、出了问题又该找谁负责。Oasis 就希望帮企业建立一套安全管理系统,让 agent 能拿到完成任务所必要的权限,但同时又不产生过多风险,并且让整个过程可以被追踪和控制。
26 年 3 月,完成 1.2 亿美元 B 轮融资,Craft Ventures 领投,Sequoia、Accel 等跟投,估值 7 亿美元。
方向 3 : Sandbox
代表公司:Daytona
Daytona 做的是 agent 的沙箱基础设施。它和 E2B 的区别在于,E2B 更像“给 agent 一个安全的执行盒子”,Daytona 更像“给 agent 一台可长期使用的电脑”。
至于为什么这个节点需要 Daytona 这类沙箱?核心是因为最近这一波产品,比如 Claude Code、Codex,把新的 agent 产品形态带火了,ai 开始需要真的像员工一样有一个 workspace 持续工作,就会催生一层专门的沙箱基础设施,这个环境不是一次性跑完就销毁,而是 stateful的,能让 agent 展开更长周期、更复杂的工作流。
2026 年 2 月,公司完成 2400 万美元 A 轮融资,FirstMark 领投,Pace、Upfront、Datadog、Figma Ventures 等跟投。
反馈层
Evaluation&Obervability 也是我们相对看好的一层,原因有三点:
1. 企业需要一层独立的质量控制面板,通过它看到真实调用链路、比较不同模型和版本。(虽然 OpenAI 和 Anthropic 的企业级平台也都在内置 eval、trace 的能力,且未来有一天也可能支持接入第三方模型,但对企业来说,底层模型和评测体系如果都出自同一家,始终会有顾虑,所以它相对不容易被模型厂吃掉)
2. 这是当前 AI 企业的刚需痛点,且未来随着 Agentic 层的复杂度变高,Agent 完成的任务变长,对 observability & evaluation 的要求也会越来越高、越来越精细。
3. 这一层通常会深度嵌入企业的 AI 工作流。它不只是一个看板,而是会进入数据采集、评分标准、版本发布和回归测试流程。接进去之后,替换成本往往不低。
代表公司:Braintrust
• 产品:
定位是一个给 AI 产品团队用的 AI observability / evaluation 平台。产品可以简单理解成三步:
(1) 看清过程。Braintrust 会把 AI 应用在生产环境中的请求记录成 traces,帮助团队看到一次调用里具体发生了什么,包括用户输入、模型输出、中间步骤、延迟,以及 token 和成本等信息,从而定位问题到底出在哪一层。
(2) 判断好坏。团队可以用人工标注、规则或 LLM scorer 对结果做评分,判断回答质量。Braintrust 同时支持离线实验和线上打分,让团队既能在发布前测,也能在真实流量里持续监控。
(3) 持续优化:把线上真实出现的问题沉淀成测试集,用来比较不同 prompt、模型等产生的不同效果,帮助团队方便地调试和打磨产品。
• 融资:
26 年 2 月,完成 8000 万美元 B 轮融资,ICONIQ 领投,a16z、Greylock、Elad Gil、Basecase 等跟投,估值 8 亿美元。
06.
What's Next?
如果把 prompt engineering、context engineering 和 harness engineering 放在一起看,它们其实很像一个初级员工的成长过程。
最开始,你只能和他做简单问答;再往后,你可以把完整的业务背景交给他,让他独立完成一轮深入调研;再往后,你开始给他工具、权限和反馈机制,让他自己拆任务、调工具,甚至带着几个 subagents 一起干活。
那我们不禁在想,再下一个范式会是什么?
在人类现实职场中,大部分人都会有相对明确的 career path:从一名初级员工,逐渐积累经验,甚至升级为一个高管,从执行者变成规划者,带领几十个下属完成一个高度复杂的项目。
如果沿着人类员工的经验做一个自然推演,那么下一阶段 Agents 需要达到的,大概也是协调无数 agent / 人类节点共同完成复杂任务。
我们或许可以暂且叫做 —— Coordination Engineering。
OpenAI 的工程负责人和产品设计师在 1 月底的一期播客采访里,也多次提到了他们在思考 multi-agent networks。
“我不方便讲太多 roadmap,不过有一个挺值得思考的问题是:一旦进入 multi-agent 世界,复杂度会迅速上升,那你怎么才能管理这一切?用户怎么才能始终知道每个 agent 在做什么、执行了哪些动作、流程推进到哪一步,以及中间哪些地方需要自己介入、授权或纠偏?”
所以从这个角度看,下一代 AI 产品未必是一个更聪明的小龙虾,而更像一个小龙虾版飞书,本质是一个有效的监工看板 + 一个能让各种节点有效协作的 im 平台。
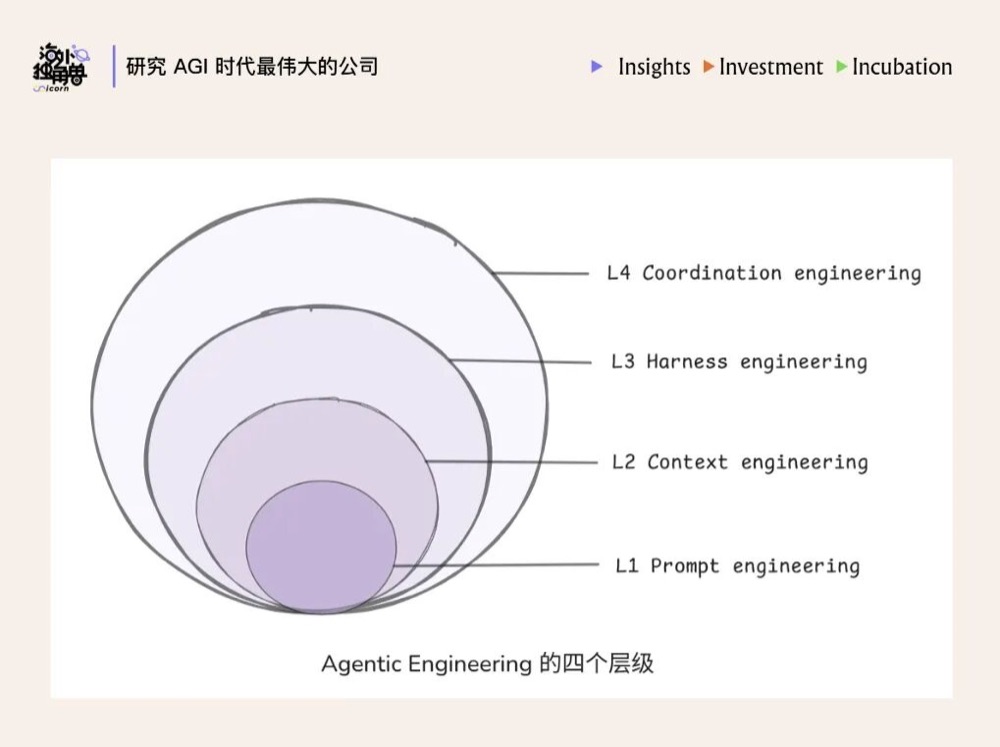
最终这四个层级叠加起来,可能就构成了 Agentic engineering 的终极范式。它们之间不是一个替代关系,而是一个包含关系,智能的水位涨上来,“控制面" 就开始不断上移:
• L1 解决问答质量
• L2 解决认知边界
• L3 解决执行闭环
• L4 解决组织协同
再往终极推演呢?一切似乎就只剩下了 intention engineering,人的价值只剩下了 “设定目标函数”,其余 AI 都可自行包揽。
到那时候再回头看,所谓的白领工作,可能真的是人类历史走过的一段弯路。
长时自主Agent,先解决这8个Harness核心问题
本质上,所有 Harness 设计都是在对抗两类问题:agent 要么开始偷懒、走捷径,要么开始迷糊、犯蠢。有些问题比另一些更难修,但一个写得好的 Harness,确实能解决很多事。
agent 会怎么犯蠢
任务前:上下文没吃够 (Pre-Task)
Agent 在任务开始前没有拿到足够上下文,于是还没正式开工,就已经建立在错误信息或缺失信息上行动了。
要解决这个问题,你需要在任务开始前,系统性检查信息是否不完整、是否互相矛盾。因为一旦开工,这些问题只会一路传染下去。
规划阶段:上下文不完整 (Planning — Incomplete Context)
这一步是 agent 决定用什么路径解决问题的时候。这里最大的风险,是它选错了攻击路径,最后做出来的东西从根上就是错的。
现在单纯因为“蠢”而选错路径,其实已经不算常见了。更常见的是对齐出了问题,也就是它误解了用户到底要什么。
要解决这个问题,你得确保 agent 在开始规划前,已经把所有相关文件都覆盖到了。这里还有个关键前提:你的仓库里不能存在互相冲突的信息。
规划阶段:短期思维 (Planning — Short Term Thinking)
Agent 不会承担那些短期、速成方案带来的后果。这就像雇了廉价软件劳动力,你可能拿到一个“能跑”的东西,但技术债会越滚越大。
解决方法,是在规划阶段反复提醒 agent :它要做的是一个能扩展、能融入整体、易维护、并且尊重良好软件工程范式的方案。说白了,你希望它像创始人一样思考,而不是像一个只想赶紧交差的兼职工程师。
你还可以让 agent 先产出 N 个不同方案,比如 N=5,再交给另一个 agent 去选那个更易维护、在 clean code 原则上得分更高的方案。
任务执行阶段的陷阱
任务阶段:上下文焦虑 (Task — Context Anxiety)
这一步是 agent 真正开始动手解决问题的时候。到目前为止,最大的问题,远远是上下文耗尽。
如果规划足够好、上下文也给对了,现在几乎所有前沿模型 agent 都能以接近 one-shot 的能力,完成足够小的任务。真正出问题的场景,通常是那种复杂、多会话、会消耗数百万 token 的任务。
我之前也写过,几乎所有 agent 都有某种“上下文焦虑”。随着时间推移,它们会越来越急着结束这次会话。Claude 在这方面尤其明显。要解决这个问题,你需要做聪明的 session handoff,把上下文负担从当前 agent 身上卸下来。然后你会遇到一个新问题:怎么让交接时的上下文保真度尽可能高。
你需要确保 handoff prompt 里有足够多的细节,让新会话里的新 agent 能以高信息密度的方式,接住所有继续推进任务所需的内容。要明白,你这里做的,本质上就是一种压缩。之所以有理由相信你能做得比模型提供方原生压缩更好,是因为你比基础模型提供方更了解自己的仓库结构。
任务阶段:偏离计划 (Task — Planning Deviations)
除了上下文膨胀,第二大的问题,是我称之为 planning stickiness 的东西。也就是,agent 偏离了原计划,最后基本在做自己想做的事。
最常见的表现是:你让它做 A,A 很长、很痛苦,也很复杂。结果它做了 A'。它会觉得 A' 和 A 已经挺接近了,但实际上,A' 根本不可能把你带到目标位置。
这不只是结果不好,更麻烦的是,软件本身是可组合的。于是所有依赖 A 的下游代码,现在都会开始围着 A' 接线。那从 A' 往后长出来的一整串东西,本质上都会是错的。
要解决这个问题,你得尽早验证,而且要频繁验证,确认任务方案是不是被正确实现了,是否符合你的预期。这样可以挡住任务列表里的级联故障。
任务阶段:对复杂度的恐惧 (Task — Complexity Fear)
Agent 对复杂度有很深的恐惧。
你让它写一个 5 行函数,通常没什么问题。但如果它觉得自己将要写的是一个 5 万行的类,它就会开始想办法滑过去。
最糟糕的表现,一种是随手写几个 stub 就算交差。更糟的是,直接宣布这件事超出本次会话范围,然后结束。
我最好的猜测是,在 RL 过程中,agent 学会了这样一件事:处理高度复杂的任务时,它往往会犯很多错,而且会因此受到很重的惩罚,所以它会激进地回避这类任务。
讽刺的是,人类也有这个问题。大多数人一想到一个项目有多大工作量,就会无限拖延。生产力教练通常会说,解决办法是从这个任务最简单的版本开始,也就是先做第一步。这样启动能量几乎为零,你会立刻从“准备开始”切到“已经在做了”。
Agent 也差不多。你需要把复杂问题拆成很多看起来没那么吓人的子任务,让每个任务都控制在百行以内,然后把 500 个这样的小任务串起来。
一个很有意思的副作用是,如果你研究过生产力方法,也真的实践过它们,你会发现这些方法拿来管理 agent 一样有效。这会让人非常清楚地意识到,agent 心理其实就是照着我们自己的样子长出来的。
任务完成后的问题
任务后:验证偷懒 (Post-Task — Verification Laziness)
Agent 会选最短的路径做验证。它会写一些很弱的测试,看着这些测试通过,然后以此宣布任务成功。
上下文压力越大,这种“验证一下就行”的行为就会越离谱。最糟糕的情况是,假设你有个函数应该实现行为 A,agent 却给行为 A' 写了测试,看见测试通过,就宣布这个函数工作正常。
缓解方式,是确保负责写验证测试的那个 agent ,拥有尽可能新鲜的上下文,而且它本身就是一个专门规划验证方案的独立 agent 。然后更重要的是,你要验证的,必须是你真正想上线到生产环境里的那种精确行为。
这意味着,如果你在测试前端某个按钮是否能工作,不要去测试“一个通用按钮是不是能工作”。你要想的是,到底怎样才算真的知道这个按钮是好的:
你需要看到一张截图,确认这个按钮真的在页面上。
你需要真的去模拟点击这个按钮。
这个按钮需要触发后端,发出它本来就该发出的 payload。
在你能证明某个东西真的工作之前,它就不算工作。相信我,我和 agent 打交道已经够久了,这句话我是很有把握才会说。
任务后:熵最大化 (Post-Task — Entropy Maximization)
就目前来看,agent 写出的代码通常只是勉强能接受,而且不会主动帮你降低仓库里的熵。
常见情况是,它把函数 X 从行为 A 改成了行为 B,但所有文档还在写行为 A。你的 agent 不会顺手把这些东西一起修掉。
这种情况重复 100 次以后,你就会得到一个完全不可维护的仓库。然后你的 agent 会一直被搞糊涂,并不断做出糟糕决策。
最好的解决办法,是在每次长会话结束后,专门分配一些 token 给一个拥有新鲜上下文的 agent ,让它负责清理状态、消除矛盾、处理 merge conflict、删除死代码和过时文档,等等。
为什么要自己做 Harness
在原生 Harness 里,能用来解决上面这些问题的工具,其实很有限。比如 Codex () ,连 hooks 都没有。
更重要的是,如果你让 Claude 在你的 Harness 里充当 orchestrator () ,它自己会被大量与实际任务列表无关的编排上下文撑得很臃肿。你真正想要的,是把 agent 编排层放在任务列表之上,而不是混在任务执行里面。
比如,你可以有一个 agent ,它唯一的职责,就是确保每个 session 都带着一份必须被满足的 algorithmic contract 才能结束。这个 agent 会持续监控 contract 的状态,提醒其他 agent 别偏离 contract,还会额外拉起拥有新鲜上下文的独立 agent ,去判断当前工作质量,并独立验证任务是否真的 done。
当你拥有自己的独立 Harness 时,你就可以设计出专门针对“agent 会怎么犯蠢”这些问题的工作流。
如果你发现,基于你的工作类型,agent 经常因为复杂度而退缩,那你就可以加一个 agent ,专门判断当前 prompt 会落成简单项目,还是高复杂度项目。如果判断为高复杂度,再拉起另一个 agent ,把项目尽可能拆成一口一口能吃掉的小任务,直到最终产出仍然对齐原始 prompt。
如果你发现,agent 没有把仓库维护在一个好状态里,那你就可以在每次 session 结束时,再拉起一些 agent ,去分析本次改动的 blast radius,并确保这次改动触及到的所有内容都没有自相矛盾,也足够干净。至于“干净”怎么定义,可以由你自己定。
最后,也是最重要的一点,你要把 agent 编排层接收和产出的所有内容都做详细遥测,包括 prompts、traces、outcomes,然后设计 rubric 去评估你的 Harness 质量。迭代才是王道,这会让你一点一点逼近更好的 Harness。
OpenForage Harness
顺带一提,我们自己做了一套非常强主张的 Harness,用一种明确而主观的方式去解决上面所有问题。我们对它很自豪,它也已经成了我们日常编码的主力工具。经过很多年的迭代后,等它准备到适合公开使用的时候,我们会把它开源。
结论
对绝大多数人来说,从原生功能出发,先做一套朴素配置,其实已经够用了。
但如果你需要从 agent 那里榨出更强的火力,这篇文章想做的,就是把你在长时运行的自主工程项目里大概率会遇到的问题,尽量提前说清楚。
AI Harness 工程:Agent 能跑起来的那一层到底是什么?
关于构建 AI Agent,业界通常谈的是三种架构路径:SDK、Frameworks、Scaffolding。这三种方式各自站在灵活性与结构性的不同位置,也各有适用场景。
但 2026 年悄悄冒出了第四种模式,而且直接架在这三种之上——它叫 Harness 。
Harness 到底是什么?
先把一件事说清楚: Harness 不是 Agent 本身 。
它是管理 Agent 如何运行的那套软件系统,负责处理完整的生命周期——工具调用、内存、重试、人工审批、上下文工程、子 Agent……让模型可以专心做推理,其他的一概不用操心。
Philipp Schmid () 用了一个很贴切的计算机类比来解释这件事:
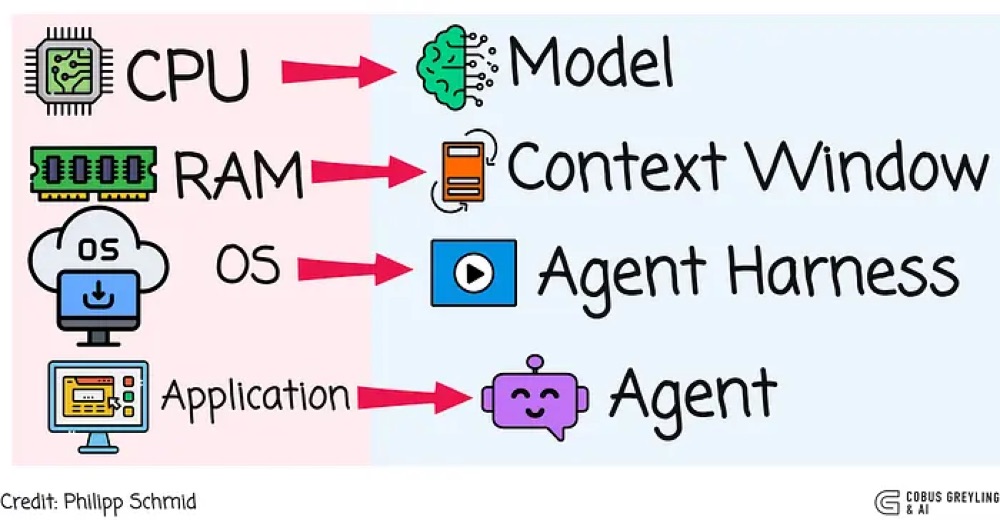
模型是原始的处理能力,上下文窗口是有限的工作内存,而 Harness 就是操作系统——管上下文、管初始化序列、管标准工具驱动。Agent 则是跑在这一切之上的应用程序。
这个比喻非常准,一下子就把关系理清楚了。
它跟 SDK、Framework、Scaffolding 是什么关系?
SDK、Scaffolding、Framework 回答的是同一个问题: 怎么把 Agent 造出来?
Harness 回答的是一个完全不同的问题: Agent 造出来之后,怎么让它安全、稳定地跑?
这两件事不是替代关系——你完全可以用 Framework 来构建一个 Harness,它们处于不同的层次。四种方式的对比关系如下图:
Harness 有哪些核心组件?
parallel.ai 的团队梳理出了六个核心组件,这也跟 OpenAI 和 Anthropic 官方发布的内容高度一致:
工具集成层 ,通过定义好的协议把模型接入外部 API、数据库、代码执行环境和自定义工具。
内存与状态管理 ,多层内存体系——工作上下文、会话状态、长期记忆——在单个上下文窗口之外做持久化。Anthropic 的做法是用进度文件和 git 历史来桥接不同的会话,让 Agent 在切换任务后还知道自己在哪、做到哪了。
上下文工程与提示管理 ,不是一堆写死的提示模板,而是根据当前任务状态动态决定每次模型调用时塞进去什么信息——主动选择,而不是全部照单全收。
规划与任务分解 ,引导模型一步一步走结构化的任务序列,而不是试图一口气搞定所有事情。
验证与防护 ,格式验证、安全过滤、自我纠错循环。当 Agent 卡住的时候,Harness 把它当成一个信号——说明有什么东西缺了,而不是直接报错崩掉。
模块化与可扩展性 ,各个组件可以独立开关、独立替换,插拔式设计,改一个不影响其他的。
真实生产中的 Harness 长什么样?
Claude Code () 就是一个典型的 Harness。
它读取整个代码库,管理文件系统访问,调度子 Agent,处理工具编排,跨会话维护内存,还内置了各种防护。开发者只需要专注于任务本身,其他的 Harness 全部兜着。
OpenAI Codex 也是。
他们的团队用这套 Harness 工程方式,搭出了一个超过 100 万行的代码库,全程没有一行手动输入的代码。Harness 是主要接口,当 Agent 遇到问题,反馈会直接流回代码库,推动上下文工程和架构约束的持续迭代。
OpenAI 的 CUA 示例应用 (计算机使用场景下的 Harness)中,Runner 管理的是"截图 → 操作 → 验证 → 再循环"这个完整闭环。模型负责决定做什么,Harness 负责安全地把它执行出来。
Framework 层正在被 Harness 吞掉
有一个很值得关注的趋势:传统 Framework 处理的那些事情,正在被模型本身吸收。
Agent 定义、消息路由、任务生命周期、依赖管理、生成工作进程——以前开发者用 Framework 来搞定这些,但现在大约 80% 的这类功能,模型已经原生支持了。
剩下那 20%——持久性、确定性重放、成本控制、可观察性、错误恢复——正好是 Harness 负责的部分。
Framework 层不只是在消失,它在分裂: 智能进入模型,基础设施进入 Harness。
Harness 与 Framework 的核心区别也很清晰:Framework 告诉开发者怎么构建应用,Harness 告诉 Agent 怎么安全运行。用 Framework 时,开发者写编排逻辑;用 Harness 时,模型自己制定计划,Harness 保持它不翻车。
现在构建 AI Agent,问题变了
以前大家问的是:用哪个 Framework?
现在更关键的问题是: Harness 应该长什么样?
Harness 决定了 Agent 是成功还是失败。好的 Harness 能管住人工审批、文件系统访问、工具编排、子 Agent、提示和完整的生命周期,干预最少,但能挡住灾难性失败。
落地建议也很实在:从简单的地方开始,先把原子工具做扎实,让模型来制定计划,再逐步加上防护、重试和验证机制。这就是 Harness 工程的基本思路。
最后说一种特殊形态
值得单独提一下的是 Markdown/Prompt Harness ,比如 Anthropic 的 CLAUDE.md 技能文件,它把编排指令直接嵌进系统提示或结构化的 Markdown 文件里。
这种方式下,LLM 本身就成了循环控制器——它读取 Harness 规则,然后照着执行。当模型足够强、能做到自我引导,而且你需要快速迭代、不想每次都改代码的时候,这是个相当好用的选择。
Harness Engineering 深度解析
2026 年 2 月," Harness Engineering "这个词突然在 AI 工程圈子里火了起来。 Mitchell Hashimoto 在博客里提了这个说法, OpenAI 紧接着发了百万行代码的实验报告,Martin Fowler 也跟进写了深度分析——几周之内,这个术语就成了讨论 AI Agent 开发绕不开的话题。
第一部分:什么是 Harness Engineering
1.1 三层工程概念的关系
Harness Engineering 并不是凭空出现的,它是 Prompt Engineering 和 Context Engineering 的自然延伸。三者构成嵌套关系:
Phil Schmid 打了个比方:模型是 CPU,Harness 是操作系统——CPU 再强,OS 拉胯也白搭。mtrajan 的区分更直接:Context Engineering 管的是"给 Agent 看什么",Harness Engineering 管的是"系统怎么防崩、怎么量化、怎么修".
第二部分:为什么需要 Harness Engineering
2.1 模型能力不是瓶颈
这一判断得到了量化验证:
Can.ac 实验 :仅改变 Harness 的工具格式(编辑接口),就在 16 个模型上显著提升了编码基准分数。效果最显著的 Grok Code Fast 1 从 6.7% 跃升至 68.3%——没有修改任何模型权重.
LangChain实验 :仅通过 Harness 改进,在 Terminal Bench 2.0 上从第 30 名跃升至第 5 名,同一模型提升了 13.7 分。
这些结果表明:在纠结模型选择之前,先审视 Harness 设计能获得更高的投资回报率。
OpenAI 团队说得很直接:真正卡你的不是 Agent 写代码的能力,而是围绕它的结构、工具和反馈机制跟不上. 五个独立团队得出了相同结论:基础设施才是瓶颈,而非智能水平。
2.2 Agent 的典型失败模式
Anthropic 在做长时间运行 Agent 的过程中,总结了 Agent 常见的翻车姿势:
失败模式 1:
试图一步到位(One-shotting)。 Agent 倾向于一次做完所有事情,结果在实现进行到一半时上下文窗口就耗尽了。下一个会话启动时看到的是半成品、没有文档的代码,只能花大量时间猜测之前发生了什么并试图恢复工作状态。
失败模式 2:
过早宣布胜利。 在项目后期,当部分功能已经完成后,Agent 会环顾四周,看到已有进展就直接宣布任务完成——即使还有大量功能未实现。
失败模式 3:过早标记功能完成。 在没有明确提示的情况下,Agent 写完代码就标记为“完成”,却没有做端到端测试。单元测试或 curl 命令通过了不代表功能真正可用。
失败模式 4:环境启动困难。 每次新会话启动时,Agent 需要花费大量 token 弄清楚如何运行应用、如何启动开发服务器,而不是把时间花在实际开发上。
2.3 上下文窗口利用率的甜蜜区间
Dex Horthy 有个很实用的经验观察:上下文填得越满,LLM输出质量越差。以 168K token 的上下文窗口为例,大约用到 40% 就开始走下坡路了:
Smart Zone(前约 40%):聚焦、准确的推理。Agent 拥有相关、精炼的信息。
Dumb Zone(超过约 40%):幻觉、循环、格式错误的工具调用、低质量代码。更多 token 反而损害性能。
说白了,给 Agent 塞一堆 MCP 工具、冗长文档和累积的对话历史,不会让它更聪明——反而会让它变笨。
第三部分:Harness Engineering 的四大支柱
综合 OpenAI、Anthropic、 Carlini (C 编译器项目)、 Huntley 、Horthy 等五个独立团队的实践,四种模式反复出现并形成收敛。这就是 Harness Engineering 的四大支柱。
3.1 支柱一:上下文架构(Context Architecture)
核心原则:Agent 应当恰好获得当前任务所需的上下文——不多不少。
每个团队都独立发现,将所有指令塞进一个文件无法扩展。解决方案是分层上下文与渐进式披露:
OpenAI使用 AGENTS.md 作为动态反馈循环文件,每当 Agent 遇到失败时更新。
Anthropic使用大量 README 和每次会话频繁更新的进度文件。
Horthy倡导"频繁有意识压缩"(Frequent Intentional Compaction)。
Vasilopoulos(2026 论文)将上下文形式化为三层:热记忆(Hot Memory)、领域专家(Domain Experts)、冷记忆知识库(Cold-Memory Knowledge)。
实践建议——三层上下文体系:
层级
加载时机
内容示例
上下文占用
Tier 1:会话常驻
每次会话自动加载
AGENTS.md / CLAUDE.md,项目结构概览
最小
Tier 2:按需加载
特定子 Agent 或技能被调用时
专业化 Agent 的上下文、领域知识
中等
Tier 3:持久化知识库
Agent 主动查询时
研究文档、规格说明、历史会话
按需
3.2 支柱二:Agent 专业化(Agent Specialization)
核心原则:专注于特定领域、拥有受限工具的 Agent 优于拥有全部权限的通用 Agent。
Carlini(Anthropic C 编译器项目)将 Agent 专业化为编译器核心、去重、性能优化和文档四类角色。
Vasilopoulos部署了 19 个领域特定 Agent。
Huntley使用子 Agent 来保持主 Agent 上下文的清洁。
专业化不仅是组织性的——它本身就是上下文管理策略。每个专家因为携带更少的无关信息,所以运行在"Smart Zone"内。
实践中的角色分工:
Agent 角色
职责范围
工具权限
研究 Agent
探索代码库、分析实现细节
只读(Read, Grep, Glob)
规划 Agent
将需求分解为结构化任务
只读,无写入权限
执行 Agent
实现单个具体任务
限定范围的读写权限
审查 Agent
审计完成的工作,标记问题
只读 + 标记权限
调试 Agent
修复审查发现的问题
限定范围的修复权限
清理 Agent
对抗熵积累,清理低质量代码
读写权限
3.3 支柱三:持久化记忆(Persistent Memory)
核心原则:进度持久化在文件系统上,而非上下文窗口中。每次新 Agent 会话从零开始,通过文件系统制品重建上下文。
Anthropic 解决这一问题的方案堪称经典:
初始化 Agent:首次会话使用专门的 prompt,要求模型建立初始环境——init.sh 脚本、claude-progress.txt 进度文件和初始 git 提交。
编码 Agent:后续每次会话要求模型在做出增量进展的同时,留下结构化更新。
每个编码 Agent 的典型会话启动流程如下:
运行 pwd 查看工作目录
读取 git log 和进度文件,了解最近的工作
读取 feature list 文件,选择最高优先级的未完成功能
启动开发服务器,运行基础端到端测试
确认基本功能正常后,开始新功能开发
关键发现:使用 JSON 格式追踪 feature 状态比 Markdown 更有效,因为 Agent 不太可能不恰当地修改或覆盖结构化数据。
3.4 支柱四:结构化执行(Structured Execution)
核心原则:将思考与执行分离。研究和规划在受控阶段进行,执行基于验证过的计划,验证通过自动化反馈(测试、Linter、CI)和人类审查完成。
所有团队都施加了刻意的执行序列:理解 → 规划 → 执行 → 验证。
OpenAI使用声明式 prompt 和反馈回路。轻量的计划用于小变更,复杂工作通过带有进度和决策日志的执行计划完成,并检入仓库。
Huntley将规划模式与构建模式分离。
Horthy的 Research-Plan-Implement 工作流围绕上下文管理精心设计。
人工检查点的价值:审查计划远比审查代码快。当规格正确时,实现自然可靠。当规格有误时,可以在 500 行代码生成之前及时纠正。
第四部分:先进团队的实战案例
4.1 OpenAI:百万行代码的零手写实验
实验概况:
指标
数值
团队规模
3 名工程师
持续时间
5 个月(2025.8 起)
代码规模
约 100 万行
手写代码
0 行(设计约束)
合并 PR 数
约 1,500 个
日均 PR/人
3.5 个
效率提升
约 10 倍
五大 Harness 原则:
原则 1:设计环境,而非编写代码。工程师的工作转向为 Agent 准备高效运行的环境。当 Agent 卡住时,不是"更加努力",而是诊断"缺少什么能力"并让 Agent 自己构建该能力。
原则 2:机械化地执行架构约束。他们为每个领域定义了依赖方向——Types → Config → Repo → Service → Runtime → UI——并用自定义 Linter 和结构测试自动检测违规。文档中记录是不够的;如果不能机械化地强制执行,Agent 就会偏离。
原则 3:将代码仓库作为唯一事实源。写在 Slack 讨论或 Google Docs 中的知识对 Agent 来说等于不存在。所有团队知识都作为版本控制的制品放置在仓库中。
原则 4:将可观测性连接到 Agent。他们将 Chrome DevTools 连接到运行时,使 Agent 能够捕获 DOM 快照和截图。通过赋予查询日志和指标的能力,"将启动时间降至 800ms 以下"变成了可度量的目标。
原则 5:对抗熵。最初团队每周五花 20% 的时间手动清理"AI Slop"(低质量生成物)。这后来被自动化为 Codex 运行的后台任务——清理吞吐量与代码生成吞吐量成正比扩展。
自定义 Linter 的巧妙设计:当 Agent 违反架构约束时,错误消息不仅标记违规——还告诉 Agent 如何修复。工具在 Agent 工作时同时"教会"它。
4.2 Anthropic:16 个 Agent 构建 C 编译器
Carlini 的 C 编译器项目可能是目前最硬核的 Agent 自主开发压力测试.
项目数据:
指标
数值
持续时间
约 2 周
并行 Agent 数
16 个 Claude Opus 4.6 实例
Claude Code 会话数
约 2,000
产出 Rust 代码量
100,000 行
GCC torture test 通过率
99%
可编译的真实项目
150+ (PostgreSQL, Redis, FFmpeg, CPython, Linux 6.9 Kernel 等)
总 API 成本
约 $20,000
关键 Harness 设计:
上下文窗口污染缓解:最小化控制台输出,日志写入文件,使用 grep 友好的错误格式(ERROR: [reason] 单行),预计算聚合统计而非输出原始数据。
Agent 时间盲区:Claude "无法感知时间,如果放任不管,会乐于花几个小时运行测试而不是推进工作。" 解决方案:确定性测试子采样。每个 Agent 运行随机 1-10% 的测试,但子采样对单个 Agent 是确定性的,跨 VM 是随机的——所以集体覆盖了完整的测试套件。
专业化而非通用化:随着项目成熟,Agent 承担了专门角色——核心编译器工作、去重(LLM 生成的代码经常重新实现已有功能)、性能优化、代码质量和文档。
CI 作为 Harness:接近尾声时,Claude 在实现新功能时频繁破坏现有功能。修复方案是一个更严格的 CI 流水线——用 Harness 层面的解决方案应对模型层面的问题。
Carlini 自己的总结很到位:"我必须不断提醒自己,我是在为 Claude 写这个测试框架,不是为自己写。"
4.3 Anthropic:长时间运行 Agent 的有效 Harness
Anthropic 工程团队从另一个角度切入——跨上下文窗口的连续性问题——来研究 Harness 设计.
核心痛点:长时间跑的 Agent 必须在一个个独立会话里工作,每次新会话启动时对前一次做了什么一无所知。就像一个项目组全是轮班工程师,每个人上岗时对之前的进展一脸懵。
两阶段解决方案:
初始化 Agent:使用专门的 prompt 建立初始环境,包括 init.sh 脚本、claude-progress.txt 进度日志和初始 git 提交。
编码 Agent:每次后续会话要求模型做出增量进展,然后留下结构化更新。
四大失败模式与对策:
问题
初始化 Agent 的行为
编码 Agent 的行为
过早宣布项目完成
建立功能列表文件:基于输入规格建立结构化 JSON 文件
会话开始时读取功能列表,选择单个功能开始工作
环境中遗留 bug 或未文档化的进度
编写初始 git 仓库和进度记录文件
开始时读取进度文件和 git 日志;结束时提交 git 和进度更新
过早标记功能为完成
建立功能列表文件
自我验证所有功能,仅在仔细测试后才标记为 "passing"
需要花时间弄清如何运行应用
编写可启动开发服务器的 init.sh 脚本
会话开始时读取 init.sh
浏览器自动化测试:为 Claude 提供 Puppeteer MCP 等测试工具后,Agent 能够识别和修复仅从代码层面无法看到的 bug,显著提升了端到端验证的效果。
4.4 Stripe:千级 PR 的 Minions 系统
Stripe 的 Minions 是目前看到的最成熟的无人值守并行化实践:开发者在 Slack 里发个任务,Agent 从写代码到跑通 CI 再到提 PR 全程包办,人只在最后审查环节介入.
关键架构要素:
Toolshed MCP 服务器:Minions 连接到 Stripe 的集中式 MCP 服务器,提供近 500 个工具,覆盖内部系统和 SaaS 平台。
隔离的预热 Devbox:与人类工程师使用相同的开发环境,但与生产和互联网隔离。
重要的一点:Agent 需要和人类工程师一样的上下文和工具——不是事后补上的集成,而是一开始就得是一等公民。
Hashimoto 的 Ghostty 实践:
Hashimoto 指出 Ghostty 项目中 AGENTS.md 文件的每一行都对应着一个过去的 Agent 失败案例——现在被永久预防。他的核心工作模式:
每天最后 30 分钟启动一个或多个 Agent
Agent 在非工作时间做出一些正向进展,为第二天早上提供"暖启动"
约 10-20% 的正常工作日有后台 Agent 运行
Huntley 的 Ralph Wiggum Loop:
Huntley 的自治循环 while :; do cat PROMPT.md | claude-code; done 因其简洁而广为流传。但其核心不是循环——而是反压(Backpressure):
上游反压:确定性设置、一致的上下文分配、现有代码模式引导模型走向首选实现。
下游反压:测试、类型检查、Lint、构建、安全扫描器和自定义验证器拒绝无效工作。
他的生产设置在 NixOS 上运行裸金属。Agent 直接推送到 master。没有分支。没有人工代码审查。部署在 30 秒内完成。如果出错,反馈循环直接馈入活跃会话进行自我修复。
第五部分:Harness 的核心组件详解
5.1 AGENTS.md——Agent 的活文档
AGENTS.md 是一个新兴的开放约定——本质上是给 AI Agent 的 README。它是代码仓库根目录下的 Markdown 文件,编码 Agent 在每次会话开始时自动读取。
关键特性:
不是一次性编写后遗忘的静态文档
每当 Agent 犯错时都要更新——文档变成了反馈循环而非静态制品
简单的错误(Agent 运行了错误命令、找到了错误 API)通过更新 AGENTS.md 解决
复杂的问题需要构建工具层面的解决方案
OpenAI 的进阶实践:不是维护一个巨大的指令文件,而是构建了一个小型 AGENTS.md,指向更深层的事实源——设计文档、架构图、执行计划、质量评级——全部版本控制并维护在仓库中。一个后台 Agent 定期扫描过期文档并提交清理 PR:由 Agent 为 Agent 维护的文档。
5.2 架构约束与自动化执行
分层架构依赖方向强制执行(OpenAI 实践):
Types → Config → Repo → Service → Runtime → UI
任何违反这一方向的代码都被自定义 Linter 自动检测和阻止。在人类优先的工作流中,这些规则可能感觉过于严苛;对 Agent 来说,它们是乘数效应:一旦编码,便处处适用。
Linter 错误消息即修复指令:
传统 Linter 错误消息仅标记违规。OpenAI 的自定义 Linter 在错误消息中直接包含修复方法——Agent 在遇到违规时同时获得了"教学"。
结构测试:
Martin Fowler 提到了 ArchUnit 等结构测试框架的潜力——它们可以验证代码库的架构约束是否被遵守,这对于 AI Agent 生成的代码尤其重要.
5.3 可观测性集成
OpenAI 团队将可观测性连接到 Agent 工作流:
浏览器自动化:通过 Puppeteer MCP 让 Agent 像人类用户一样进行端到端测试
Chrome DevTools 集成:Agent 能捕获 DOM 快照和截图
日志和指标查询:使性能目标(如"启动时间低于 800ms")变得可度量
遥测驱动的 bug 修复:Agent 利用日志、指标和 Span 来自主重现 bug 和验证修复
5.4 熵管理与"垃圾回收"
Agent 生成的代码以不同于人类编写的方式积累"技术债"。OpenAI 的 Harness Engineering 报告称之为"熵"。
解决方案:定期运行的"垃圾回收" Agent:
扫描文档不一致
检测架构约束违规
清理冗余或低质量代码
确保清理吞吐量与代码生成吞吐量成比例
第六部分:工程师角色的转变
6.1 从写代码到设计环境
OpenAI 和 Anthropic 的实践都指向同一个结论:工程师的工作正在分成两块很不一样的东西:
第一部分:构建环境。当 Codex 卡住时,团队将其视为环境设计问题——诊断 Agent 缺少什么才能可靠地继续工作。焦点从实现转向赋能。
第二部分:管理工作。Greg Brockman 建议每个团队指定一名"Agent 队长"——负责思考 Agent 如何融入团队工作流。Peter Steinberger(OpenClaw 创作者)在一个月内完成了 6,600+ 次提交,同时运行 5-10 个 Agent。
这两部分不是顺序关系。你同时做两件事,每件事都影响另一件:Agent 的失败告诉你环境缺少什么;更好的环境让管理更顺畅。
6.2 规划是新的编码
越来越多的开发者强调与 AI 合作时前期规划的广度——如此之深,以至于大多数 AI 编码工具现在都包含专用的"更多规划"功能。
Cloudflare 的 Boris Tane 将此原则总结为一句话:"永远不要让 Agent 在你审查和批准书面计划之前写代码。这种规划与执行的分离是我做的最重要的一件事。"
Anthropic 的做法更进一步:初始化 Agent 从高级 prompt 生成综合 feature 列表——单个 Web 应用超过 200 个独立功能,每个都有明确的测试步骤,全部初始标记为"failing"。
6.3 并行编排与"两种管理风格"
两种并行工作模式正在浮现:
模式
描述
优势
要求
有人值守并行化
主动管理多个 Agent 会话,检查每个、按需重定向
更多控制,更早发现问题
认知负担高
无人值守并行化
开发者发布任务后离开,Agent 自主完成到 PR
更好的可扩展性
Harness 必须足够好以信任 Agent
Stripe 能做到无人值守并行化,是因为他们已经建立了 Toolshed、预热 Devbox 和紧密的 CI 集成。大多数团队还不具备这些条件。
团队在这个光谱上的位置取决于两个因素:Harness 的成熟度和对 Agent 在代码库中的信任程度。
第七部分:业界趋势与前瞻
7.1 Harness 将成为新的服务模板
Martin Fowler 提了一个比较有意思的判断:大多数组织只有两三个主要技术栈。未来,团队可能会从一组预制 Harness 中选择,就像今天的服务模板(Service Templates)帮助团队在"黄金路径"上实例化新服务。
Harness 模板可能包含:
自定义 Linter 规则
结构测试
基础上下文和知识文档
额外的上下文提供者
预配置的 CI/CD 管道
7.2 技术栈和代码拓扑的收敛
当编码不再是关于打字而是关于引导生成时,AI 可能推动我们走向更少的技术栈选择。开发者可能基于"AI 友好性"和"Harness 可用性"来选择技术栈,而不仅仅是开发者偏好。
OpenAI 团队讨论了架构刚性和执行规则。关键聚焦领域:保持数据结构稳定和定义并执行模块边界。
7.3 Harness 应趋向简化而非复杂化
Phil Schmid 的分析揭示了一个反直觉的现象:Manus 团队半年内重写了五次 Harness,但每次的方向都是简化而不是加复杂度——用通用 Shell 执行替代复杂工具定义,用结构化交接替代管理 Agent,采用 Agent-as-a-Tool 模式.
经验教训:随着模型能力提升,Harness 应该越做越薄。如果发现 Harness 越做越复杂,大概率是过度工程化了。
7.4 更好的模型让 Harness 更重要而非更不重要
Carlini 的 C 编译器项目给了直接证据:Opus 4.5 能产出能用的编译器,Opus 4.6 能编译 Linux 内核——但每个能力级别都得重新设计 Harness。模型越强,能给的自主权越大,护栏就得越好.
7.5 棕地项目的改造挑战
所有公开的成功案例都涉及绿地项目或从零构建的 Harness。将这些技术应用到有十年历史、没有架构约束、测试不一致、文档残缺的代码库上,是一个更复杂的问题。Martin Fowler 将其比作"在从未使用过静态分析工具的代码库上运行静态分析——你会被警报淹没".
第八部分:最佳实践总结
8.1 立即可行的行动清单
创建并维护 AGENTS.md:不是一次性任务,而是每当 Agent 犯错时都更新的活文档。
在仓库中建立单一事实源:所有团队知识作为版本控制的制品存放在代码仓库中,不放在 Slack、Wiki 或 Google Docs。
构建自定义 Linter 并在错误消息中嵌入修复指令:工具在 Agent 工作时同时"教会"它。
为 Agent 提供端到端测试工具:浏览器自动化(如 Puppeteer MCP)显著提升验证质量。
实施增量执行策略:每次会话只处理一个功能,完成后提交 git 和进度更新。
分层管理上下文:避免将所有信息堆叠在单个文件中,使用 Tier 1/2/3 渐进式披露。
上下文利用率保持在 40% 以下:更多 token 不代表更好的结果。
建立定期"垃圾回收"机制:自动化 Agent 定期清理技术债、检查文档一致性。
8.2 Harness 成熟度评估模型
阶段
特征
工程师角色
Level 0:无 Harness
直接给 Agent prompt,无结构化约束
手动写代码+偶尔使用 AI
Level 1:基础约束
AGENTS.md + 基础 Linter + 手动测试
主要写代码,AI 辅助
Level 2:反馈回路
CI/CD 集成 + 自动化测试 + 进度追踪
规划+审查为主,部分 AI 编码
Level 3:专业化 Agent
多 Agent 角色分工 + 分层上下文 + 持久化记忆
环境设计+管理为主
Level 4:自治循环
无人值守并行化 + 自动化熵管理 + 自修复
架构师+质量把关者
8.3 关键 Harness 组件检查清单
组件
用途
优先级
AGENTS.md / CLAUDE.md
会话常驻上下文,动态反馈循环
P0
自定义 Linter + 结构测试
机械化执行架构约束
P0
CI/CD 管道
自动化测试和验证反馈
P0
进度文件 (progress.txt / JSON)
跨会话的持久化记忆
P1
功能列表文件 (feature_list.json)
结构化完成标准
P1
浏览器自动化 (Puppeteer MCP)
端到端测试验证
P1
可观测性集成
Agent 可查询日志/指标
P2
熵管理 Agent
定期清理低质量代码
P2
专业化子 Agent
分工协作减少上下文污染
P2
MCP 工具集成
连接外部工具和数据
P2
第九部分:开放问题与挑战
9.1 代码可维护性的长期隐患
Greg Brockman 抛出了一个还没有答案的问题:怎么防止"功能没问题但维护性很差"的代码渗透进代码库?Agent 写的代码和人写的代码,积累技术债的方式不一样。定期跑"垃圾回收" Agent 是一种新兴做法,但效果还待验证。
9.2 规模化验证
Birgitta Böckeler 对 OpenAI 报告的批评直击要害:报告缺乏对功能和行为的验证。即使有浏览器自动化,视觉能力和工具限制意味着某些 bug 仍会遗漏(例如 Agent 无法看到浏览器原生 alert 弹窗).
9.3 棕地项目改造
如何为已有十年历史的代码库引入 Harness Engineering——而不是被警报淹没——仍是一个开放问题。可能需要增量式引入,从最关键的架构约束开始。
9.4 文化采纳
所有成功案例都指向同一个事实:这些东西不会自己出现,得有人去建。好消息是这些投入有复利效应——每次 AGENTS.md 更新都预防了一类未来失败,每个自定义 Linter 让后续每个 Agent 会话都受益,每个通过 MCP 暴露的工具都加快后续任务。前期成本确实不低,但回报会加速。
第十部分:业界共识与分歧全景
综合 OpenAI、Anthropic、Stripe、Martin Fowler / Böckeler、Mitchell Hashimoto、Charlie Guo、Alex Lavaee、SmartScope 等 8 个独立信息源的交叉对比,以下梳理出 Harness Engineering 领域目前已形成共识的方面和仍存在分歧的方面。
10.1 六大共识
共识 1:瓶颈在基础设施,不在模型智能。这是整个领域最核心的共识。Can.ac 实验中仅改变 Harness 的工具格式就让 Grok Code Fast 1 从 6.7% 跳到 68.3%,LangChain 同一模型靠 Harness 改进从第 30 名跳到第 5 名。Alex Lavaee 的总结最直接:"Five independent teams. Same conclusion: the bottleneck is infrastructure, not intelligence." 六个以上独立来源支持这一判断,无反对意见。
共识 2:文档必须是活的反馈循环,不是静态制品。Hashimoto 的 Ghostty 项目 AGENTS.md 每一行都对应一个历史 Agent 失败案例。OpenAI 更进一步,让后台 Agent 定期扫描过期文档并提交清理 PR——Agent 为 Agent 维护文档。Anthropic 用 claude-progress.txt + git 日志做跨会话活文档。四个以上来源支持,无反对意见。
共识 3:思考与执行必须分离。OpenAI、Anthropic、Hashimoto、Horthy、Huntley、Boris Tane 全部独立发现了"先规划再执行"的模式。Boris Tane 的表述最简洁:"永远不要让 Agent 在你审查和批准书面计划之前写代码。" Anthropic 把这个做到了极致——初始化 Agent 生成超过 200 个功能的结构化列表,全部初始标记为 failing。六个以上来源支持。
共识 4:上下文不是越多越好。Horthy 给出了量化经验——上下文填到约 40% 就开始走下坡路,之后进入 Dumb Zone。Carlini 花大量精力做"上下文窗口污染缓解"。OpenAI 从单个巨大 AGENTS.md 迁移到分层渐进式披露。Vasilopoulos 的 283 个开发会话学术验证也证实单文件指令集在规模化后会崩溃。四个以上来源支持。
共识 5:约束必须机械化执行,不能靠文档记录。OpenAI 原话:"if it cannot be enforced mechanically, agents will deviate." Carlini 的项目后期 Claude 频繁破坏现有功能,解决方案是更严格的 CI——"a harness-level solution to a model-level problem"。Huntley 的 Backpressure 概念核心就是上下游的机械化约束。Martin Fowler 提到 ArchUnit 等结构测试框架的重要性。四个以上来源支持。
共识 6:工程师角色正在从"写代码"转向"设计环境 + 管理工作"。OpenAI、Charlie Guo、Hashimoto、Martin Fowler / Böckeler 都在强调这一转变。Chad Fowler 用 "Relocating Rigor" 描述这个现象——rigor 没有消失,只是从写代码转移到了设计约束系统。
10.2 四大分歧
分歧 1:Harness 应该越做越复杂还是越做越简单?
这是目前争议最大的问题之一。Manus 团队半年重写五次 Harness,每次方向都是简化——用通用 Shell 执行替代复杂工具定义。Phil Schmid 据此提出"如果 Harness 越做越复杂,大概率是过度工程化了"。但 OpenAI 花了 5 个月构建了大量自定义 Linter、结构测试、分层文档系统和后台清理 Agent。Carlini 随着模型从 Opus 4.5 升级到 4.6,每个能力级别都需要重新设计 Harness。Martin Fowler 没有明确站队,但暗示未来可能走向标准化模板。
这个分歧的根源在于场景不同:Manus 做通用 Agent 产品,追求最小化 Harness 以适应各种场景;OpenAI 做特定产品的深度开发,Harness 可以高度定制。两者并不矛盾,但"哪个方向是主流"尚无定论。
分歧 2:单 Agent 还是多 Agent 架构?
Carlini 用 16 个并行 Agent 构建 C 编译器,Vasilopoulos 部署了 19 个领域特定 Agent,Alex Lavaee 的 Atomic CLI 内置了 10 个专业化子 Agent。但 Hashimoto 明确说 "I'm not \\[yet?\\] running multiple agents, and currently don't really want to",Anthropic 的长时间运行 Agent 研究用的是单 Agent 循环跑多次会话。Stripe 和 Huntley 介于两者之间——Stripe 的 Minions 是多个独立 Agent 并行,但每个 Agent 独立完成端到端任务。
Anthropic 自己也承认这是 open question——"it's still unclear whether a single, general-purpose coding agent performs best across contexts, or if better performance can be achieved through a multi-agent architecture." 目前的证据表明,任务复杂度和代码库规模是决定因素:小项目单 Agent 够用,大项目几乎必然需要多 Agent 专业化。
分歧 3:人类应该介入到什么程度?
光谱的一端是 Hashimoto——一次只跑一个 Agent,保持深度参与。另一端是 Stripe Minions 和 Huntley——开发者发个消息就走了,Agent 全程包办到 PR,甚至直接推 master,不做人工代码审查。中间是 OpenAI 和 Anthropic——规划阶段人类审查,执行阶段 Agent 自主,验证阶段自动化加人类审查。
Charlie Guo 的分析最到位:团队在这个光谱上的位置取决于"Harness 的成熟度"和"对 Agent 在代码库中的信任程度"。Stripe 能做到无人值守,是因为 Toolshed + 预热 Devbox + CI 集成已经非常成熟。大多数团队还不具备这些条件。这不是理念分歧,而是成熟度差异。
分歧 4:术语边界怎么画?
SmartScope 和 Alex Lavaee 主张嵌套关系:Harness ⊇ Context ⊇ Prompt,三者是渐进扩展的关注域。mtrajan 主张互补关系:"Context Engineering helps the model think, while Harness Engineering prevents the system from going off the rails." Martin Fowler / Böckeler 则对术语本身持保留态度:"The term is used only once in the article body. It may be a retroactive label."
SmartScope 的务实结论是:"In practice, the choice of framing does not significantly affect design decisions." 争的是怎么画框,不是框里有什么。
10.3 三大空白区
以下是目前文献中被反复提及但缺乏解决方案的领域,也是最值得投入探索的方向。
空白 1:棕地项目的 Harness 改造。所有公开成功案例——OpenAI、Carlini、Anthropic、Stripe、Hashimoto——全部是绿地项目或可控环境。对于十年历史的遗留代码库如何引入 Harness Engineering,目前零成功案例、零方法论。Martin Fowler 将其比作"在从未用过静态分析工具的代码库上运行静态分析——你会被警报淹没"。如何在不重写的前提下渐进式引入 Harness?从哪些约束开始投入产出比最高?是否需要先用 AI 做一轮"代码考古"再建 Harness?全部待解。
空白 2:功能和行为验证的系统化方案。Böckeler 对 OpenAI 报告最尖锐的批评:大量讨论了架构约束和熵管理,但功能正确性验证几乎缺席。Anthropic 承认 Agent 倾向于不做端到端测试就标记功能完成。即使提供了 Puppeteer MCP,也有局限——Agent 看不到浏览器原生 alert 弹窗。Carlini 的编译器项目用 GCC torture test 做功能验证(99% 通过率),但那是有明确正确性标准的特殊领域。目前大家擅长的是"约束 Agent 不做错事"(架构约束、Linter、类型检查),但"验证 Agent 做对了事"这个问题远未解决。
空白 3:AI 生成代码的长期可维护性。Brockman 抛出的问题至今无人回答:怎么防止"功能没问题但维护性很差"的代码渗透进代码库?Agent 写的代码和人写的代码,积累技术债的方式不一样——LLM 生成的代码经常重新实现已有功能(Carlini 专门分配了"去重 Agent"来解决这个问题)。"垃圾回收" Agent 是一种新兴做法,但长期效果还缺乏数据。代码审查标准是否需要针对 AI 生成代码做根本性调整?这个问题完全开放。
10.4 共识与分歧速查表
领域
共识程度
核心结论
基础设施 > 模型智能
★★★★★
全面共识。6+ 来源支持,无反对。
思考与执行分离
★★★★★
全面共识。所有团队独立发现。
文档作为活反馈循环
★★★★☆
强共识。做法细节有差异,原则一致。
上下文不是越多越好
★★★★☆
强共识。有量化数据(~40% 甜蜜区间)。
约束必须机械化执行
★★★★☆
强共识。Linter、CI、结构测试是标配。
工程师角色转变
★★★★☆
强共识。方向一致,具体分工在演化中。
人类介入程度
★★★☆☆
部分共识。方向是减少介入,取决于 Harness 成熟度。
Harness 简化 vs 精细化
★★☆☆☆
存在分歧。取决于通用产品 vs 定制项目。
单 Agent vs 多 Agent
★★☆☆☆
存在分歧。规模决定选择,缺乏通用指导。
术语边界定义
★★☆☆☆
存在分歧。嵌套 vs 互补,术语能否存活存疑。
功能验证方法
★☆☆☆☆
严重缺失。被指出但无解决方案。
棕地项目改造
★☆☆☆☆
完全空白。零成功案例,最大实践缺口。
AI 代码长期可维护性
★☆☆☆☆
完全空白。问题已提出,无人回答。
总结
Harness Engineering 标志着 AI 辅助开发从"让模型写代码"到"设计让模型可靠工作的系统"的范式转变。这不是等更强模型出来就能解决的事——模型越强,Harness 反而越重要。六大共识已经清晰(基础设施是瓶颈、文档要活、思考与执行分离、上下文不是越多越好、约束必须自动化、工程师角色在转变),但棕地项目改造、功能验证体系、AI 代码的长期可维护性三大空白区仍待填补。如果只记一句话:瓶颈不在智能,而在基础设施。正如 Addy Osmani 所言:"AI 编码的兴起并没有取代软件工程的工艺——它抬高了工艺的门槛。"
Harness Engineering:同一个模型,从42%到78%——Vibe Coding时代真正的护城河
同一个模型, Claude Opus 4.5 ,在CORE-Bench(一个测试AI完成科学复现任务的基准测试)上,用Claude Code作为harness跑出了78%的成绩,而用另一个通用scaffold(Smolagents)只跑出42%。模型没变,成绩几乎翻倍。CORE-Bench的作者Sayash Kapoor公开确认了这个数据。
这组数字说明了一件事:在 Vibe Coding 时代,决定产出质量的,越来越不是"用哪个模型",而是"你给模型搭了什么样的环境"。
但现实是,整个行业还在争论GPT、Claude、Gemini谁更强,这好像是搞错了评价的重点。AI Agent频频翻车的真正瓶颈,大概率不是模型本身,而是包裹在模型外面的那套基础设施和工具——也就是"harness"。
和几个做AI开发的朋友聊,他们的体感也在印证这一点:团队里写代码最快的人,产出反而不如一个"不怎么写代码"的同事。后者整天在写文档、定规范、调prompt、搭流程。作为独立开发者,我自己用Claude Code也是一样:花在"写代码"上的时间越来越少,花在"告诉AI怎么写"上的时间越来越多。
一、三年三个阶段:从Prompt到Context到Harness
老师做了一张图,把过去三年AI开发范式的演进讲得很清楚(见题图)。
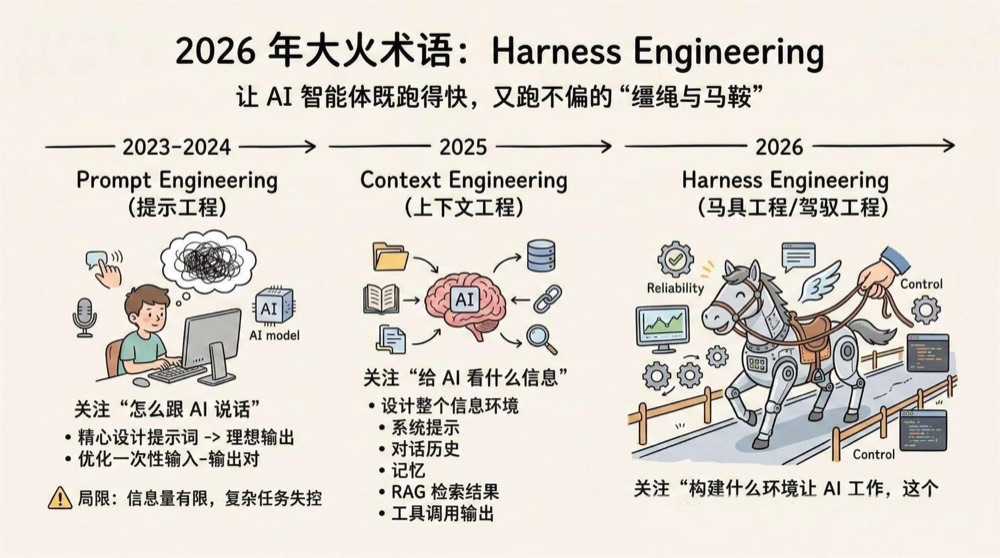
我觉得这个框架是理解Harness Engineering最好的切入点:
2023-2024: Prompt Engineering (提示工程)——关注"怎么跟AI说话"。精心设计一段提示词,希望模型给出理想输出。本质上是优化一次性的输入-输出对。局限很明显:一条消息能塞的信息有限,任务一复杂就失控。
2025: Context Engineering (上下文工程)——关注"给AI看什么信息"。不再只盯措辞,而是设计整个信息环境:系统提示、对话历史、记忆、RAG检索结果、工具调用输出。
2026:Harness Engineering(马具工程/驾驭工程)——关注"构建什么环境让AI工作,这个环境如何保证它的产出是可靠的"。比Context Engineering更进一步——不仅管理输入给模型的信息,还包括模型之外的整个执行环境:验证闭环、架构约束、生命周期管理、熵清理。
"Harness"这个词,字面意思是马具——缰绳、马鞍、嚼子。AI Agent就像一匹动力十足但不太守规矩的马,Harness就是那套让它既能跑得快、又不会跑偏的控制系统。这个概念最早由 Mitchell Hashimoto (Terraform的作者)提出,核心原则是:每次发现AI犯错,就花时间工程化一个机制,让它以后再也不犯这个错。
Google前首席决策科学家 Cassie Kozyrkov 最近专门写了一篇长文讨论这个转变。她的观点很直白:Vibe Coding降低了语法门槛,但没有降低系统思维门槛——事实上,它提高了这个门槛。
二、不是孤例:所有数据都指向同一个结论
42%到78%不是孤例。 LangChain 最近做了一个实验:他们的编程Agent在Terminal Bench 2.0上从52.8%提升到66.5%,排名从Top 30一路冲到Top 5。他们用的模型始终是GPT-5.2-Codex,一行模型代码没改,只调了三样东西:系统提示词、工具配置和中间件钩子。
OpenAI自己就更极端了。2026年2月他们发了一篇文章,讲了一个内部实验:一个最初只有3名工程师的小团队,5个月时间,零行手写代码,完全由Codex Agent生成了一个百万行级别的生产级内部产品。约1500个PR被提交和合并,平均每人每天3.5个PR,后来团队扩展到7人,吞吐量反而还在上升。
这些数据指向一个结论:模型是商品,马具才是护城河。
目前最前沿的玩法已经在跨厂商组合了:用Claude Code作为执行Agent,用Codex Harness作为验证环境。写代码的是一个模型,检验代码的是另一套系统。这个思路本身就说明了问题——大家竞争的焦点早就不是"用谁家的模型",而是"怎么搭这套验证和控制的基础设施"。
三、我理解的"马具"到底是什么
Kozyrkov用了一个很好的比喻:你用AI写代码,就像雇了一个能力超强但完全不了解你情况的实习生。问题不在于它做不好你明确交代的事——问题在于你没交代的部分,它会用"过度自信的即兴发挥"来填补。每一个你没有明确的模糊地带,都是你在不知不觉中把决策权泄露给了这个实习生。
她管这叫"信任债务"(Trust Debt):你没有审计过的那些AI假设,累积起来的成本。它不会提前告诉你,而是默默复利,直到某天一起爆发。
那怎么管理这个实习生?说白了就是四件事。
3.1 第一,把规矩写下来。
很多人用Claude Code或者Cursor,上来就开始对话。这就好比你不给任何背景,直接说"把这个功能做了"。结果可想而知。
现在的做法是:项目根目录放一个CLAUDE.md或AGENTS.md。但关键是——OpenAI踩过的坑告诉我们——这个文件应该是一张"地图",不是一本百科全书。OpenAI的Codex团队原话是:给Agent一张地图,不要给它一本1000页的操作手册。
具体怎么写?大概20-40行就够了:项目是什么、核心代码在哪、代码风格遵循什么规范、有哪些绝对不能碰的红线。然后把详细规则分拆到CONVENTIONS.md、ARCHITECTURE.md等独立文件里,让AI按需查阅。
更关键的一点:要写清楚"什么事不要做"。AI最大的问题不是不会做,而是太会自作主张。你不告诉它边界在哪,它会在模糊地带自动补全业务逻辑。
3.2 第二,规格先行,别上来就写代码。
Kozyrkov提出了一个"双翻译"习惯:在让AI写代码之前,先让它用自然语言复述一遍它理解的需求和假设。看看它的"计划书"。每一个你没纠正的假设,都等于你默认批准了。
代码写完之后,再让另一个独立的AI把代码翻译回自然语言,告诉你这段代码到底做了什么、可能在哪里出问题。然后跟你脑中的预期做对比。差异会立刻跳出来。
这个方法对业余项目已经够用了。但对生产级项目,需要更系统化——写正式的功能规格文档,包含功能范围、不包含什么、数据结构、验收标准和边界情况,再交给AI去实现。
3.3 第三,建立验证闭环。
不能让AI写完代码就完事。OpenAI内部管这叫"Ralph Wiggum Loop"——AI自己写代码、自己开PR、自己审查、自己跑测试、失败了自己修、再跑测试,循环往复直到通过。人类只在真正需要判断的时候介入。
为什么?因为当代码量大到百万行级别,人已经不可能逐行审查了。你能做的是监控信号,不是审查噪音。
3.4 第四,控制信息量——这是最反直觉的一点。
很多人觉得应该给AI尽可能多的上下文。这条路是不对的,信息太多,AI反而会被淹没。
Anthropic 在设计长时间运行的Agent时采用了"渐进式披露"(Progressive Disclosure):AI需要处理哪个模块,就只加载那个模块的文档。
Claude Code的Skills机制就是这个思路:启动时AI只看到skill的名字和简短描述,真正需要用的时候才加载完整内容。本质上就是给大模型做"懒加载"。
Kozyrkov用了一个精辟的类比:恒温器不需要理解热力学。它只需要测量温度,然后跟设定值比较。你的harness也是一样——不需要理解AI内部的每一行推理,只需要精确定义边界就够了。
四、"做减法"才是硬道理
我注意到一个趋势:所有在Harness工程上走得最远的团队,最终都在做减法。 Cassie Kozyrkov的文章里引用了一个很有说服力的细节:Phil Schmid测量发现,用标准方式集成6个MCP服务器,光schema定义就要消耗47000个token。你的AI还没开始想问题,就已经吃掉了4万7千token的"粮草"。而一个简单的CLI封装只需要大约400 token。
Vercel的实践验证了这一点。他们一开始给Agent配了完整的工具库——搜索、代码、文件、API,应有尽有。结果Agent反而困惑了,反复调用冗余工具。后来大刀阔斧砍到只留基础bash访问,准确率飙到100%,速度快了3.5倍。
Manus(后来并入Meta的AI Agent系统)的经历更极端:6个月内重写了5次框架,同一个模型。他们最初用todo.md让Agent每一步都重写任务列表,结果大约30%的token都浪费在更新这个文件上。后来换成子Agent规划器,按需注入结构化对象,token消耗大幅下降。他们的首席科学家Peak Ji说了一句话:模型越强,我们搭的脚手架就应该越少,而不是越多。
Anthropic也表达了类似观点:随着模型能力提升,那些模型曾经需要的工具,现在可能反过来在限制它们。
这跟Richard Sutton的"苦涩的教训"(The Bitter Lesson)是一脉相承的:长期来看,简洁通用的方法总会胜过复杂精巧的方法。
五、如果你今天想开始,做三件事就够了
不用一步到位。
第一,在项目根目录建一个CLAUDE.md。 花15分钟,写清楚:项目技术栈、核心代码路径、代码规范的红线。保持20-40行。如果超过了,说明你在写百科全书而不是地图。
第二,任何功能开发之前,先让AI复述它理解的需求。 在你的prompt末尾加一句:"在你写代码之前,先详细告诉我你对我要求的理解,以及你需要我确认的假设。"读它返回的内容。这一步能在代码产生之前拦住大部分"fanfiction"。
第三,每个季度清理一次你的规则文件。 模型在进步,三个月前需要的很多限制,现在可能已经多余了。哪些工具30天没被调用过?删掉。哪些规则是因为旧模型太笨才加的?去掉。如果你的harness只增不减,说明它正在变成牢笼而不是马具。
六、最后说一句
在将来,不会写代码,可能不再是什么大问题;不懂系统,才是大问题。未来真正稀缺的,不是能写出漂亮代码的人,而是能设计出一套环境、让AI持续稳定产出的人。这套环境,就是你的护城河。
大学也在跟进。我在SUTD教AI课,今年课改的核心就是教学生构建环境约束和反馈环来控制AI Agent,本质上就是Harness Engineering。SIT新开了类似方向的课程,斯坦福和CMU的Prompt Engineering课也在被Agentic Infrastructure取代。这不是流行语,它正在成为下一代工程师的基础素养。
我的Harness Engineering实践
所谓 Harness Engineering ,是通过强制性的工程约束和标准化的输入输出,将 AI 的不可预测性,收敛为确定性的交付。
最近接手了一个企业项目,代码都是AI写的,但由于有很好的规范,因此即使用Cursor/Claude Code给项目贡献代码,依然没崩过。
项目的业务信息已隐去,只用这个项目的相关技术为例,来讲讲怎么做Harness Engineering。
这是运行了多年的企业级全栈项目,是一个Monorepo(前端后端代码都放在一个项目里),采用 Spring Boot + React + PostgreSQL ,部署在 Kubernetes 上,通过 Helm charts 管理多环境配置, Jenkins pipeline 做 CI/CD。
这套东西就基本上规范了开发者的开发流程,而这套规范,换到Agent生成,就成了Harness Engineering的一部分。总体架构大概是这样
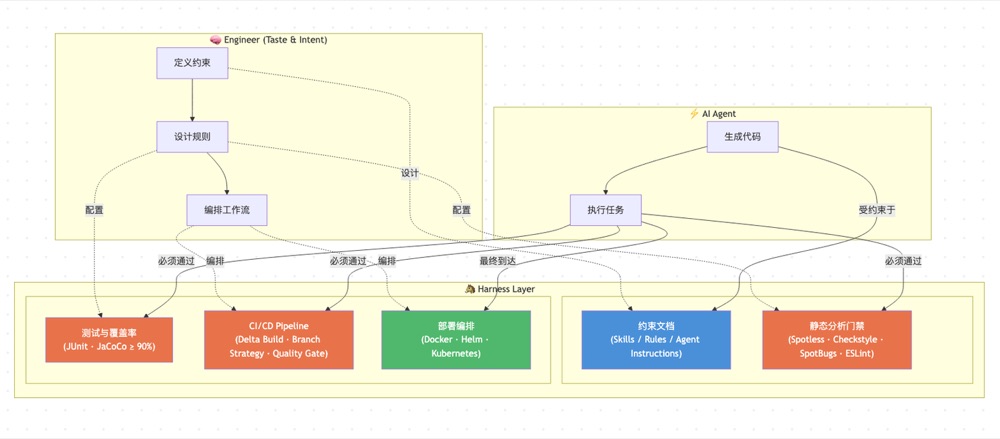
接下来详细分解。
Spring Boot MVC 分层本身就是一种 Harness
说实话,我个人并不喜欢Spring Boot 这套东西,很啰嗦,每次加点小feature,就搞个几千行的代码变更。
这里只是加了一个很小的feature
但Spring Boot 能在企业应用中风靡这么久,有它的道理。Spring Boot的规范性强,约定和分层让 50 人的团队写出结构一致的代码。使用spring boot开发的软件架构如下,代码应该怎么放,挺清晰的。
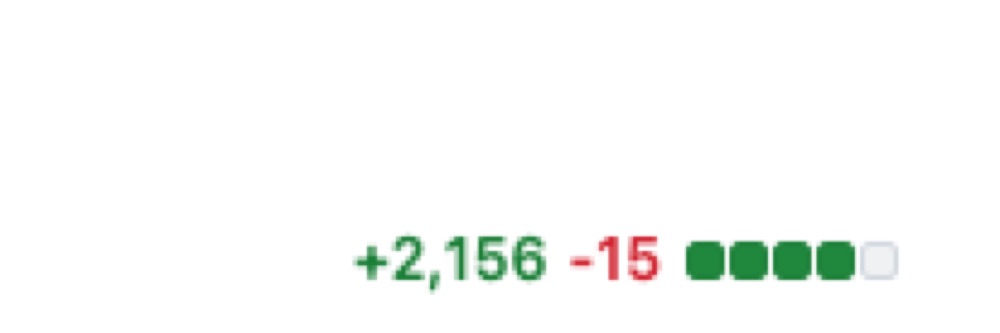
这个分层结构对 AI agent 来说,本身就构成了一套 harness 约束。
当然,这套约束对AI有强制效果吗?我只能说,有效果,但AI非要瞎写时,我也管不住。那么,怎么才能把这套指导,变成强制约束呢?我们团队设置了几层约束:
强制规范约束
项目配置了多层静态分析,确保:
Spotless(自动格式化)确保每行代码风格统一
Checkstyle (编码规范)约束类成员声明顺序、禁止 magic number
SpotBugs (缺陷检测)在编译期捕获常见 bug 模式
JaCoCo (覆盖率)设定 90% 行覆盖率硬门槛
ESLint + Prettier (前端)保持 React/TypeScript 代码一致性
当 AI 生成的代码过不了 lint、过不了覆盖率检查,它会被迫修正。这些质量检测系统构成了 harness 的第一道防线。
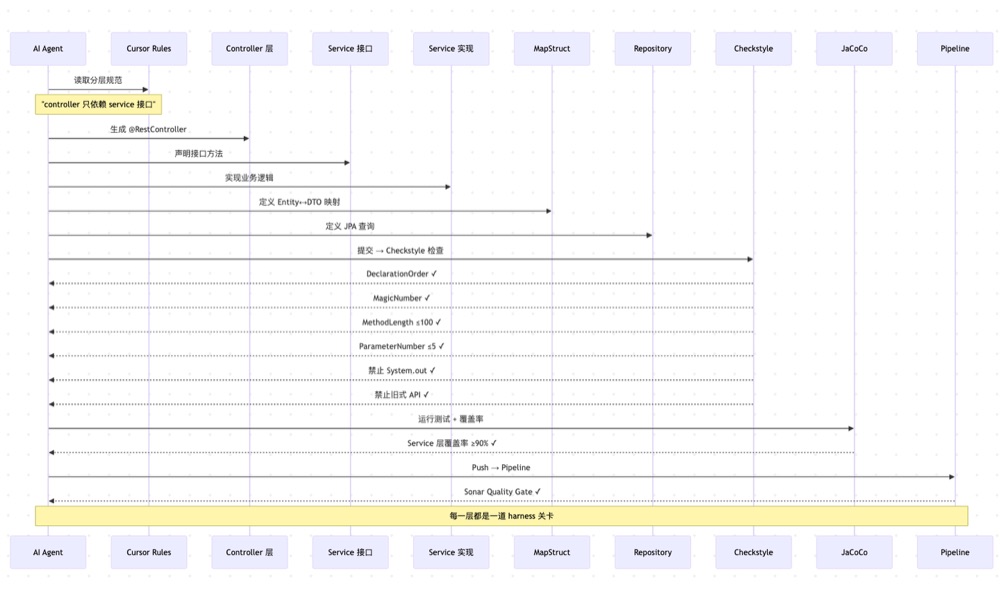
(注:以上这套分析用到的一些工具,例如JaCoCo,虽然是分析java用的,但过程可以借鉴,例如你用python,就用pytest-cov)
Pre-commit 约束
我在项目文件夹的 /github/hooks 下面,放了三个代码:
pre-commit-lint.sh:运行lint检查
pre-commit-test.sh :运行单元测试
commit-msg.sh:检查提交信息符合规范,必须带branch名称作为前缀,以方便review
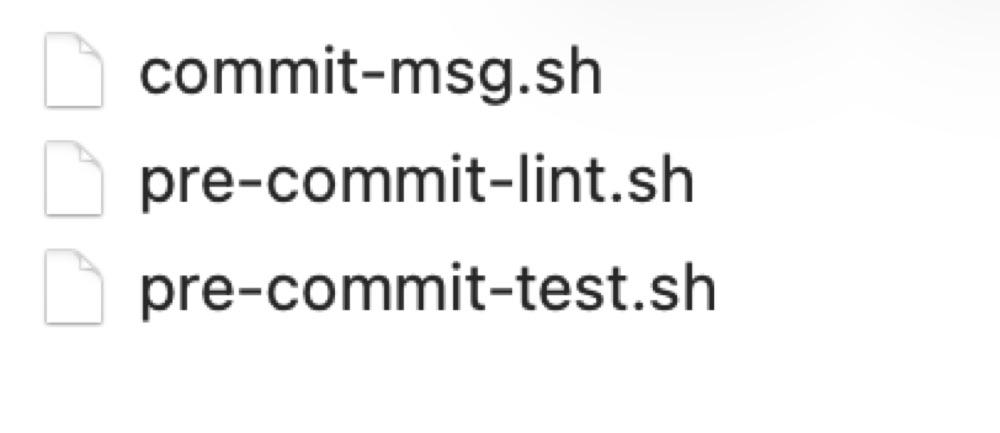
可以看到,我们这套代码规范还是挺严格的。这形成了一个反馈闭环:AI 写代码 → 提交 → hooks 拦截 → AI 修复 → 再提交。整个过程不需要人介入,但质量被牢牢把控。
CI/CD约束
我可以在AutoJenkins文件里定义buildFlow,这样每次我提交代码,就会触发build。
buildFlow : [
PULL_REQUEST: ['Build', 'Compile', 'Unit Test', 'Scan', 'scanAtSource','Sonar', 'Quality Gate'],
QA : ['Build', 'Compile', 'Unit Test'],
RELEASE : ['Build', 'Compile', 'Unit Test'],
],
可以看到,在不同的开发阶段,可以采用不同标准的质量管理方法啊,例如PR时由于要并入Agent的代码,需要更多步骤检查,而并入后,在其他阶段,只需要跑Unit Test就够了。
将工作流编进skills里进行约束
当然,CI/CD+软件工程规范并非Harness Engineering的全部,但也80%了。Harness Engineering的最终目的,是人搭好脚手架后,Agent能够在尽量少人工干预的情况下,尽可能多且好的完成工作。剩下的20%,可以通过最近很火的skills来实现。
我定义了几个skills,它们定义了:
本地开发环境怎么起(Docker Compose → 数据库 → Backend → Frontend 的启动顺序)
Git 工作流是什么(rebase 策略、冲突解决方式、分支命名)
PR 要满足什么质量才能合并
CI/CD 的 delta build 机制(只构建有变更的子项目)
当然,这些流程能不能构成约束?其实是可以的,例如本地环境怎么起这一块,它不follow我的流程,它就起不来。
达到的效果
通过这套Harness Engineering的方案,团队实现了「一劳永逸」的Vibe Coding体验,目前我们日常是这样的:
每周plan会议,讨论这周要实现的东西
在每个ticket里,描述我们要实现的feature
在Cursor里,通过skils,读取ticket里的内容,然后开始自动开发
开发完成,本地会跑lint,JaCoCo,checkstyle,单元测试等。
开发者在这一步介入,通过skills让代码在本地跑一下,看看feature实现得是否符合预期。
本地review一下,没问题,通过skills,自动创建branch(branch名字和ticket名字一样以方便管理),提交,创建PR
通知团队成员一起review。虽然多数时候大家给的评论都是「LGTM」,但我认为,还是很有必要review的,虽然AI写的代码你不一定每一行都看,但你得大概有个印象,这是mental alignment的一部分。
总结
可以看到,我们做Harness Engineering,有三层约束:
第一层:架构级约束(Architecture as Harness),例如 Spring Boot MVC。
第二层:质量级约束(Quality as Harness),例如Spotless, Checkstyle, JaCoCo等,让 Agent生成的代码质量在编译器和测试报告中进化。
第三层:流程级约束(Workflow as Harness)。整合 Git Hooks 和 Jenkins CI/CD,实现反馈闭环(Feedback Loop),让AI 不只是写代码,它必须自己通过你设定的重重关卡。
没有Harness Engineering,技术债就会膨胀。以前我们设定软件工程规范,其实是需要取一个平衡值的,既不能没有规范导致技术债膨胀,也不能规范太多导致大家开发效率太低。而Agentic coding年代,可以再严格点,反正是Agent来写,随便压榨!
Claude Harness Engineering 操作手册
这份文档不是传统 SOP
这份文档有严格的适用边界。它不是一个固定流程,而是一份带时间戳的、个人视角的阶段性认识。原因有三:
最佳实践每月都在变——以当前模型和工具的更新速率,上个月的最优做法这个月大概率已经不是最优
模型能力在持续增强——具体操作步骤写下来就在过时,今天需要的 workaround 明天可能被原生支持
不同人的使用方式差异很大——没有统一的”正确用法”,一个人的最优路径对另一个人可能是过度工程
因此,这份文档只覆盖 Claude Code 最基本的使用方法,聚焦在更长时间内都适用的主要原则,而不是具体操作步骤。里面的模板和示例是参考,不是规定。当你的判断和文档冲突时,信你自己的判断。
蜂群模式 、 多智能体协作 、 Skills 体系 等高级用法不在本文讨论范围内。
核心原则
本 SOP 建立在 Harness Engineering 的四大支柱之上,并针对 Claude 的特性做了适配:
支柱
原则
在本文的落地
机械化架构约束
不靠自然语言约束 AI,用 类型检查 、 linter 、 物理规则收缩解空间
§2.3 约束外化 + §4 对照表
自动化验证闭环
让 AI 犯错和验证的成本趋近于零;出错自动反馈、自我修复
§2.5 验证闭环 + 工作流阶段 C / E
状态外置与长期记忆
把文件系统当 AI 的硬盘,不依赖对话记忆
§2.2 session 容器化 + handoff + tasks/
节俭的上下文管理
绝不把整个代码库或万行日志塞给 AI,按需获取
§2.4 context 管理 + §5 省 token
一句话版本:聊天和编码分离;约束外化为可执行 artifact;session 是一次性容器;验证自动化且成本趋零。
规则
本手册的每条规则按违反后的代价分为三个层级:
标签
含义
违反后果
🔴 必须
硬规则,不可跳过
违反会直接导致产出质量下降、context 腐坏或工作状态丢失
🟡 护栏
防御性建议,强烈推荐
不遵守不会立刻出事,但会增加出事的概率
🟢 建议
最佳实践,按需采纳
遵守了更好,不遵守也能正常工作,取决于个人习惯和任务复杂度
2.1 主对话只做需求澄清 🔴
主对话负责:澄清需求、定义范围、识别风险、讨论优先级、产出 task brief、做复盘。
不在主对话里做大规模代码修改、跑测试、粘贴海量日志。
简单任务豁免:改 typo、加一行配置、单文件小修——如果 5 分钟内能完成且不需要 plan,可以直接在当前对话做,不必新开 session。判断标准:改动是否足够小到不会污染当前上下文。
2.2 工程任务新开 session 🔴
一个工程 session 只做一个 coherent unit of work(一个 bug / 一个 feature / 一次重构 / 一次 review)。
2.3 约束必须外化 🔴
口头提醒不可靠。约束要落地为:
CLAUDE.md / .claude/rules/*.md / docs/ARCHITECTURE.md
hooks / skills / subagents
lint / typecheck / tests
task brief 里的 Constraints 和 Non-goals
凡是你重复提醒两次以上的事情,就应该升级成机制。
2.4 主动管理 context 寿命 🔴
不要把 compact 当正常工作流。当出现以下信号时,停止当前 session,写 handoff,重开:
Claude 反复读同一批文件、忘掉已讲过的约束
回答越来越长但推进越来越少
把小任务越做越大、开始合法化 unrelated refactor
循环修复——改了 A 破了 B,修了 B 又破了 A,来回打转
你已经感觉需要 /compact 才能继续
关于 context 阈值:没有精确的百分比硬线。不同任务对 context 质量的敏感度不同——简单 bug fix 可以容忍更长 session,复杂架构变更则应更早切断。核心判断依据是行为信号(上面列的那些),而不是数字。
2.5 验证必须自动化且成本趋零 🔴
不要害怕 AI 犯错,要害怕犯错之后没有反馈。
核心思路:你不需要自己写测试。你需要确保验证环节存在并且能自动运行——让 Claude 在实现的同时写测试或使用已有测试,改完自动跑,失败自动修。整个循环不需要人工介入。
落地方式:
最低限度:让 Claude 实现功能的同时写测试,实现后立刻跑 tests + typecheck,失败了 Claude 直接看报错并修复
进阶:用 hooks 自动过滤测试输出,只把失败项喂回;用 reviewer subagent 自动审查 diff
理想态:沙盒运行 → 提取 stderr → 静默反馈 → 自动修复,形成无人值守的验证闭环
判断标准:如果你需要手动复制粘贴报错给 Claude,说明验证闭环还没建好。
Harness 标准工作流
阶段 A:主对话 → 产出 task brief 🔴
请不要写代码,只做需求整理。
把下面需求整理成 tasks/TASK-<date>-<name>.md,包含:
- Goal / Scope / Constraints / Non-goals
- Acceptance criteria / Verification / Risks / Unknowns
- Relevant files/directories
结束条件:task brief 写完、影响范围清楚、验收标准明确、主要风险识别完毕。
阶段 B:新 session → 先 plan 🔴
Read: CLAUDE.md, docs/ARCHITECTURE.md, tasks/TASK-xxx.md
Do not implement yet.
Return: affected files, risks, minimal plan, verification steps
Constraints: minimal diff, no unrelated refactor, do not change public API
阶段 C:批准后 → 实现 🔴
🟡 大项目建议重开 session 再动手。 原因:
Plan 阶段产生的对话(方案比较、追问、废弃思路)对实现没用,但会一直占着 context
实现需要的 context 和 plan 不同——plan 要广(多文件、多方案),实现要深(聚焦改动、跑测试、看报错)
新 session 只读最终 plan 文件,起点更干净,Claude 不容易漂移
如果 plan 一轮就定了、对话很短,直接继续实现即可,不必强制重开。
Implement the approved plan.
Constraints: minimal diff, no unrelated refactor, preserve public API
Verify: <具体命令>
Return only: files changed, commands run, results, remaining risks
阶段 D:监测衰退 → 及时 handoff 🔴
出现 §2.4 中列出的衰退信号时立刻停止,要求 Claude 写 handoff:
Write handoff file with:
- current status / files changed / commands run
- passing checks / failing checks
- unresolved issues / exact next step / risks
- what not to revisit
阶段 E:收尾 → review + verify 🟡
这一步在实现 session 里直接做,不要重开。 原因:当前 session 已经有完整的改动 context(改了哪些文件、跑了什么测试、哪些通过),重开反而要重新读一遍 diff,浪费 token 且容易遗漏。
Before finishing, self-review:
- scope creep / unintended file changes / missing tests
- architecture violations / whether implementation matches task brief
Return: must-fix / should-fix / safe-to-defer
约束落地对照表
你想约束什么
应该落地为
不要改架构
docs/ARCHITECTURE.md + lints + reviewer checklist
不要碰 migrations
.claude/rules/migrations.md + path guard
每次改完要测试
CLAUDE.md Done definition + hook
只做最小改动
task brief Non-goals + reviewer subagent 检查 diff
大日志只看错误
hook 过滤 / shell 预处理,再给 Claude 看摘要
先计划后编码
默认 plan mode + task 模板固定流程
不要只靠嘴说——落地为可执行的机制。
省 Token 要点 🟢
CLAUDE.md 控制在 200 行以内,项目级规则才放这里;目录级拆到 .claude/rules/ ,专项流程拆到 skills
问得具体:动作 + 目标对象 + 位置 + 约束 + 验证 + 输出格式
高体积内容隔离:超长日志、大量测试输出、大范围搜索 → 交给 subagent
简单任务降低思考预算: /effort 或 Sonnet
能 one-shot 就不长聊: claude -p "query" 单次查询后退出
无关任务之间 /clear :顺手继续问另一个问题通常更贵
MCP 按需挂载:能用 CLI 工具解决就别上 MCP
Session 生命周期
继续当前 session 的条件(全部满足):
同一个任务、约束没变、范围没扩大、Claude 没漂移、context 健康
必须重开的条件(任一满足):
换了任务 / 目标变了 / 新增约束 / 明显漂移 / 需要大段重新解释背景
重开前一定写 handoff——把状态写成文件,不留在对话里。
反模式速查
反模式
后果
主对话里边聊需求边改代码
需求与实现互相污染,上下文快速膨胀
长 prompt 里塞一堆抽象原则
看起来全面,实际不可验证
快 compact 了还硬做
低质量输出继续滚大
一个 session 干探索+计划+实现+debug+review
上下文角色混杂,任务边界消失
贴巨量日志给 Claude
token 爆炸,真错误被淹没
每次口头重讲工程规矩
贵、不稳定、会讲漏
Checklist
开工前
☐ 主对话只做需求澄清,产出 task brief
☐ 关键约束已文件化
☐ 验收标准和验证命令明确
工程 session
☐ 先读 CLAUDE.md + 相关 docs + task brief
☐ 先 plan,不急着写
☐ 限制 scope / non-goals / 返回格式
实现中
☐ 按 plan 执行,不做计划外的事
☐ 出现漂移立刻停
☐ 不贴海量原始输出
收尾
☐ self-review / reviewer agent
☐ 写 handoff 文件
☐ 记录 remaining risk
☐ 关闭 session,下个 session 从文件继续
附录:理论依据
以下是本手册各条规则的理论依据,引用自 Anthropic 官方文档。
Session 不是长期记忆体:每个 Claude Code session 从全新 context window 开始,跨 session 的持久信息靠 CLAUDE.md 和 auto memory。
CLAUDE.md 是 context,不是强制配置:越具体、简洁、结构化,遵循效果越稳定。
Context 会腐坏(context rot):随 token 增长,accuracy 和 recall 下降。问题不是”还能不能塞进去”,而是”质量是否已经在下降”。
复杂任务应先 plan 再 implement:Plan Mode 让 Claude 先只读分析、收集需求、提出方案。
约束应机械化:hooks 可在生命周期事件自动运行, PreToolUse 可在工具执行前拦截。
高体积操作应隔离:subagents 运行在独立 context,冗长输出留在子上下文,只带摘要回来。
Skills 按需加载:把专项流程从 CLAUDE.md 挪到 skills 更省基础上下文。