AI Agent
12 章 · 约 176 千字
目录
- 从零开始搞懂AI Agent
- 从0-1完成AI Agent搭建-图文版
- 从0到1开发一个商用 Agent(智能体)
- 基于Agent的智能客服项目(已交付)
- 0-1基于dify搭建智能体(Agent)助手
- FinRobot:基于LLM的金融分析AI Agent
- 基于Agent搭建ai论文写作程序
- 基于Agent的数据分析实战项目
- 0-1基于Agent的智能客服
- LangChain智能体开发实战:从零构建企业级AI助手
- 从多智能体协作到 AutoGPT 核心复现
- Cursor + Agent 输出高保真产品原型图
从零开始搞懂AI Agent
1. AI Agent是什么?
AI Agent(也称人工智能代理) 是一种能够 感知环境、进行决策和执行动作的智能实体 。智能体像人一样,它有记忆、有逻辑分析能力、有任务的拆解能力、问题的拆解能力和最后综合回来统一解决问题的能力。
AI Agent也可以称为“智能体”,也可理解为 “智能业务助理” ,旨在大模型技术驱动下,让人们以自然语言为交互方式高自动化地执行和处理专业或繁复的工作任务,从而极大程度释放人员精力。
Agent 其实基本就等于 "大模型 + 插件 + 执行流程 / 思维链" , 分别会对应控制端 (Brain / 大脑)、感知端 (Preception)、执行端 (Action) 环节,如下,
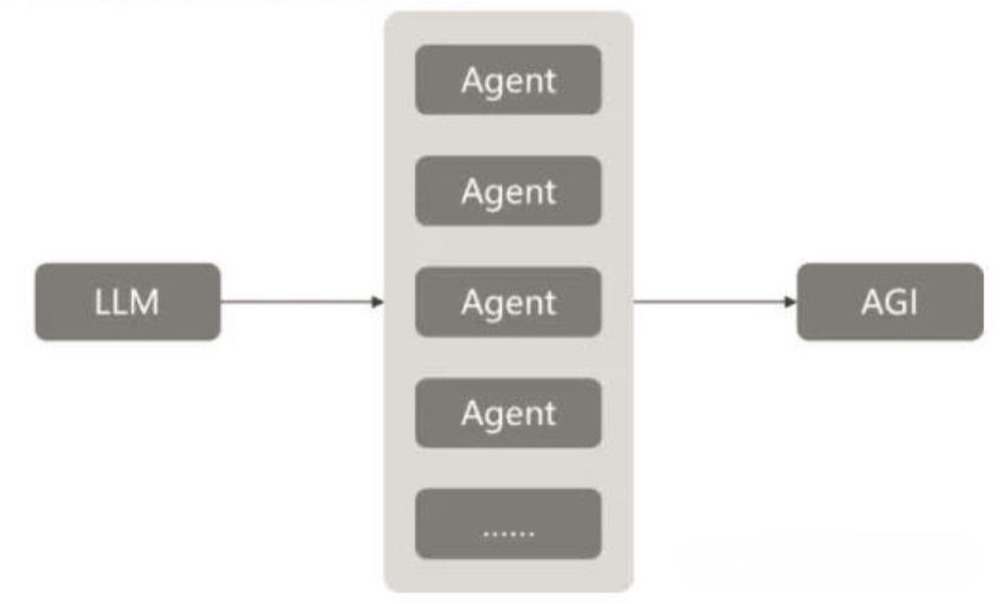
Agent示意图
2.Agent的构建
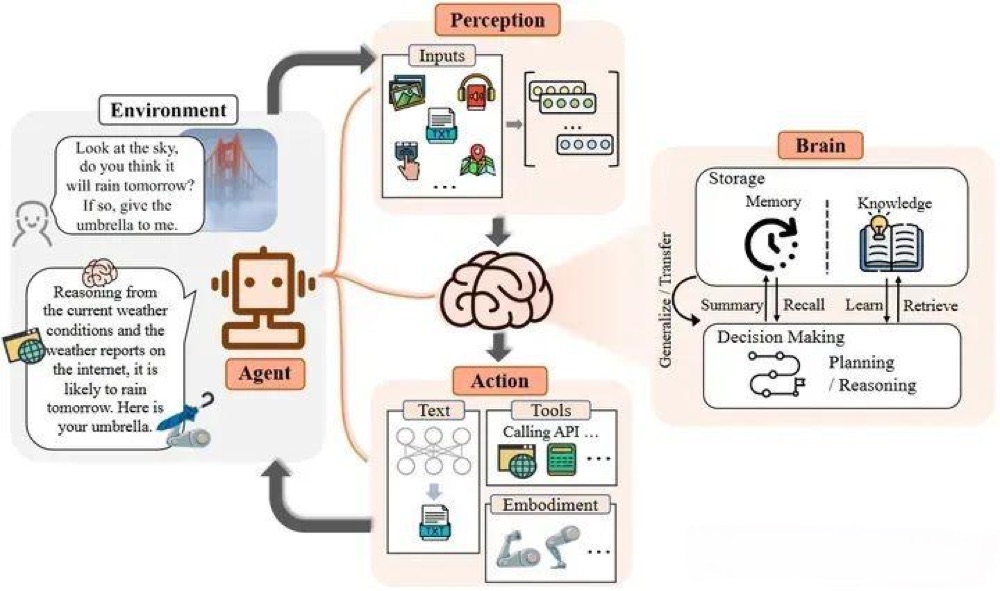
一个基于大模型的 AI Agent 系统 可以拆分为大模型、规划、记忆与工具使用四个组件部分。
AI Agent 可能会成为新时代的开端,其基础架构可以简单划分为 Agent = LLM + 规划技能 + 记忆 + 工具使用, LLM 扮演了 Agent 的“大脑”,在系统中提供推理、规划等能力。
2.1 大脑模块
大脑主要由一个大型语言模型组成, 不仅存储知识和记忆,还承担着信息处理和决策等功能, 并可以呈现推理和规划的过程,能很好地应对未知任务。
运行机制: 为确保有效交流,自然语言交互能力 至关重要。在接收感知模块处理的信息后,大脑模块首先转向存储,在知识中检索 并从记忆中回忆 。
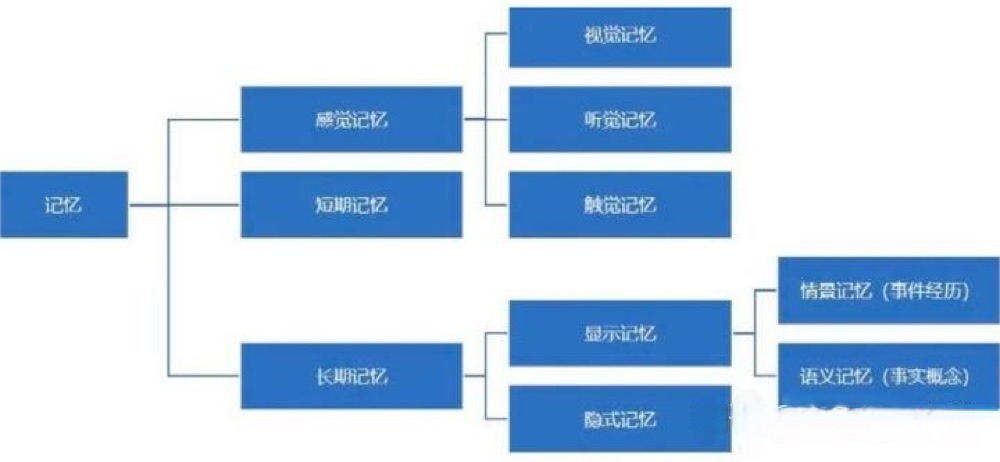
记忆类型
映射
例子
感觉记忆
学习原始输入的嵌入表示,包括文本、图像或其他形式,短暂保留感觉印象
看一张图片,然后在图片消失后能够在脑海中回想起他的视觉印象
短期记忆
上下文学习(比如直接写入prompt中的信息),处理复杂任务的临时存储空间,受有限的上下文的长度限制
在进行心算时记住几个数字,但短期记忆是有限的,只能暂时保持几个项目
长期记忆
在查询时agent可以关注的外部向量存储,具有快速检索和基本无限的存储容量
学会骑自行车后,多年后再骑起来时仍能掌握这项技能,这要归功于长期记忆的持久存储
自然语言交互
作为一种交流媒介,语言包含着丰富的信息。 除了直观表达的内容,背后还可能隐藏着说话者的信念、 愿望和意图。
由于 LLM 本身具有强大的自然语言理解和生成能力, Agent不仅可以熟练地使用多种语言进行基本的交互式对话, 还能有深入理解能力,使人类能够轻松地理解Agent并互动。
多轮交互对话
多轮对话能力是有效和一致交流的基础。作为大脑模块的核心, LLM能够理解自然语言并生成连贯且与上下文相关的回复, 从而帮助Agent更好地理解和处理各种问题。然而,即使是人类也很难在一次交流中不出现混乱,因此需要多轮对话。
与 SQuAD 等传统的纯文本阅读理解任务相比,多轮对话具有以下几个特点:
具有交互性,涉及多个说话者,缺乏连续性;
可能涉及多个话题,对话信息也可能是冗余的,使得文本结构更加复杂。
一般来说,多轮对话主要分为三个步骤:
(1) 了解自然语言对话的历史;
(2) 决定采取什么行动;
(3) 生成自然语言回应。
LLM-based Agent能够利用现有信息不断完善输出,进行多轮对话并有效实现最终目标。
高质量的自然语言生成: 最新的 LLM 展示了卓越的自然语言生成能力,可持续生成多种语言的高质量文本。
这些语言模型可以“适应调节文本的风格和内容”,而像ChatGPT这样的模型在语法错误检测方面表现出色,凸显了其强大的语言能力。
意图和含义理解: 尽管在大规模语料库中训练出来的模型已经具有足够的智能来理解指令,但它们中的大多数仍无法模拟人类对话或充分利用语言所传达的信息。
要想与其他智能机器人进行有效的交流与合作,理解其隐含的意思至关重要,并使人们能够解释他人的反馈。
LLMs 的出现凸显了基础模型在理解人类意图方面的潜力, 但当涉及到模糊指令或其他含义时, 就会给Agent带来巨大挑战。
知识
在大规模数据集上训练的语言模型可以将各种知识编码到其参数中,并对各种类型的查询做出正确的反应。
所有这些知识可大致分为以下几类:
语言知识: 语言知识表现为一个约束系统,即语法,定义了语言的所有和句子。
常识知识: 常识性知识指的是大多数人在幼年时就已掌握的世界常识。
专业领域知识: 专业领域知识是指与特定领域相关的知识。
记忆
在本文的框架中,“记忆”存储了Agent过去的观察、思考和行动序列,这与 Nuxoll 等人提出的定义类似。
在面对复杂问题时, 记忆机制能帮助行为主体有效地重新审视和应用先前的策略。 此外,这些记忆机制还能使个体借鉴过去的经验,适应陌生的环境。
随着LLM-based Agent互动周期的扩大,出现了两个主要挑战。
第一个挑战与历史记录的长度有关。LLM-based Agent以自然语言格式处理先前的交互,并将历史记录附加到每个后续输入中。
第二个挑战是提取相关记忆的难度。当Agent积累了大量的历史观察和行动序列时,它们就会面临不断升级的记忆负担。
提高记忆能力的方法
下面介绍几种增强LLM-based Agent记忆能力的方法。
提高Trransformer的输入长度限制: 第一种方法试图解决或减轻固有的序列长度限制。由于这些固有限制,Transformer架构很难处理长序列。
总结记忆: 提高记忆效率的第二种策略取决于记忆总结的概念。这能确保Agent毫不费力地从历史互动中提取关键细节。
用向量或数据结构压缩记忆: 通过采用合适的数据结构,智能Agent可提高记忆检索效率,促进对交互做出迅速反应。
记忆检索方法
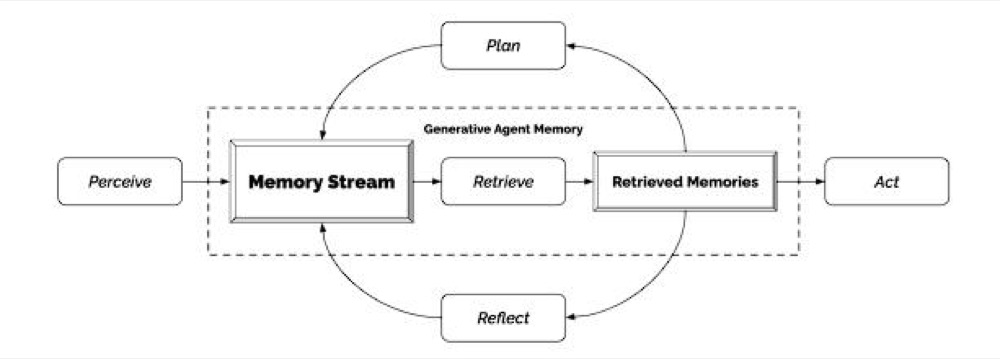
当Agent与其环境或用户交互时, 必须从其内存中检索最合适的内容。 这可确保Agent访问相关的准确信息,以执行特定操作。
这就产生了一个重要问题: Agent如何选择最合适的存储器?通常情况下,Agent要求存储器具有自动检索记忆的能力。
自动检索的一个重要方法是考虑三个指标: 最近性(Recency) 、 相关性(Relevance) 和 重要性(Importance) 。
记忆得分由这些指标加权组合而成,得分最高的记忆在模型的上下文中被优先考虑。
推理和规划
推理(Reasoning): 推理以证据和逻辑为基础,是人类智力活动的根本,是解决问题、决策和批判性分析的基石。演绎、归纳和归纳是智力活动中常见的主要推理形式。
规划(Planning): 规划是人类在面对复杂挑战时采用的一种关键策略。对人类来说,规划有助于组织思维、设定目标和确定实现这些目标的步骤。
计划制定: 在制定计划的过程中,Agent通常会将总体任务分解成许多子任务,在这一阶段,人们提出了各种方法。
计划反思: 制定计划后,必须对其优点进行反思和评估。LLM-based Agent可利用内部反馈机制(通常是从已有模型中汲取灵感)来完善和改进其战略和规划方法。
可迁移性和通用性
在大规模语料库上预先训练的模型可以学习通用语言表征。 利用预训练模型的强大功能,只需少量数据进行微调,LLMs 就能在下游任务中表现出卓越的性能。
看不见的任务泛化: LLMs 可以根据自己的理解,按照指令完成在训练阶段没有遇到过的新任务。
情境学习: 大量研究表明,LLM 可以通过上下文学习(ICL)完成各种复杂任务,上下文学习指的是模型从上下文中的几个例子中学习的能力。
持续学习: 最近的研究强调了 LLM 的规划能力在促进Agent持续学习方面的潜力,这涉及技能的持续获取和更新。
2.2 感知模块
感知模块的核心目的是将Agent的感知空间从纯文字领域扩展到包括文字、听觉和视觉模式在内的多模态领域。
文本输入
LLM-based Agent已经具备了通过文本输入和输出与人类交流的基本能力。 在用户的文本输入中,除了明确的内容外,还隐藏着信念、愿望和意图。
视觉输入
视觉输入通常包含大量有关世界的信息, 包括Agent周围环境中物体的属性、空间关系、场景布局等。因此,将视觉信息与其他模式的数据整合在一起, 可以为Agent提供更广泛的背景和更精确的理解,加深Agent对环境的感知。
听觉输入
一个非常直观的想法是, Agent可以将 LLMs 用作控制中心, 以级联方式调用现有工具集或模型库来感知音频信息。
其他输入
如前所述,许多研究都对文本、视觉和音频的感知单元进行了研究。 然而,LLM-based Agent可能会配备更丰富的感知模块。 未来,它们可以像人类一样感知和理解现实世界中的各种模式。
2.3 行动模块
人类在感知环境后,大脑会对感知到的信息进行整合、分析和推理,并做出决策。随后,他们利用神经系统控制自己的身体,做出适应环境或创造性的行动,如交谈、躲避障碍或生火。
文本输出
基于Transformer的大型语言生成模型的兴起和发展, 赋予了LLM-based Agent以固有的语言生成能力。 它们生成的文本质量在流畅性、相关性、多样性和可控性等各个方面都出色。
工具使用
工具是工具使用者能力的延伸。在面对复杂任务时, 人类会使用工具来简化任务的解决过程并提高效率, 从而节省时间和资源。
LLM-based Agent决策过程缺乏透明度,使其在医疗保健和金融等高风险领域的可信度较低。
LLM 容易受到对抗性攻击, 对轻微输入修改的鲁棒性不足。 相比之下,借助工具完成任务的Agent则表现出更强的可解释性和鲁棒性。
理解工具: Agent有效使用工具的前提是全面了解工具的应用场景和调用方法。没有这种理解,Agent使用工具的过程将变得不可信,也无法真正提高Agent的能力。
使用工具: Agent学习使用工具的方法主要包括从demonstartion中学习和从reward中学习(清华有一篇从训练数据中学习的文章)。
制作自给自足的工具: 现有的工具往往是为方便人类而设计的,这对Agent来说可能不是最佳选择。为了让Agent更好地使用工具,需要专门为Agent设计工具。
工具可以拓展LLM-based Agent的行动空间: 在工具的帮助下,Agent可以在推理和规划阶段利用各种外部资源,如外部数据库和网络应用程序。
最近的研究表明,利用在 LLM 预训练期间获得的丰富内部知识可以有效缓解这些问题:
成本效益: 一些基于策略的算法在样本效率方面存在困难。
具身动作泛化: 面对错综复杂、未知的真实世界环境,Agent必须具备动态学习和泛化能力。
嵌入式行动规划: 规划是人类和LLM-based Agent在应对复杂问题时采用的关键策略。
具身action for LLM-based Agent: 根据Agent在任务中的自主程度或行动的复杂程度,有几种基于 LLM 的基本具身行动,主要包括观察、操纵和导航。
观察: 观察是Agent获取环境信息和更新状态的主要方式,对提高后续体现行动的效率起着至关重要的作用。
操纵: 一般情况下,具身Agent的操纵任务包括物体重新排列、桌面操纵和移动操纵。典型的情况是,Agent在厨房执行一系列任务,包括从抽屉中取出物品并递给用户,以及清洁桌面。
导航: 导航允许Agent动态地改变其在环境中的位置,这通常涉及多角度和多目标观测,以及基于当前探索的远距离操作。
通过整合这些功能,Agent可以完成更复杂的任务, 如体现式问题解答,其主要目标是自主探索环境并回答预先定义的多模态问题。
3.Agent实践
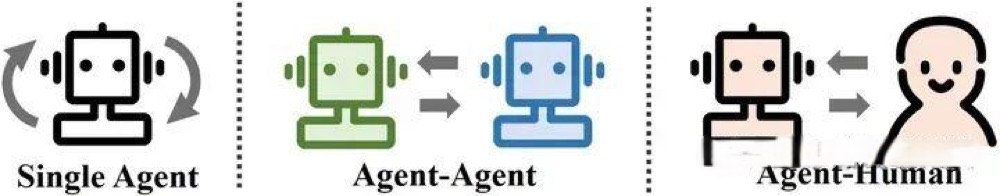
作为一个LLM-based Agent,其设计目标应始终对人类有益,也就是说,人类可以利用人工智能造福人类。具体来说, 希望Agent能实现以下目标:
帮助用户从日常任务和重复劳动中解脱出来,从而减轻人类的工作压力,提高任务解决效率。
不再需要用户提供明确的低级指令。 相反,Agent可以独立分析、规划和解决问题。
在解放用户双手的同时,Agent也解放了他们的大脑,使其能够从事探索性和创新性工作。
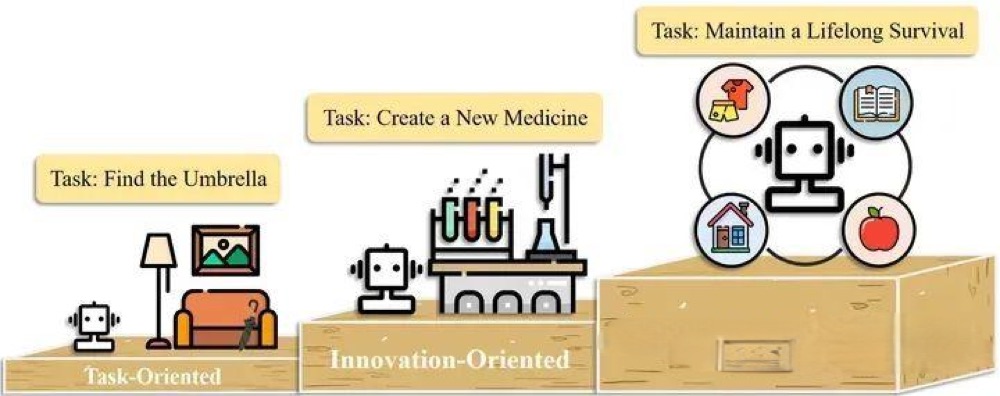
3.1 单个Agent的一般能力
目前, LLM-based Agent应用实例的发展十分活跃。 AutoGPT 是目前流行的开源项目之一,旨在实现完全自主的系统。
面向任务的部署
LLM-based Agent 可以理解人类的自然语言指令并执行日常任务, 是目前最受用户青睐、最具实用价值的Agent之一。 这是因为它们具有提高任务效率、减轻用户工作量和促进更广泛用户访问的潜力。
在网络场景中:
在网络场景中代表用户执行特定任务被称为网络导航问题。 Agent解释用户指令,将其分解为多个基本操作,并与计算机进行交互。
生活场景中:
在生活场景中的许多日常家务劳动中, Agent必须理解隐含指令并应用常识性知识。 对于完全基于海量文本训练的 LLM-based Agent 来说,人类认为理所当然的任务可能需要多次试错尝试。更现实的场景往往会产生更模糊、更微妙的任务。
面向创新的部署
LLM-based Agent 在执行任务和提高重复性工作的效率方面表现出了强大的能力。 然而,在智力要求更高的领域, 如前沿科学领域,Agent 的潜力尚未得到充分发挥。
这种局限性主要来自两个方面的挑战:
一方面, 科学本身的复杂性构成了重大障碍,许多特定领域的术语和多维结构难以用单一文本表示。
另一方面, 科学领域严重缺乏合适的训练数据,使得Agent难以理解整个领域的知识。
面向生命周期的部署
在一个开放、未知的世界中, 建立一个能够不断探索、发展新技能并保持长期生命周期的、 具有普遍能力的Agent是一项巨大的挑战。
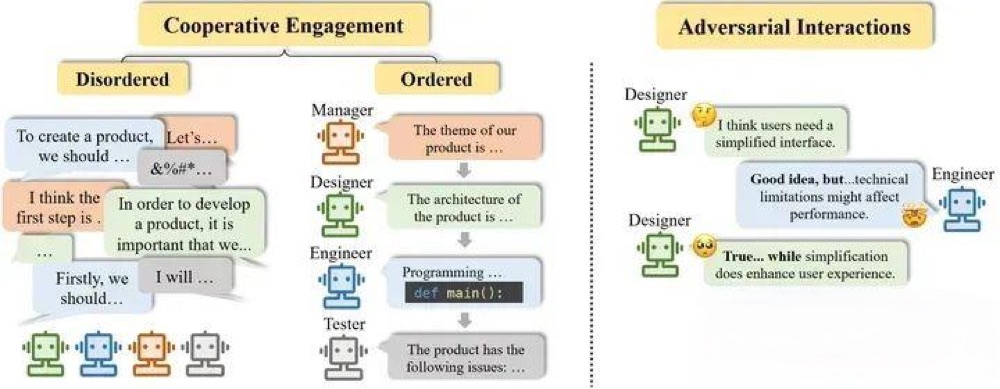
3.2 Multi-Agent的协调潜力
潜在优势:
具体来说, LLM-based multi-Agent系统可以提供几种优势。 根据分工原则,具备专业技能和领域知识的单个Agent可以从事特定的任务。
互补性合作交互
在当前基于 LLM 的多Agent系统中,Agent之间的交流主要使用自然语言,这被认为是最自然、最易为人类理解的交互形式。 将现有的多Agent合作应用分为两类:无序合作和有序合作。
无序合作:
当系统中有三个或三个以上的Agent时, 每个Agent都可以自由地公开表达自己的观点和意见。 他们可以提供反馈和建议,以修改与当前任务相关的反应。
有序合作:
当系统中的Agent遵守特定规则时, 例如按顺序逐一发表意见,下游Agent只需关注上游的产出。 这样,任务完成效率就会大大提高,整个讨论过程也会变得井然有序。
对抗性互动促进进步
在竞争环境中,Agent可以通过动态互动迅速调整策略,努力选择最有利或最合理的行动来应对其他Agent引起的变化。在基于非 LLM 的竞争领域,已经有成功的应用。
然而,该系统基本上依赖于 LLM 的力量, 并面临着一些基本挑战:
在长时间的辩论中,LLM 有限的语境无法处理整个输入。
在多Agent环境中,计算开销大大增加。
多Agent协商可能会收敛到不正确的共识,而所有Agent都坚信其准确性。
3.3 人类与Agent之间的互动参与
随着Agent能力的增强,人类的参与变得越来越重要,以便有效地指导和监督Agent的行动,确保它们符合人类的要求和目标。
人类与Agent之间的互动可分为两种模式:
(1) 不平等互动(即指导者-执行者范式): 人类是指令的发布者,而Agent则是执行者,基本上是作为人类的助手参与协作。
(2) 平等互动(即平等伙伴关系范式): Agent达到人类的水平,与人类平等地参与互动。
指导者-执行者范式
最简单的方法是人类全程指导: 人类直接提供明确而具体的指令,而Agent的作用是理解人类的自然语言指令,并将其转化为相应的行动。
在此,将反馈大致分为两种类型:定量反馈和定性反馈。
平等伙伴关系范式
富有同情心的交流者:
对话式Agent以个性化定制角色和虚拟聊天机器人等各种形式在研究领域引起了广泛关注。
人类层面的参与者:
Agent能够参与人类的正常生活,从人类层面的角度与人类合作完成任务。
4.Agent典型应用项目
AutoG-T
是一个基于ChatG-T完成多目标复杂任务的应用。是综合网络搜索、大语言模型调用、文件读写、python和shell脚本执行等功能框架,综合这些功能,可以自动帮我们完成多目标复杂的任务。
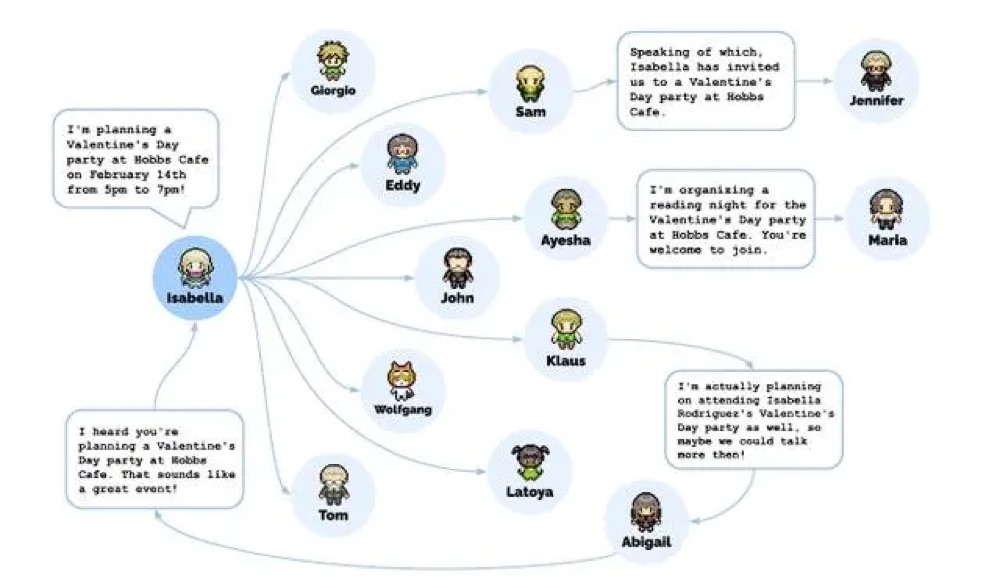
trigger prompt
"user": "Determine which next command to use, and respond using the format specified above:"
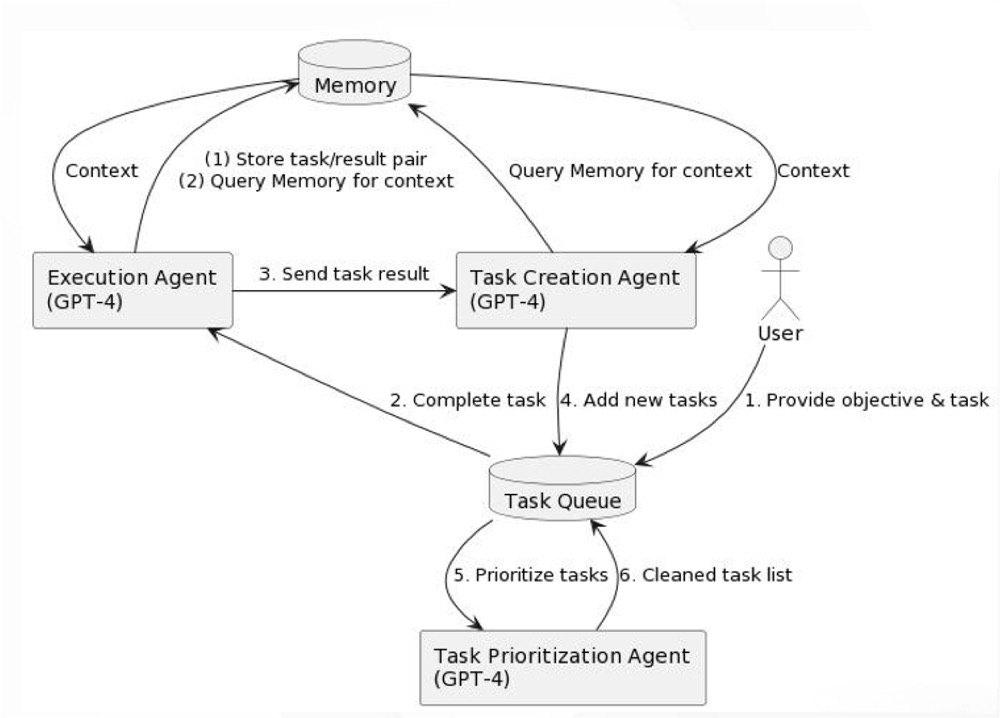
BabyAGI
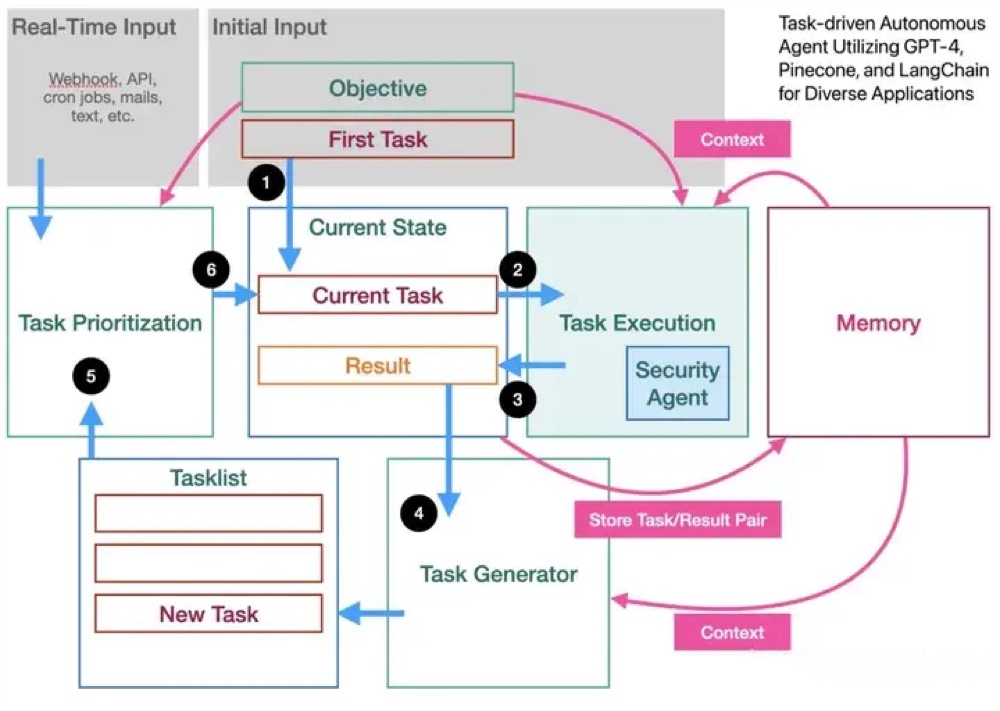
是一个 AI 支持的任务管理系统示例,它根据初始任务或目标,利用OpenAI创建任务列表,并对任务进行优先级排序和执行任务。 其背后的主要思想是基于先前任务的结果和预定义的目标创建任务, 然后使用 OpenAI 的能力根据目标创建新任务。这是原始的任务驱动的自驱Agent(2023 年 3 月 28 日)的简化版本。
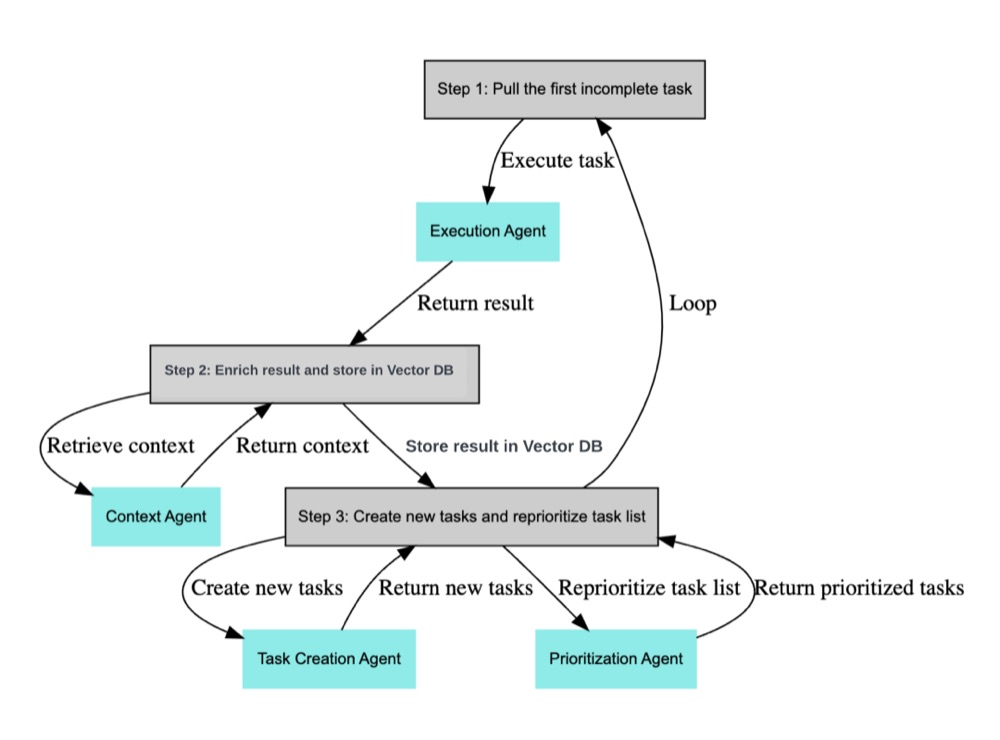
SuperAGI
一个开发优先的开源自主人工智能代理框架。使开发人员能够快速可靠地构建、管理和运行有用的代理。
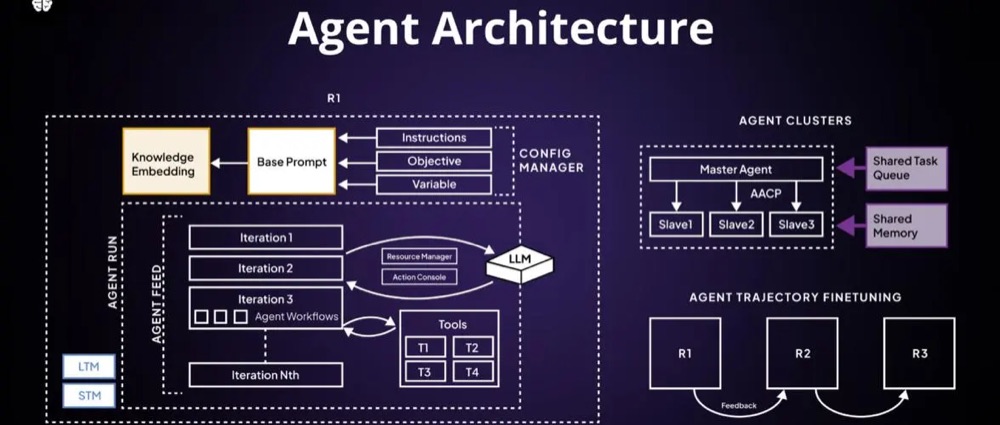
创建Agent
智能体是SuperAGI中执行任务的主要实体。要创建一个:
from superagi_client import AgentConfig
agent_config = AgentConfig(
name="Sample Agent",
description="A descriptive purpose of the agent.",
goal=["Define a specific task for the agent"],
instruction=["Provide additional guiding instructions"],
agent_workflow="Goal Based Workflow",
constraints=[],
tools=[{"name": "ToolName"}],
iteration_interval=500,
max_iterations=10,
model="G-T-4"
)
agent = client.create_agent(agent_config=agent_config)
运行Agent
agent_id = agent['agent_id']
run_agent = client.create_agent_run(agent_id=agent_id)
智能体启动成功之后,会返回一个执行ID:run_id
这将检索与指定agent_id关联的运行的状态。 若要筛选特定的运行或状态,可以使用 AgentRunFilter 类型。
ShortG-T
ShortG-T 是一个由开发者 RayVentura 创建的开源项目,致力于在有限的字数内生成高质量、连贯的文本。该项目基于 OpenAI 的 G-T-2 模型,通过微调和优化,能够在极短的文本序列中产生令人印象深刻的结果。
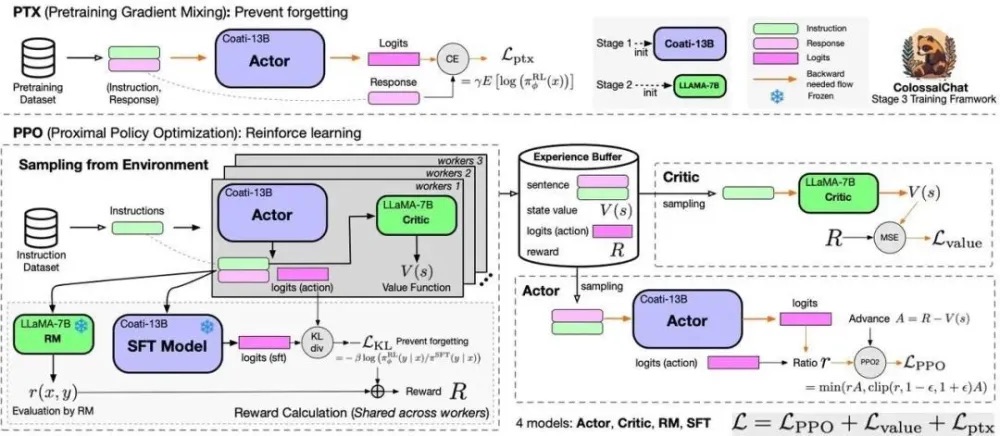
技术分析
基础模型:G-T-2
G-T-2(Generative Pre-trained Transformer 2)是 OpenAI 在2019年发布的预训练语言模型。 它使用自注意力机制,能够理解整个输入序列的信息,并生成与上下文相关的响应。在 ShortG-T 中,G-T-2 的强大语义理解和生成能力被进一步利用,以适应更紧凑的文本生成任务。
微调与优化
RayVentura 对原始的 G-T-2 进行了特定场景的数据集微调,使其更适合处理短文本任务。这包括对数据集的选择、训练策略的调整以及可能的参数优化,以确保在有限字符数量下也能保持良好的语义准确性和流畅性。
应用场景
创意写作: 为作家和创意人员提供灵感, 快速生成故事开头、诗歌片段或新闻标题。
自动摘要: 针对长篇文章,可以生成简明扼要的总结。
智能助手: 在对话系统中, 用于生成简洁而有意义的回答。
营销文案: 快速构思广告标语或社交媒体帖子。
教育工具: 帮助学生理解概念, 通过简短的例子或解释来阐述复杂的知识点。
特点
高 效 - 能在短短几句话内传达关键信息。
适应性强 - 可以根据不同的主题和风格进行微调, 满足不同应用场景的需求。
开放源码 - 开放社区的持续贡献和支持,使得模型不断改进。
易于集成 - 提供清晰的文档和示例代码, 便于其他开发人员将其整合到自己的项目中。
可以使用以下代码来生成简短回答:
import openai
设置你的OpenAI API密钥
openai.api_key = "YOUR_OPENAI_API_KEY"
def get_short_G-T_answer(question, model="G-T-4"):
response = openai.Completion.create(
engine=model,
prompt=question,
max_tokens=7, # 设置生成的最大token数,7 tokens大约对应3个单词
n=1, # 生成1个可能的回答
stop=None, # 可以设置停止符,例如".", "!"等,根据需要使用
temperature=0.5, # 设置生成的文本的随机性,0.0为完全随机,1.0为完全按概率分布
)
return response.get("choices")[0].get("text")
示例问题和使用
question = "What is the capital of the United States?"
answer = get_short_G-T_answer(question)
print(answer)
ChatDev
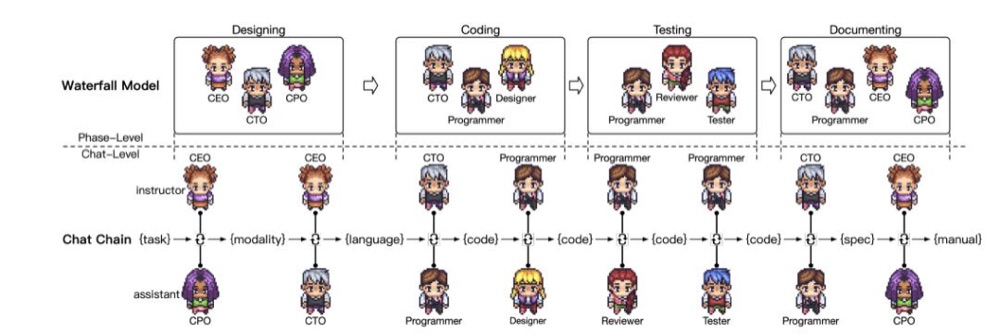
是一个基于大型语言模型(LLMs)的框架,旨在通过多智能体协作创建定制化软件,使用自然语言概念来革新数字世界。
库的特性和优势
高度定制化和扩展性: ChatDev 提供了一个易于使用的框架,可以高度定制和扩展,适合研究集体智能。
多智能体组织结构: 它通过不同角色的智能代理(如 CEO、CTO、程序员等)形成多智能体组织结构,参与设计、编码、测试和文档化等专业功能研讨会。
实验共学模块: 2024年1月,ChatDev集成了体验式共学模块,采用创新方法让指导者和助手代理积累面向快捷方式的经验,有效解决新任务,减少重复错误,提高效率。
库应用场景
软件开发: ChatDev 作为一个 SaaS 平台,使得软件开发人员和创新企业家能够高效、低成本、低门槛地构建软件。
增量开发: 支持在现有代码上进行开发的增量开发功能,允许代理在现有代码基础上进行进一步开发。
人机交互: 通过“人机交互”模式,用户可以扮演审阅者的角色,对程序员的工作提出建议,促进人机协作。
以下是一个简单的Python示例,展示如何使用 random 模块生成一个随机的聊天机器人回复。
import random
定义一个包含不同回复的列表
responses = [
"当然可以",
"我能做到",
"我正在尝试",
"我不能这么做",
"对不起,我不明白",
"请再重复一次",
"请问具体问题是什么?",
"你好,我现在正在线上"
]
定义一个函数,返回随机的回复
def get_random_response():
return random.choice(responses)
测试函数
print(get_random_response())
MetaG-T
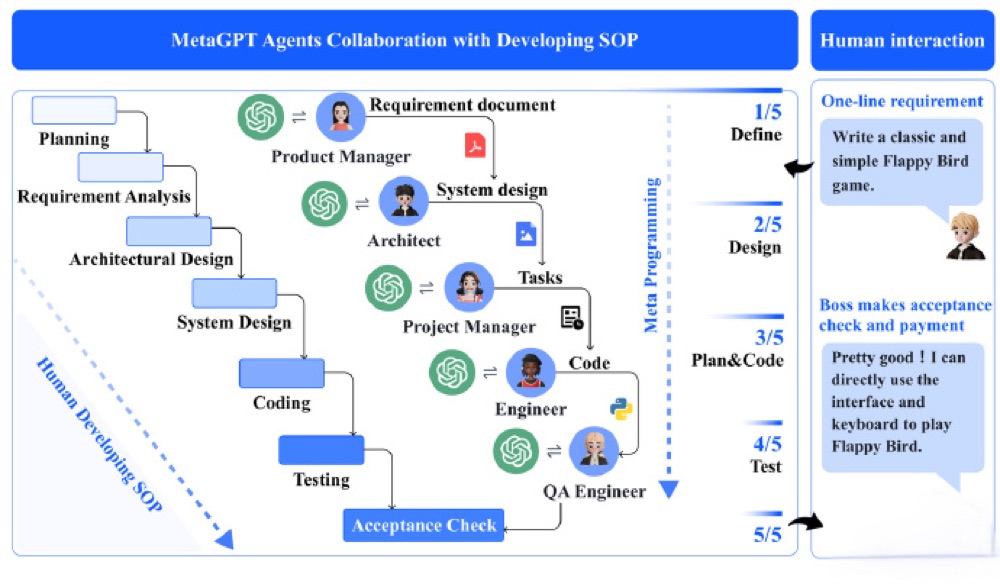
是一个基于AI Agent的大模型框架,专注于软件开发,从需求分析到代码实现等实现了全流程的覆盖。
优势
多Agent组成协作处理更复杂的任务。
通过将SOP融入到多智能体协作中,解决了现有方法在处理复杂任务时存在的幻觉问题。
通过结构化协调和模块化输出, 能够有效地解决复杂的多智能体协作问题。
智能体可以主动从环境中获取相关知识,而不是简单地通过对话获取信息。 这种设计更符合人类组织的运作模式。
劣势
偶尔会引用不存在的资源文件, 如图像和音频。
在执行复杂任务时, 它容易调用未定义或未导入的类或变量。
角色和流程还比较固定, 无法实现动态扩展,如扩展UI设计角色。
Camel
是Communicative Agents for “Mind” Exploration of Large Scale Language Model Society的缩写,大意为大规模语言模型社会的“心智”探索通讯智能体。
贡献点:
1)引入了一种新的沟通式智能体(通过角色扮演实现), 让智能体在最少的人工干预下通过自主合作,共同完成任务;
2)提供了一种为研究多智能体合作行为和能力的可扩展方法, 阐述了实现自主合作的挑战,并提供了应对这些挑战的策略。
3)开源了CAMEL智能体,其中包含各种智能体的实现、 数据生成流程、数据分析工具和收集的数据集,以支持沟通时智能体等领域的研究及更多其他相关领域的研究。
实现原理
角色扮演框架
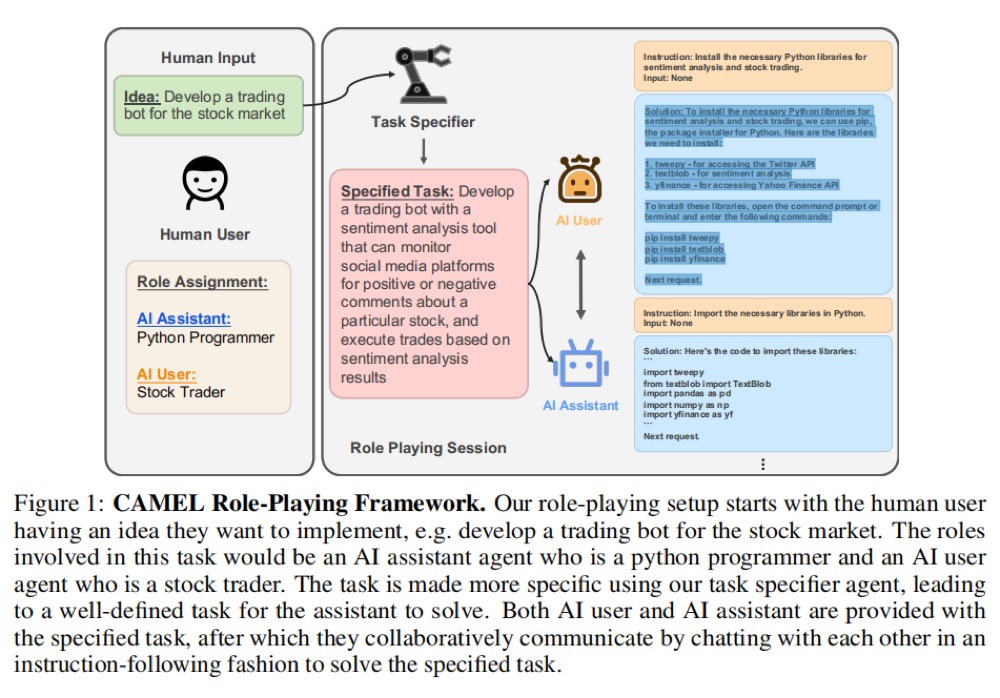
CAMEL专注于以任务为导向的角色扮演,包含一个AI助理 (AI Assistant) 和一个AI用户 (AI User) 。在 多智能体系统 接收到人类用户的初步想法和角色分配后,任务指定智能体将提供详细的描述,使想法更加具体化。
然后,AI助理和AI用户将通过多轮对话合作完成指定的任务, 直到AI用户确定任务完成为止。一方面,AI用户负责向AI助理提供指令,并引导对话朝着任务完成的方向进行;另一方面,AI助理则需要遵循AI用户的指示,做出回答并提供具体的解决方案。
人类输入和任务说明
角色扮演会话将从人类的想法和选择的角色开始。想开发一个用于股市的交易机器人,然后选择了一个 Python程序员 和一个 股票交易员 两个角色。
在确定了想法和角色之后,任务指定智能体将根据输入的想法,为AI助理角色提出一个具体的任务, 以帮助AI用户角色完成任务。引入任务指定智能体主要原因为对话智能体通常需要一个具体的任务提示来实现任务,而对于非领域专家来说,这可能具有挑战性或费时。
以下是简单的代码使用示例
conda create --name camel python=3.10
conda create --name camel python=3.10
git clone -b v0.1.0 https://github.com/camel-ai/camel.git
cd camel
pip install -e .
JARVIS
处理任务规划、模型选择、任务执行和内容生成。通过访问HuggingFace中心中的数十个专用模型,利用ChatG-T的推理能力将最佳模型应用于给定任务。
系统的工作流程由四个阶段组成:
任务规划: 使用ChatG-T分析用户的请求,了解他们的意图, 并将其分解为可能的可解决的任务。
模型选择: 为了解决计划的任务, ChatG-T根据描述选择Hugging Face上托管的专家模型。
任务执行: 调用并执行每个选定的模型,并将结果返回给ChatG-T。
响应生成: 最后,使用ChatG-T整合所有模型的预测,并生成响应。
OpenAGI
是指开放式人工智能,即一种可以从经验中学习和自我完善的AI系统。
AGI 研究平台专门设计提供复杂的多步任务以及相应的数据集、评估方法和各种可扩展模型,这些模型可以被综合以有效地解决这些任务。
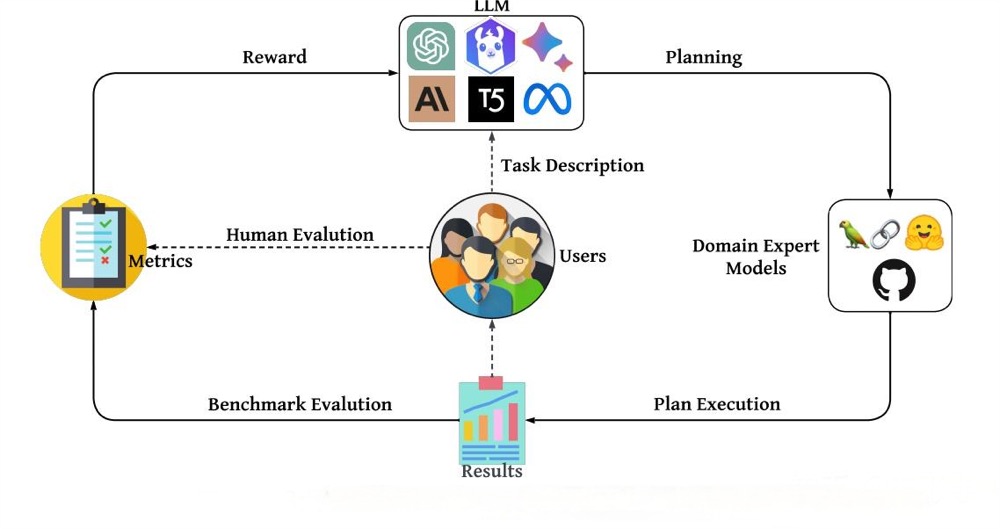
以下是一个简单的代码示例
class SimpleEnvironment:
def __init__(self):
self.agents = []
self.state = {}
def add_agent(self, agent):
self.agents.append(agent)
def step(self):
for agent in self.agents:
action = agent.act(self.state)
self.state = self.apply_action(action)
def apply_action(self, action):
这里应该包含对环境状态的更新逻辑
例如,移动Agent的位置,或是触发某些效果
return self.state # 这里简化地返回当前状态
class SimpleAgent:
def __init__(self):
pass
def act(self, state):
这里应该包含Agent的决策逻辑
例如,基于当前状态选择一个随机动作
return "action" # 返回一个动作
创建环境和Agent
env = SimpleEnvironment()
agent = SimpleAgent()
将Agent添加到环境中并开始交互
env.add_agent(agent)
env.step()
XAgent
是一个开源的基于大型语言模型(LLM)的自主智能体,能够自动解决各种任务。它旨在成为一个通用的智能体,应用于各种任务。
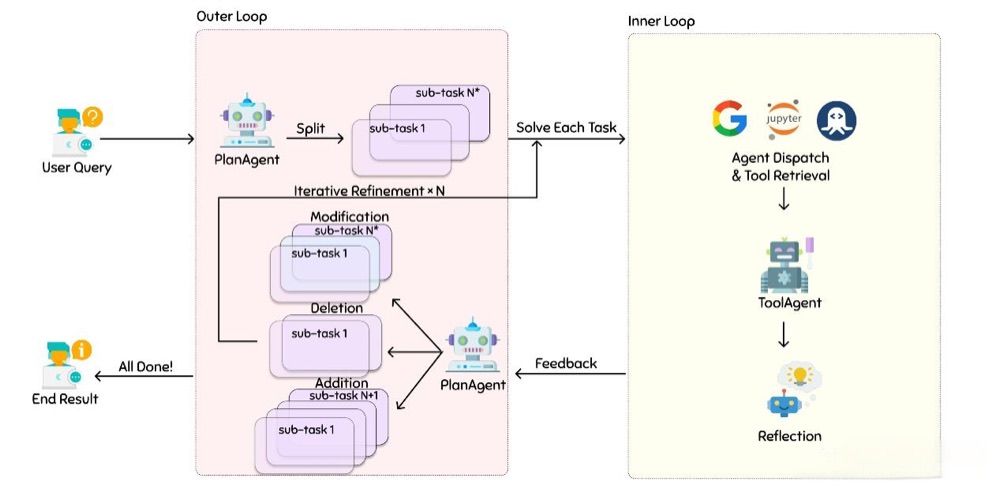
XAgent的特性:
自主/自治: XAgent可以无须人工干预自动完成各种任务.
安全: XAgent旨在安全运行, 所有的action约束在docker容器中执行.
可扩展性: XAgent 做了可扩展性设计,可以容易地增加新工具加强agent的能力,甚至可以增加新的agenti.
界面化: XAgent 为用户提供友好的agent交互界面, 当然也可以使用命令行接口与agent交互。
人机协作: XAgent 可以与人协作处理任务,不仅是在解决复杂任务遵循人类的指导, 当agent遇到挑战时也能够寻求人类的帮助。
XAgent的构成:
Dispatcher
负责动态实例化和派发任务给不同的agent, 允许用户新增agent并改善它们的能力
Planner
负责生成和修正任务计划。 将任务拆分为子任务并为它们生成里程碑,允许agent一步一步地完成任务
Actor
负责采取行动达成目标和完成子任务。 actor使用各式各样的工具处理子任务,同时也可以与人类合作完成任务
从0-1完成AI Agent搭建-图文版
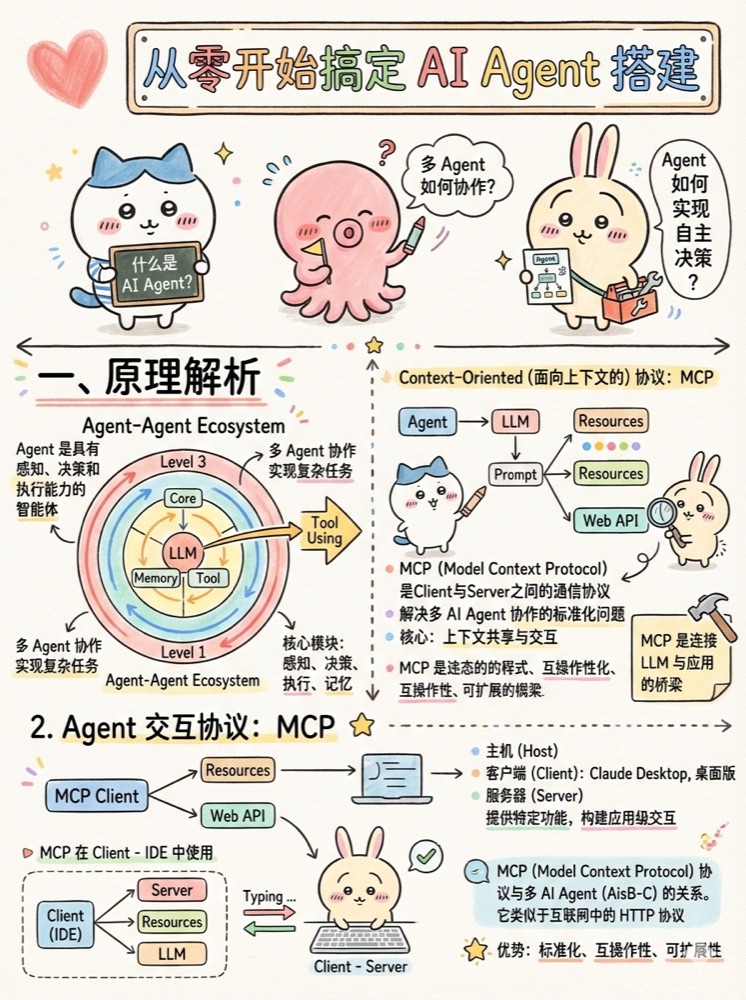
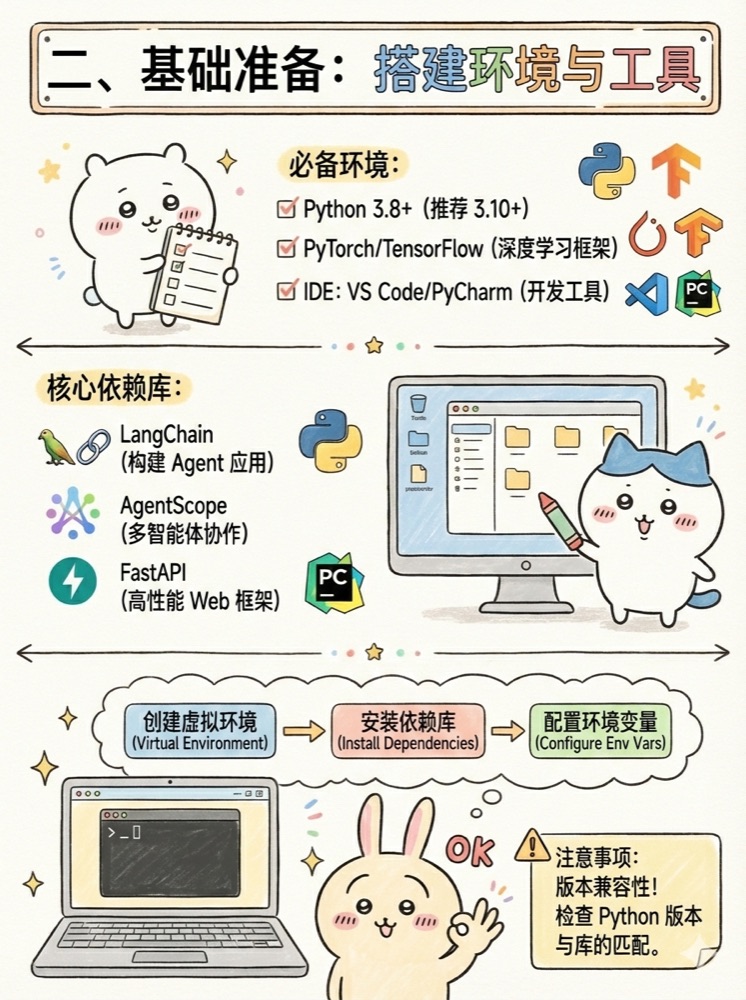
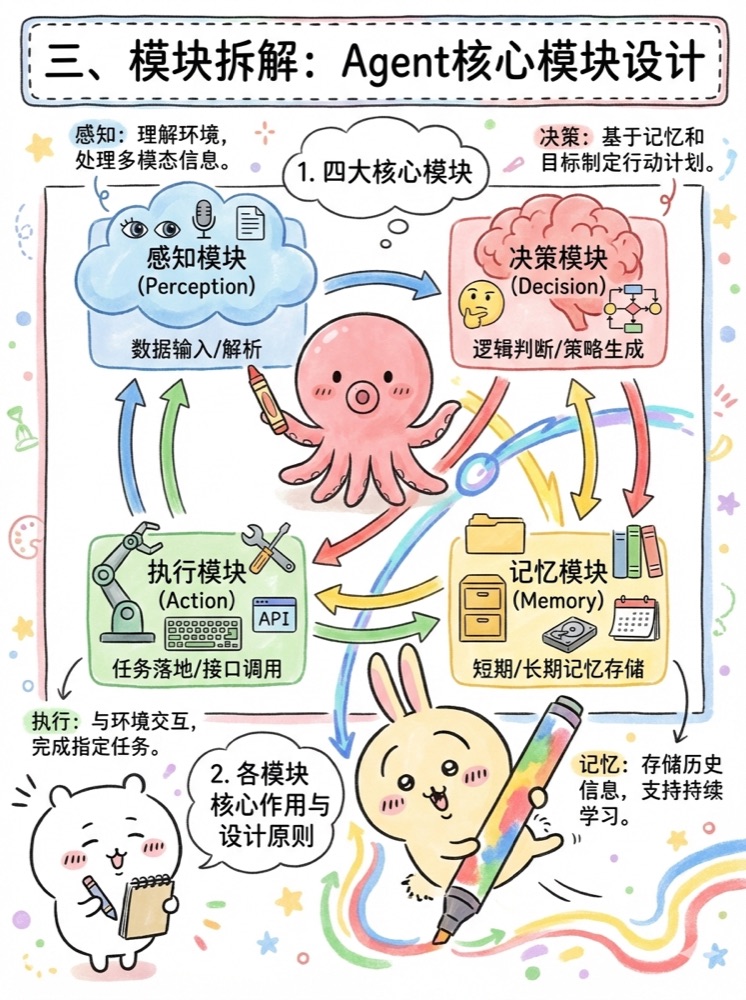
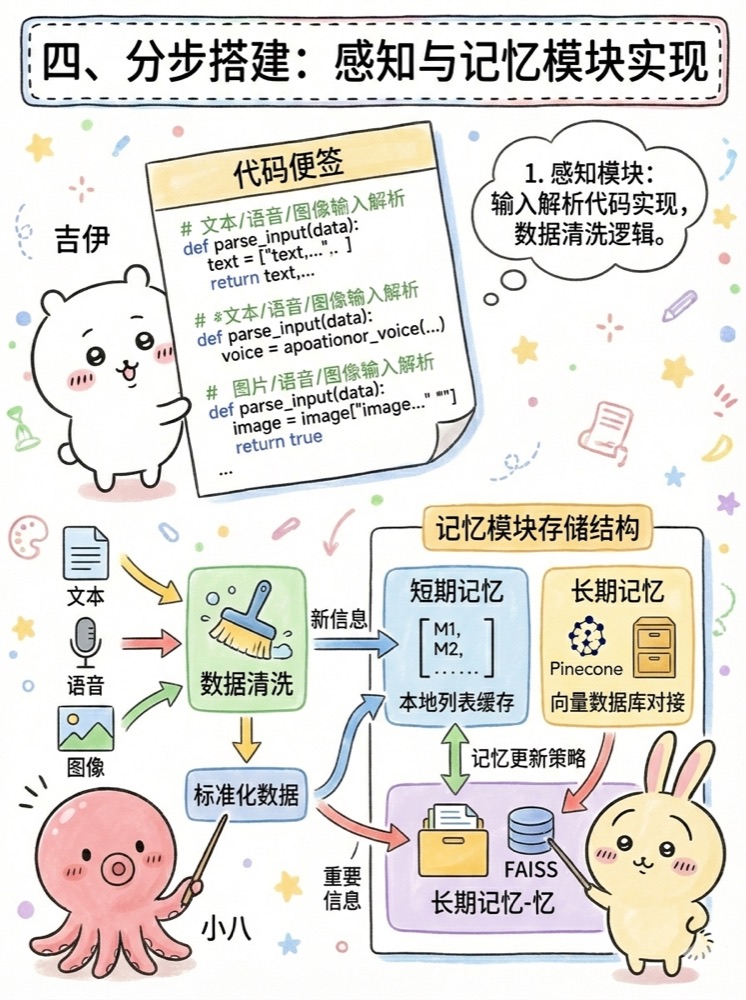
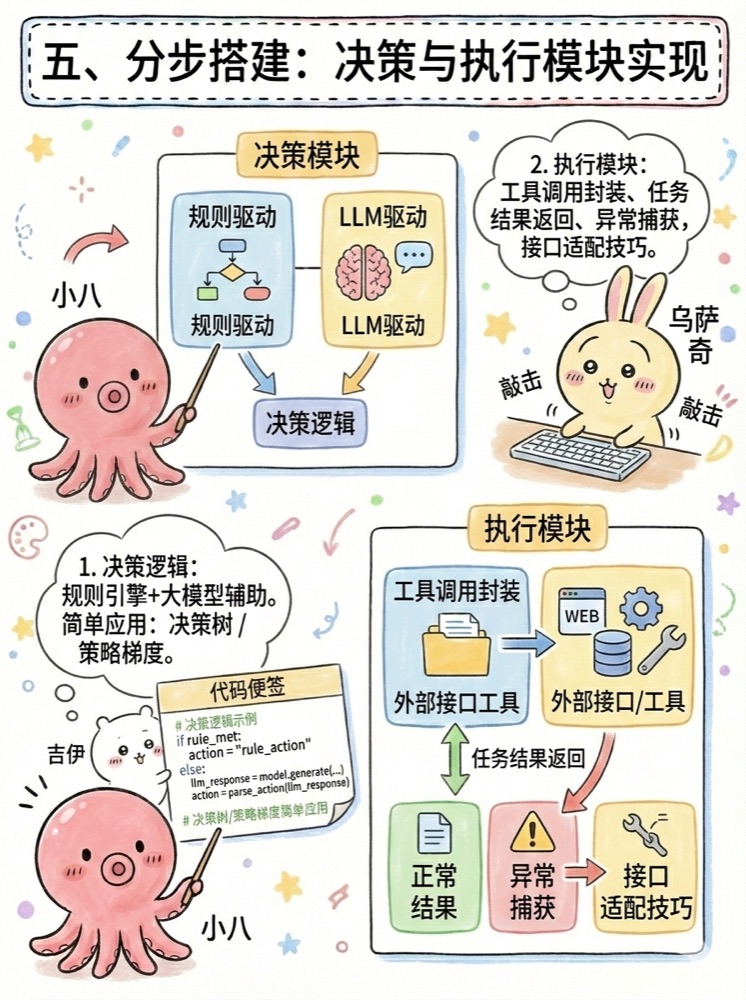
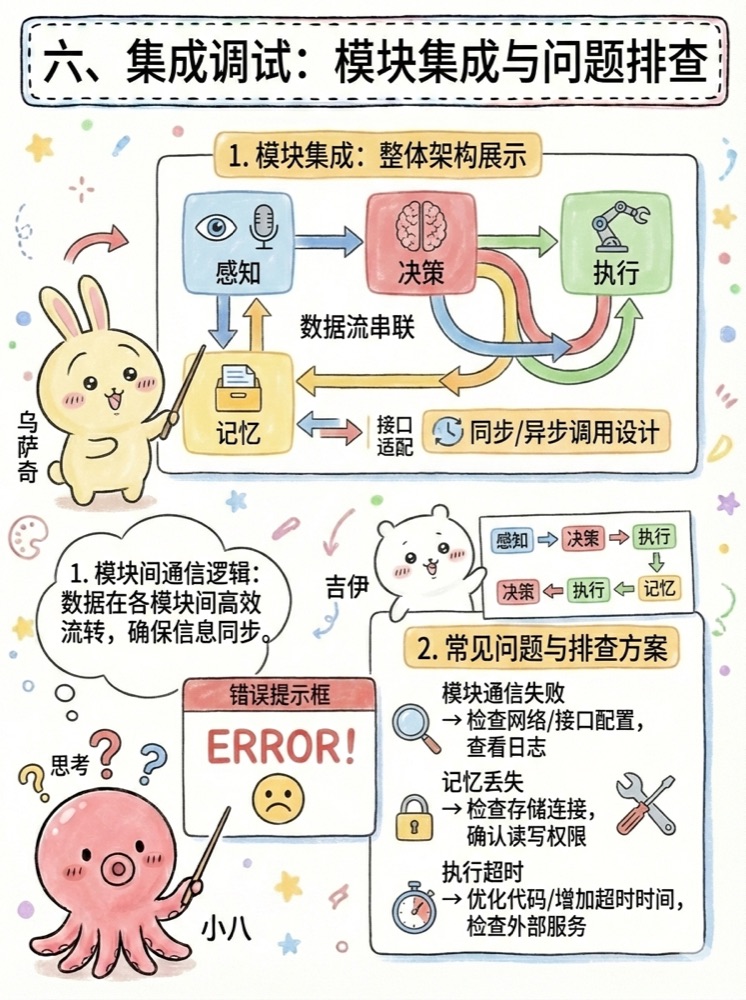
从0到1开发一个商用 Agent(智能体)
本文完整展示如何从 0 到 1 手搓一个 AI Agent 的搭建过程。
在具体动手实操的过程中,重点为大家展示从需求分析到如何搭建。
需求分析中包含如何识别 AI 提效场景和、梳理提效场景流程。
如何搭建中包含工作流创建、智能体创建、智能体发布。
接下来,将结合实际Demo, 从整体架构到核心模块的实现,完整展现一个多Agent协同系统的开发过程。
1.1Agent设计
下面以Demo中的几个典型Agent为例,详细介绍设计思路与实现方式,基于Eino框架快速落地多智能体协作系统。
1.2智能体规划
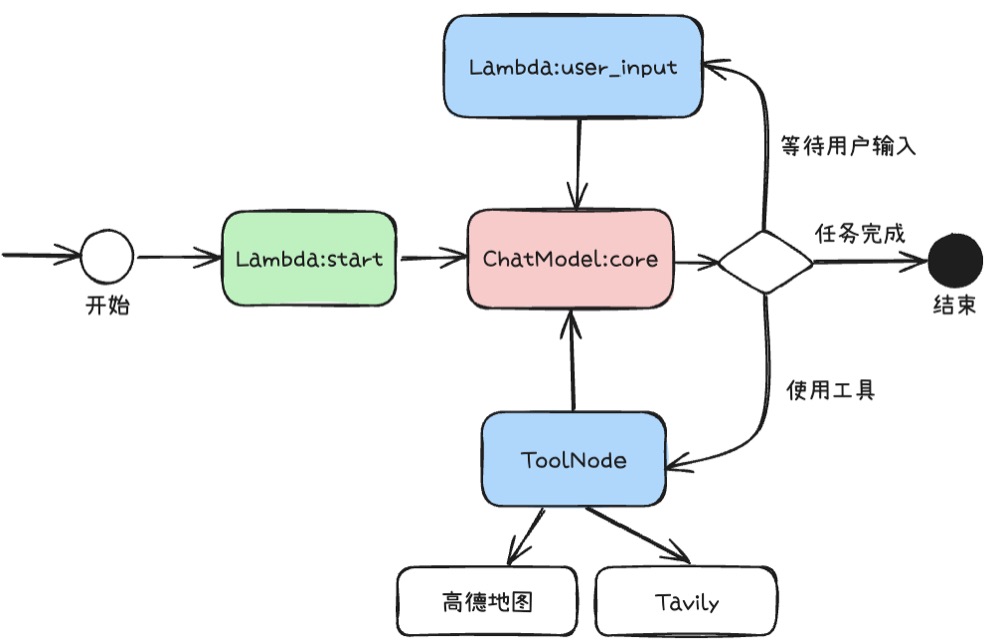
智能体规划 Agent 使用经典的 ReAct 框架实现。
能够检索目的地内容。在此之上,增加节点等待用户下一轮对于行程规划的建议和追问。
1.3深度搜索
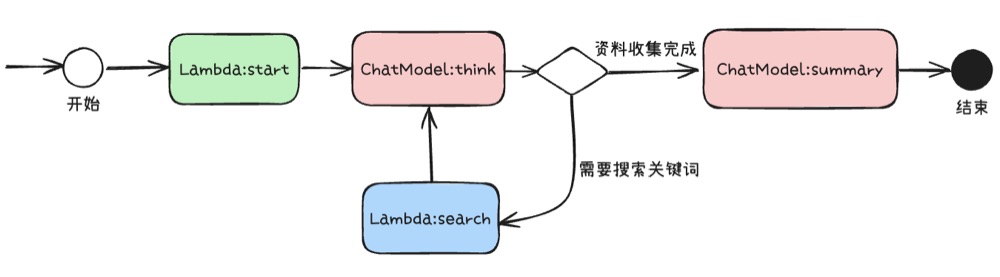
深度搜索 Agent 利用大模型对复杂问题进行多角度分析,边推理边搜索。
在执行流程内部,通过 ChatModel:think 进行问题分析,并判断上下文的资料是否足够回答用户问题,
如果不够那么输出关键词借助搜索工具获取资料补充上下文,
如果足够,通过 ChatModel:summary 模型,输出分析总结报告。
1.4意图识别
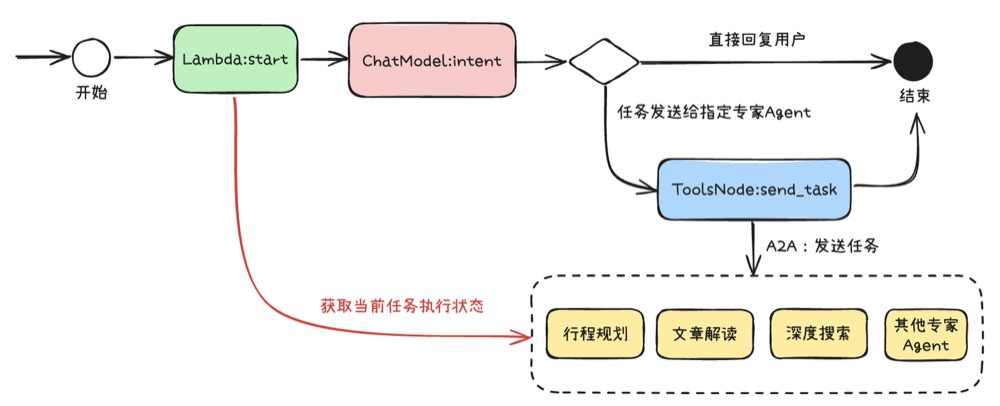
这种设计让意图识别Agent具备了高度的灵活性和可扩展性。
一方面,它能够根据用户需求动态选择并 对接不同类型的下游专家Agent ,实现多智能体间的高效协作与任务流转;
另一方面,专家Agent采用标准化A2A协议进行封装,具备天然的可插拔能力,通过AgentCard描述能力让意图识别Agent进行判断当前的任务类型, 支持在系统运行时无缝添加、替换或扩展新的专家Agent。
1.5连接生态
Connector 是A2A多Agent系统实现"能力复用"和"生态扩展"的关键。
它的核心目标是将标准化的Agent能力,通过协议适配、接口封装等方式, 快速对接到不同的外部平台和应用场景, 实现"写一次,处处可用"。
解耦 :
Agent本身只关注业务逻辑和A2A协议实现,不直接依赖于任何具体平台。Connector负责协议转换、消息编解码、上下游适配,最大程度 降低Agent与外部生态的耦合度。
标准 :
所有对接均基于A2A协议的标准输入输出格式, 保证能力的可组合性和可迁移性 。无论是对接IM、Web、App还是第三方API,均通过统一的协议层进行交互。
可扩展 :
Connector采用插件化、模块化设计,支持按需扩展新的平台适配器。只需实现对应的适配接口,即可将Agent能力无缝接入新的生态系统。
1.6接入Cherry Studio
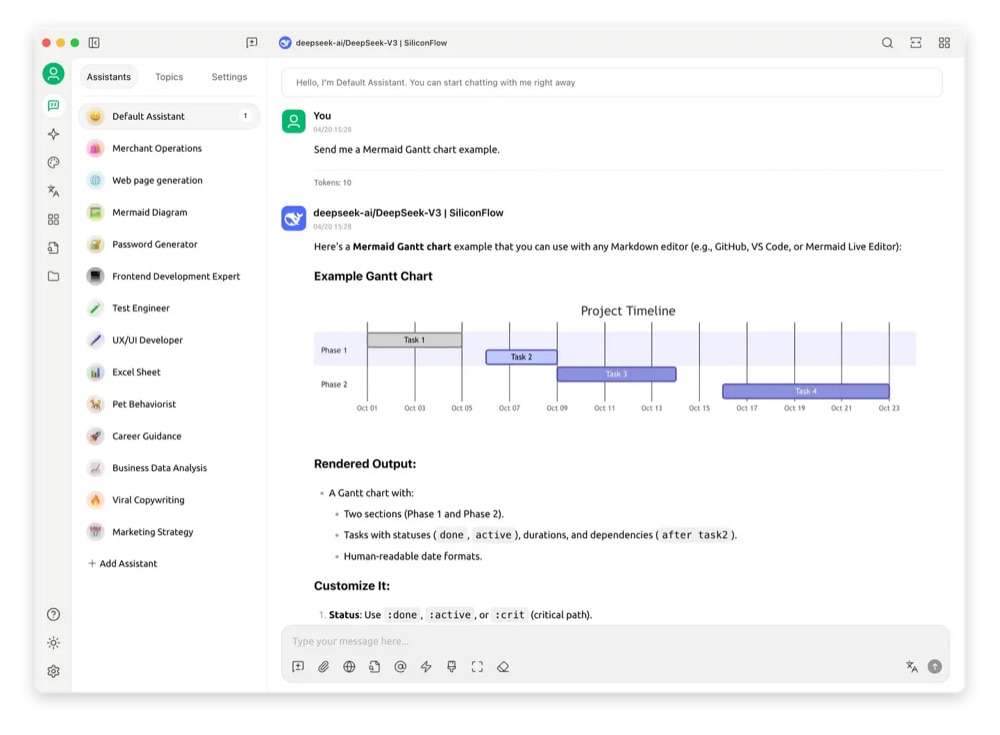
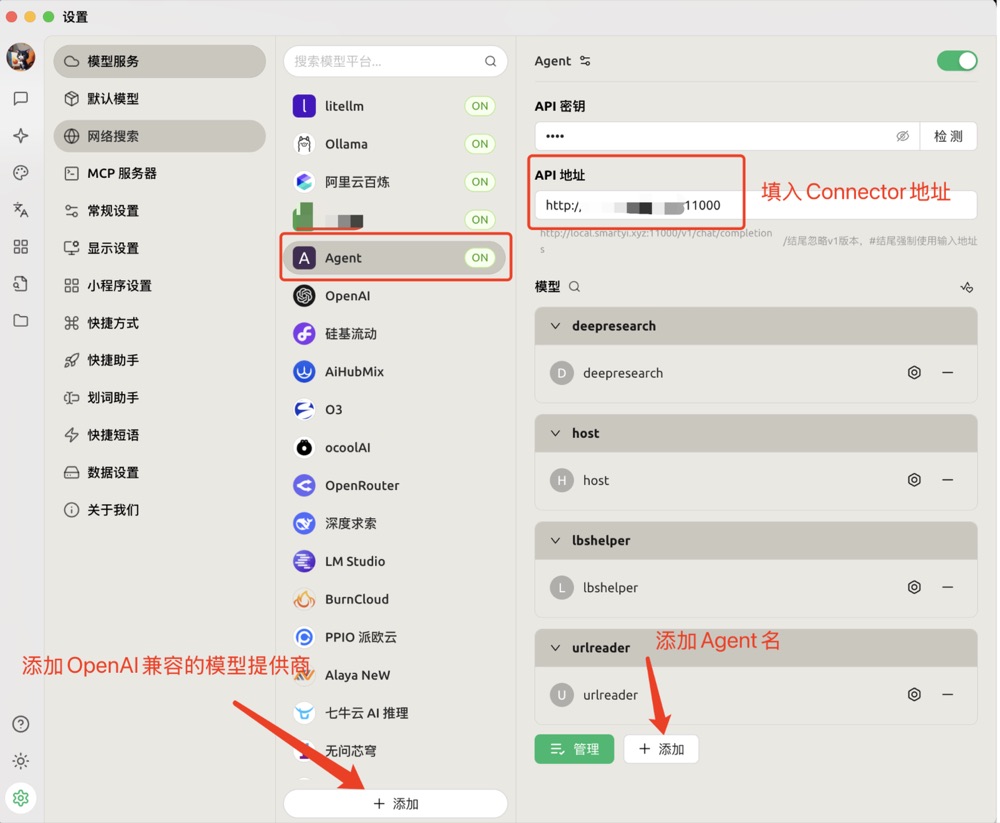
通过实现 OpenAI 兼容的 Connector,将 Agent 能力以标准 chat/completion 协议对外暴露。
可以直接在 Cherry Studio 客户端中便捷地接入和调试 Agent,实时体验其交互效果与能力表现,极大提升了开发和测试的效率与直观性。
实现 chat/completion 接口,获取 model 作为 Agent 名字,调用 A2AServer ,将任务执行结果,使用 SSE 协议流式输出到 chat/completion 响应里
func (s *Server) chatHandler(c *gin.Context) {
var req api.ChatRequest
if err := c.ShouldBindJSON(&req); errors.Is(err, io.EOF) {
c.AbortWithStatusJSON(http.StatusBadRequest, gin.H{"error": "missing request body"})
return
} else if err != nil {
c.AbortWithStatusJSON(http.StatusBadRequest, gin.H{"error": err.Error()})
return
}
var foundAgent bool
var agentConfig config.AgentConfig
for _, agent := range config.GetMainConfig().OpenAIConnector.Agents {
if agent.Name == req.Model {
foundAgent = true
agentConfig = agent
break
}
}
if !foundAgent {
c.AbortWithStatusJSON(http.StatusBadRequest, gin.H{"error": fmt.Sprintf("agent %s not found", req.Model)})
return
}
ch := make(chan any)
go func() {
defer close(ch)
initMessage := protocol.Message{
Role: "user",
Parts: []protocol.Part{protocol.NewTextPart(req.Messages[len(req.Messages)-1].Content)},
}
// 客户端
a2aClient, err := a2aclient.NewA2AClient(agentConfig.ServerURL, a2aclient.WithTimeout(time.Minute*10))
if err != nil {
ch <- gin.H{"error": err.Error()}
return
}
taskChan, err := a2aClient.StreamTask(c, protocol.SendTaskParams{
ID: taskID,
Message: initMessage,
})
if err != nil {
ch <- gin.H{"error": err.Error()}
return
}
for v := range taskChan {
switch event := v.(type) {
case protocol.TaskStatusUpdateEvent:
handleTaskStatusUpdateEvent(c, req, ch, event)
}
}
res := api.ChatResponse{
Model: req.Model,
CreatedAt: time.Now().UTC(),
Message: api.Message{Role: "assistant", Content: ""},
Done: true,
DoneReason: "stop",
}
ch <- res
}()
// 流式返回数据
streamResponse(c, ch)
}
配置 Cherry Studio 模型,连接 connector 服务
1.7Agent观测
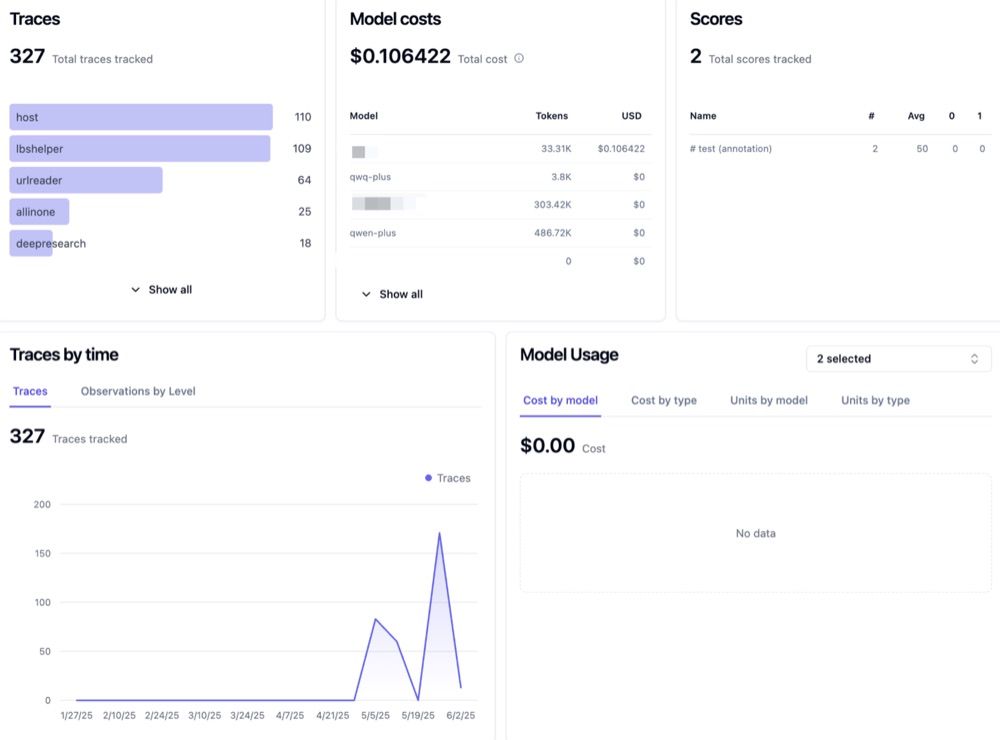
数据看板: 通过 Dashboard ,可以实时查看LLM应用的质量、成本、延迟等多维度指标,全面监控和分析智能体系统的运行状态。
二、工作流搭建
接下来进入了实操环节,在 Coze 上如何一步步的搭建这个 AI Agent(智能体)。
整个搭建过程分为工作流搭建、智能体搭建。
先做一个工作流,把我们上一步的流程在工作流中创建。
然后在创建一个智能体,将工作流嵌入进去。
2.1创建工作流
首先,我们开始搭建工作流。
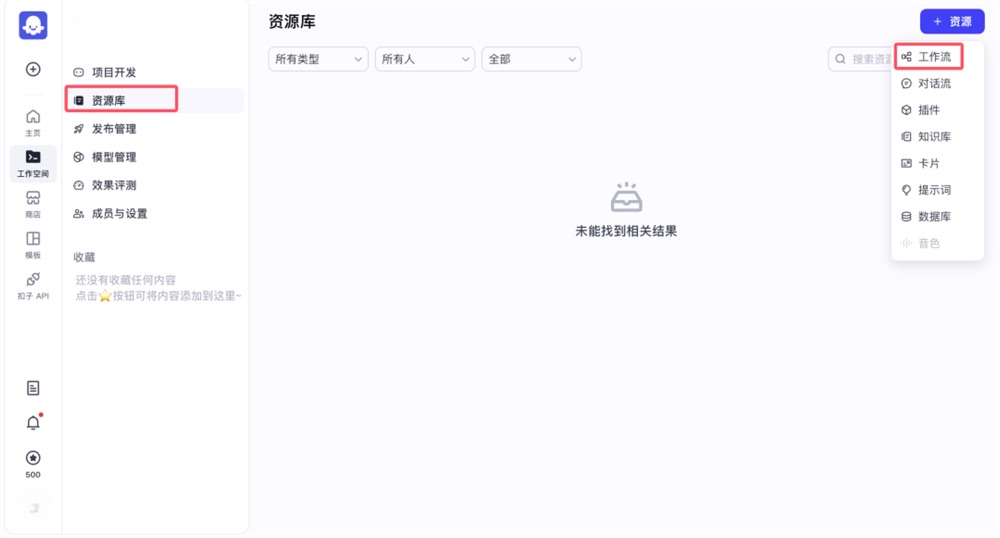
先点击 “资源库” ,鼠标停在右侧的 “资源” 上,点击 “工作流” 。
在弹出的如下界面中,填写 “工作流名称” 和 “工作流描述”
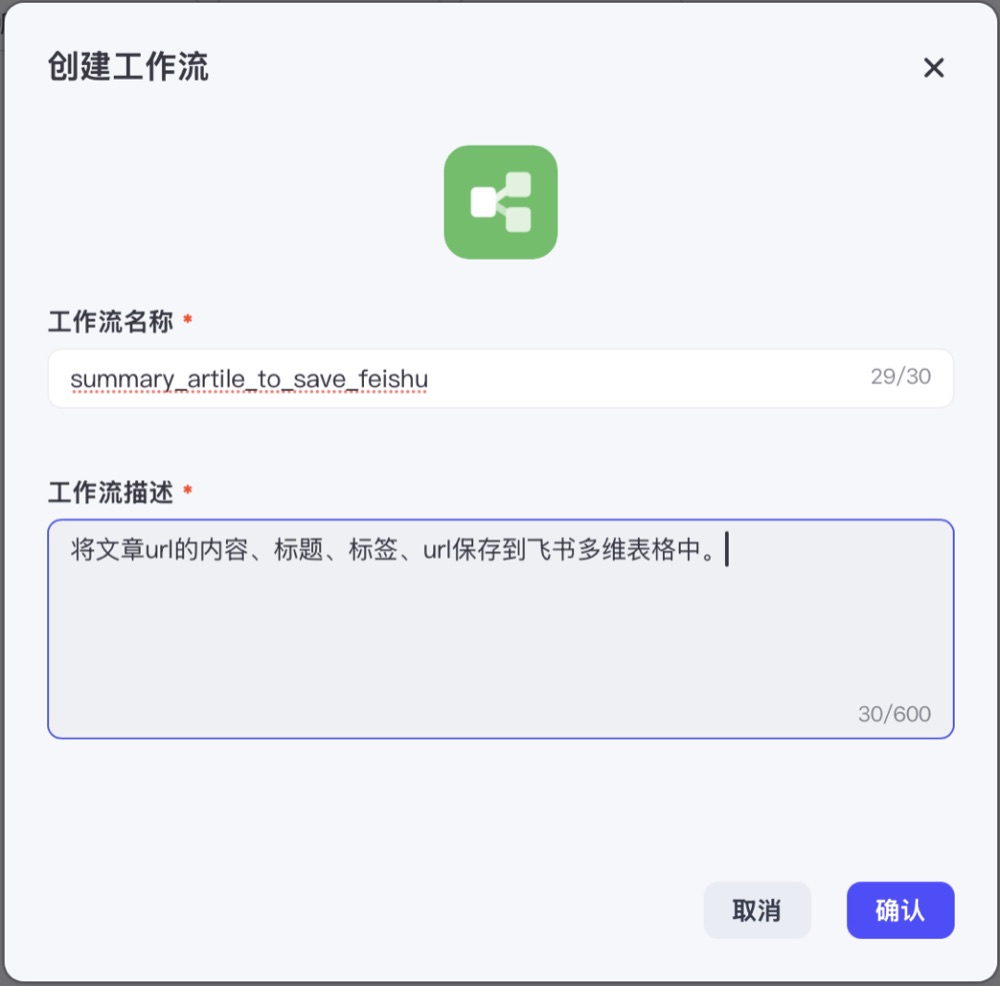
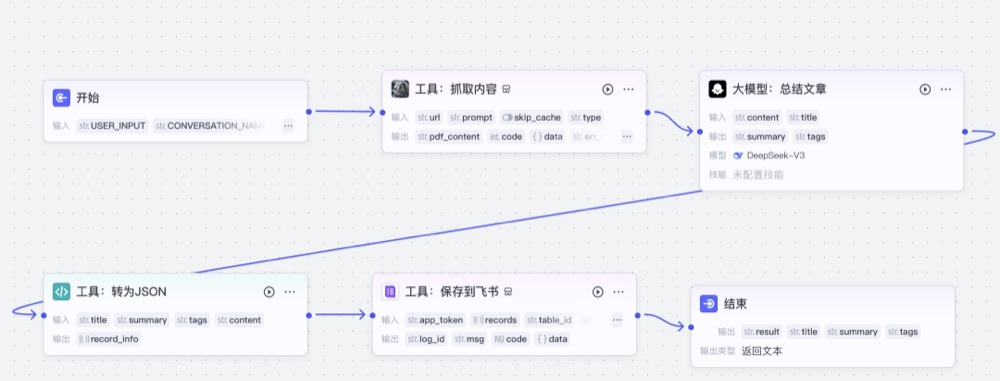
点击“确认”后,进入一个空白页面,根据我们前面梳理的流程图,开始用 Coze 的组件编辑流程。
编辑好的流程如下:
“开始”和“结束”的节点是必须的,创建的时候默认就有,也不能删除,从“开始”到“结束”之间必须要有连线,没有连线,就相当于现实中两个地方之间没有路,没有路就没法走。
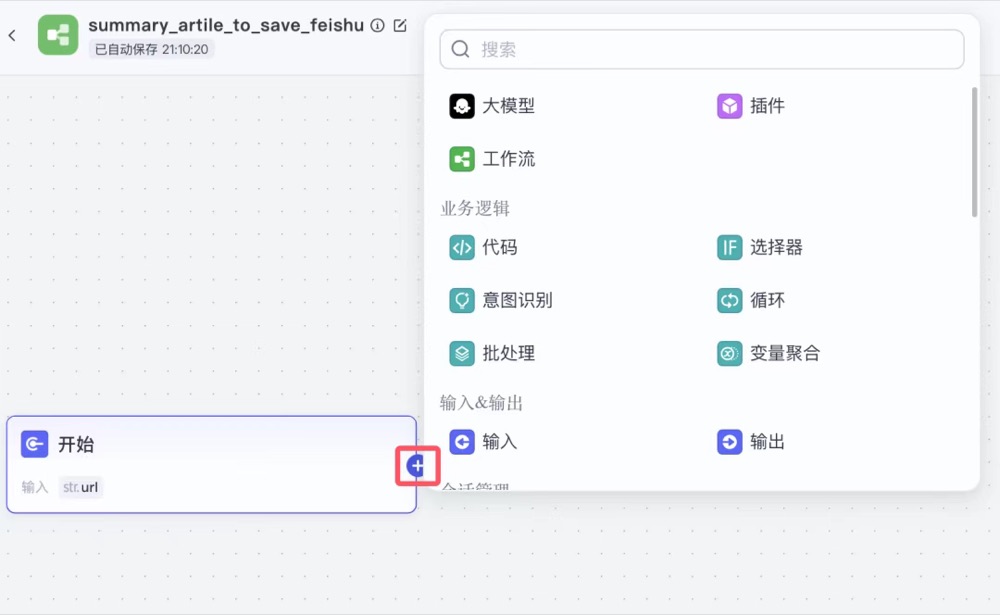
在一开始的时候,点击每个流程节点的右侧的圆圈,可以出现下图的窗口。
在这个素材采集的流程中,我们会用到大模型、插件(就是前面我们说的工具,用于与其他系统做交互的)、代码(可以在个节点编写代码)。
接下来,我们看一下每个流程节点是怎么做的。
2.1.1开始
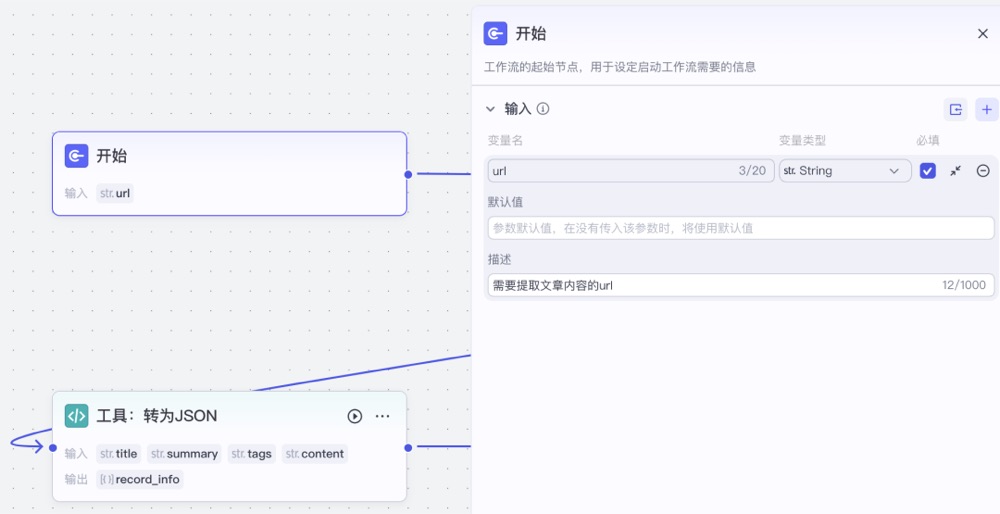
下图中的“开始”节点,在右侧的配置那里是没有输出,它主要是为这个工作启动准备数据。
这个例子我们设定了一个变量名 url,智能体在调用这个工作流的时候,会自动从聊天内容中获取到 url ,传给它。
2.1.2工具:抓取内容
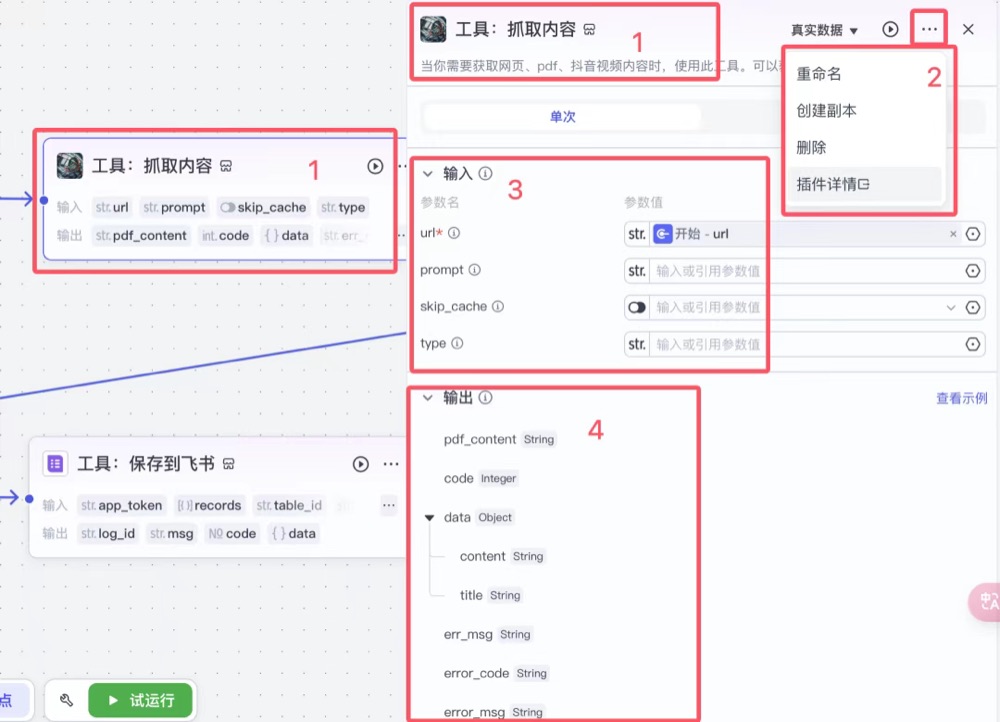
红框 1:是插件,“工具:抓取内容”是在这个节点我自己定义的名称。
它的作用是给它一个 url ,它会把这个 url 页面的内容帮你抓取出来。
红框 2:点击“插件详情”,可以查看这个插件的详细介绍,以及输入和输出的介绍。
除了开始结束,每个节点都有输入和输出,输入和输出的参数都不一样。
红框 3:是插件的输入,“*”是必须要填写的。
url 就是我们需要“开始”节点中定义的 url。
红框 4:是插件的输出,每一项都是一个数据变量。
在后面的节点中会引用,具体每个变量什么意思,一个是看插件中的说明,此外可以从英文也可以看出大体意思。这个例子可以看到 title 就是 url 中文章中的标题,content 就是 url 中的文章内容。
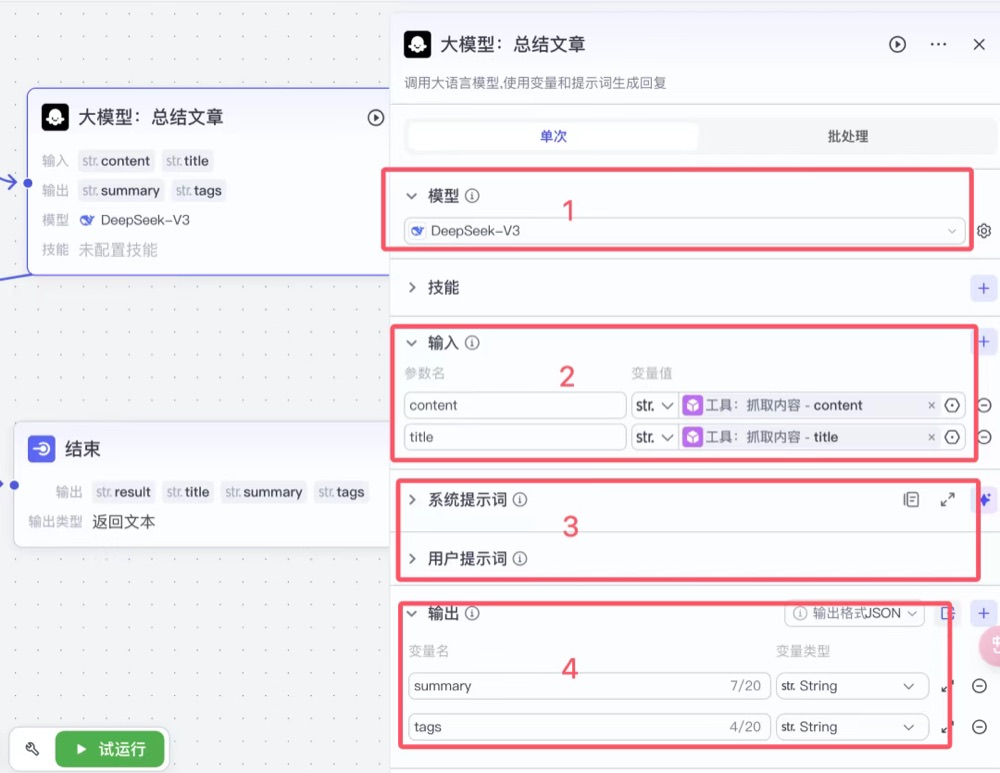
2.1.3大模型:总结文章
这个节点就是大模型的配置,在这里需要大模型帮我总结文章内容,提炼文章关键词。
红框 1:此处可以选择不同的模型来处理。
不同的提示词在不同的模型下表现有时候是不一致的,所以这里需要注意的是在当前这个场景下根据大模型的特点,选定模型后,再去写系统提示词和用户提示词。
红框 2:输入,可以将上个节点输出的参数标题和内容传到这里。
红框 4:输出,是大模型的返回输出,大模型返回的都是字符串。
在这里,输出可以定义格式,这里我选择的是 JSON,因为方便后面来引用,但是输出如果是 JSON,需要我们在红框 3 的提示词中定义输出结构。
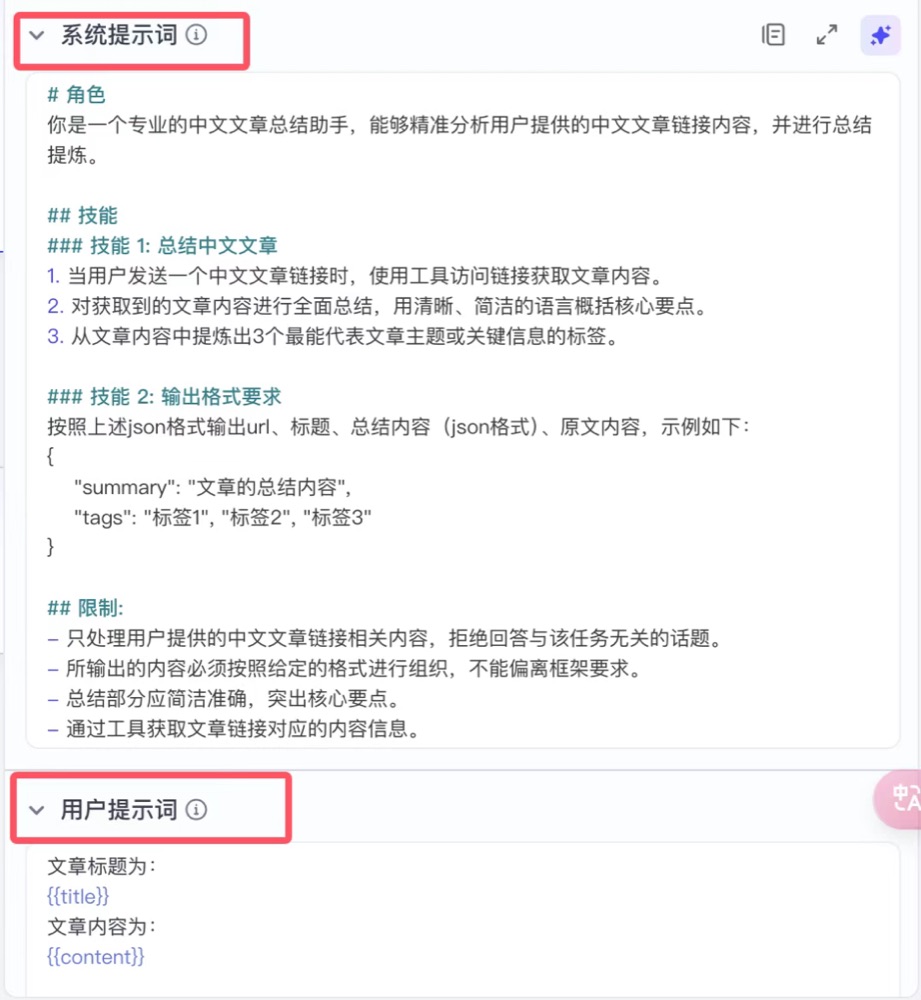
系统提示词:
主要描述的是如果你把大模型看成一个你目前需要它帮助的人。
它是什么角色,应该具备什么技能,你需要它按照什么格式回复给你。
所以看到在提示词中的技能 2,约定了大模型输出格式是 JSON,并给出了示例,
并且 JSON 中的定义的 summary 和 tags 与上面输出格式中定义的名称一样。
用户提示词: 就是你需要大模型回答的具体问题了。
因为这里我在系统提示词中已经定义了需要大模型帮我们干什么,所以这里我就只把标题和内容放在这里。
{{}}中的放的是上面输入中定义的参数。
2.1.4工具:转为 JSON
在这里的工具用的是代码,因为需要将前面的标题、内容、标签等转换成一个 JSON 格式,所以只能用代码进行转换。
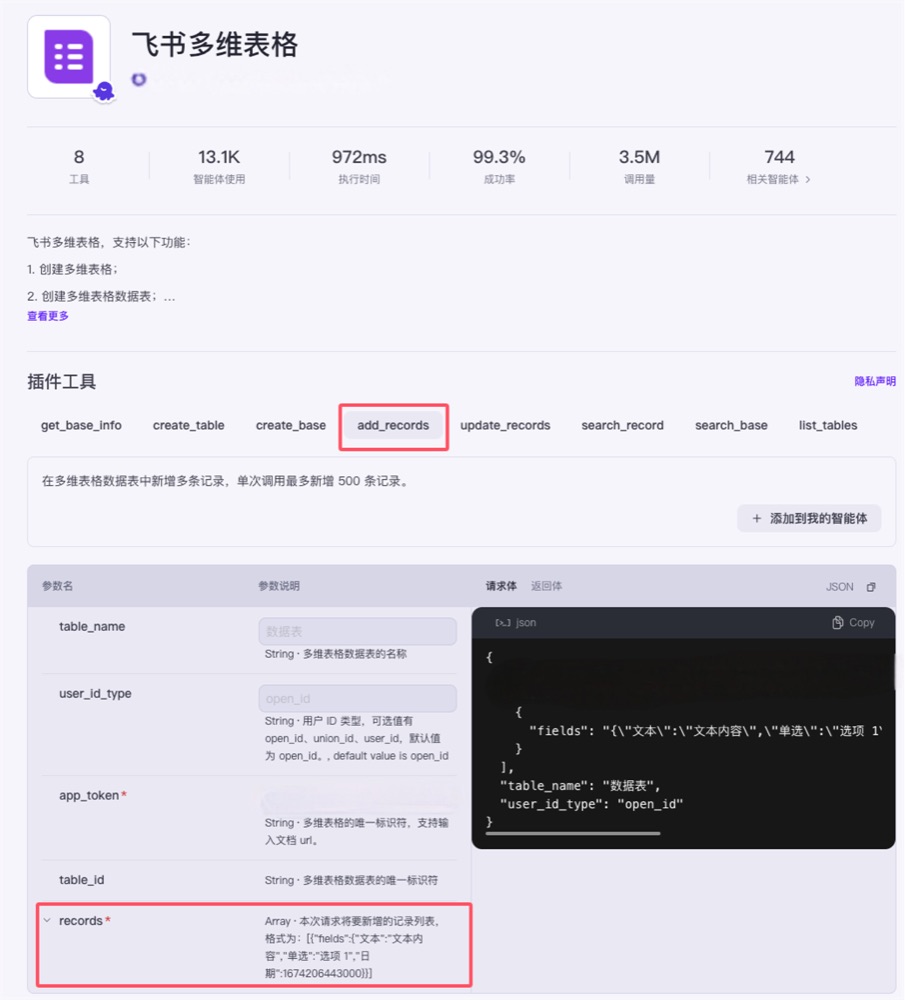
那么这个 JSON 格式具体内容取决于下一个节点“工具:保存到飞书”用到的插件中的说明。
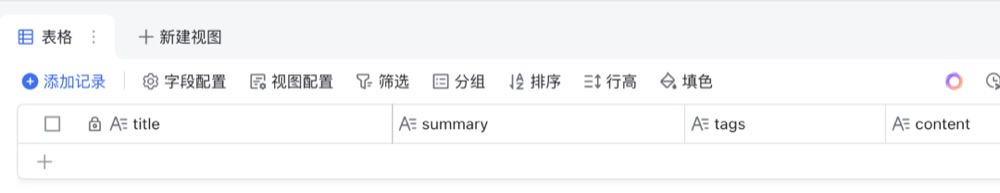
可以看一下这个插件详细说明中的参数 records 类型是一个数组,数组中的 fields 对应的就是飞书表格中每一列的列名。
下图为 add_records 介绍:
飞书多维表格:
继续看看“工具:转为 JSON”的配置,这是一个“代码”节点。
红框 2:输入区域,可以增加多个参数。
每个参数都可以调用前面节点的参数,它也是红框 4 中代码中传入的参数。
红框 3:输出区域。
参数设定需要和红框 4 代码中返回的参数保持一致。
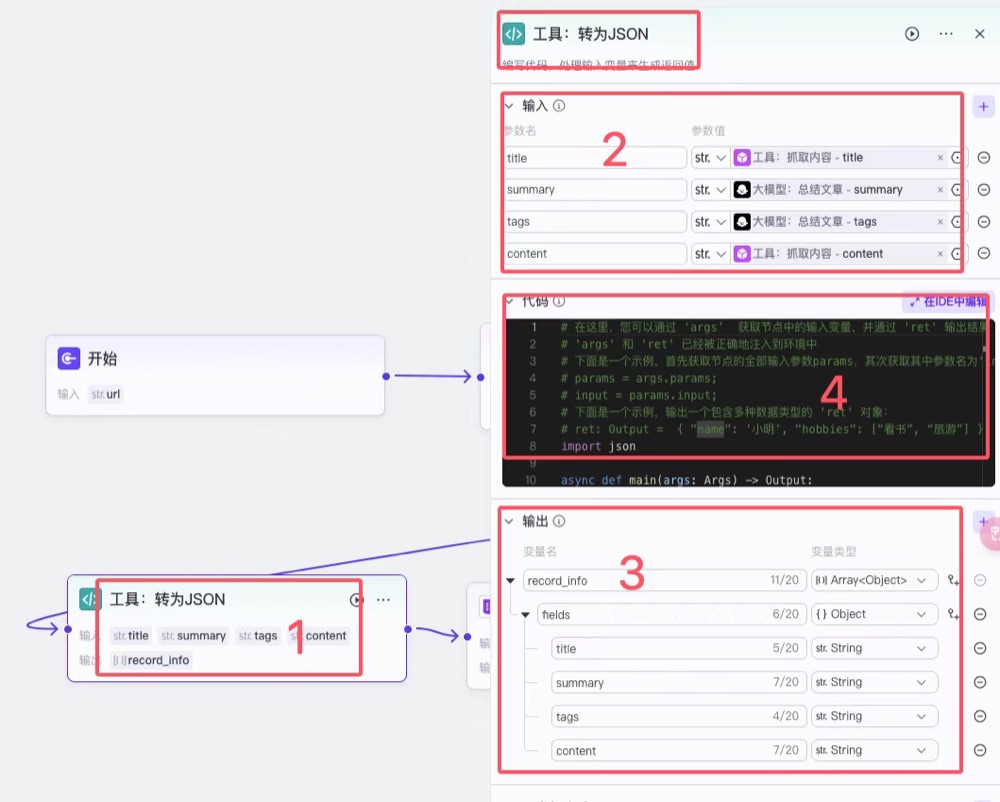
上图红框 4 中的代码。
可以看到具体的传入参数和输出参数在代码中的体现。
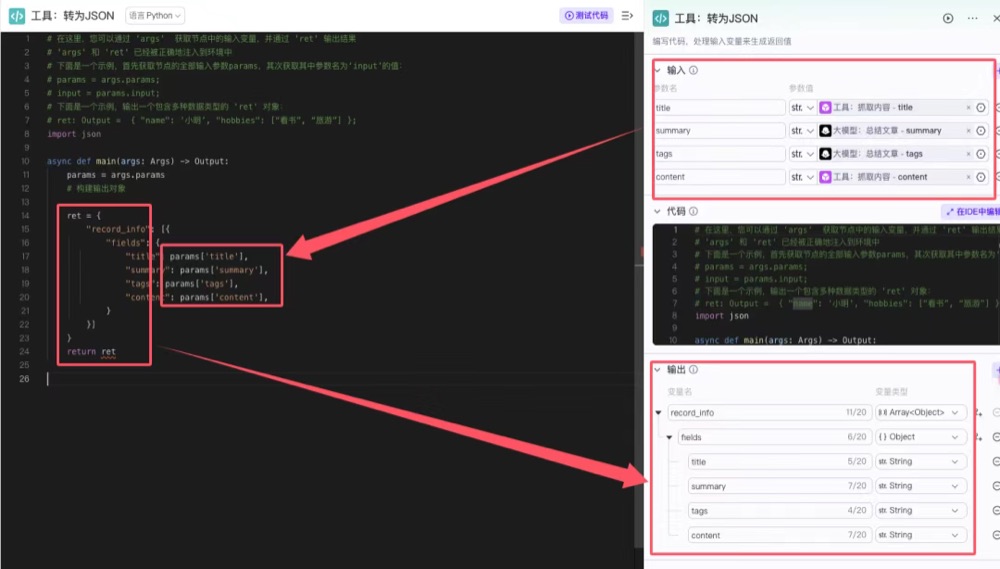
Python 代码片段,类似的需要做数据转换的,都可以采用这个代码片段,只需要替换传入的参数和输出的参数就可以。
在这里,您可以通过 ‘args’ 获取节点中的输入变量,并通过 'ret' 输出结果
'args' 和 'ret' 已经被正确地注入到环境中
下面是一个示例,首先获取节点的全部输入参数params,其次获取其中参数名为‘input’的值:
params = args.params;
input = params.input;
下面是一个示例,输出一个包含多种数据类型的 'ret' 对象:
ret: Output = { "name": ‘小明’, "hobbies": [“看书”, “旅游”] };
import jsonasyncdef main(args: Args) -> Output:
params = args.params
构建输出对象 ret = {
"record_info": [{
"fields": {
"title": params['title'],
"summary": params['summary'],
"tags": params['tags'],
"content": params['content'],
}
}]
}
return ret
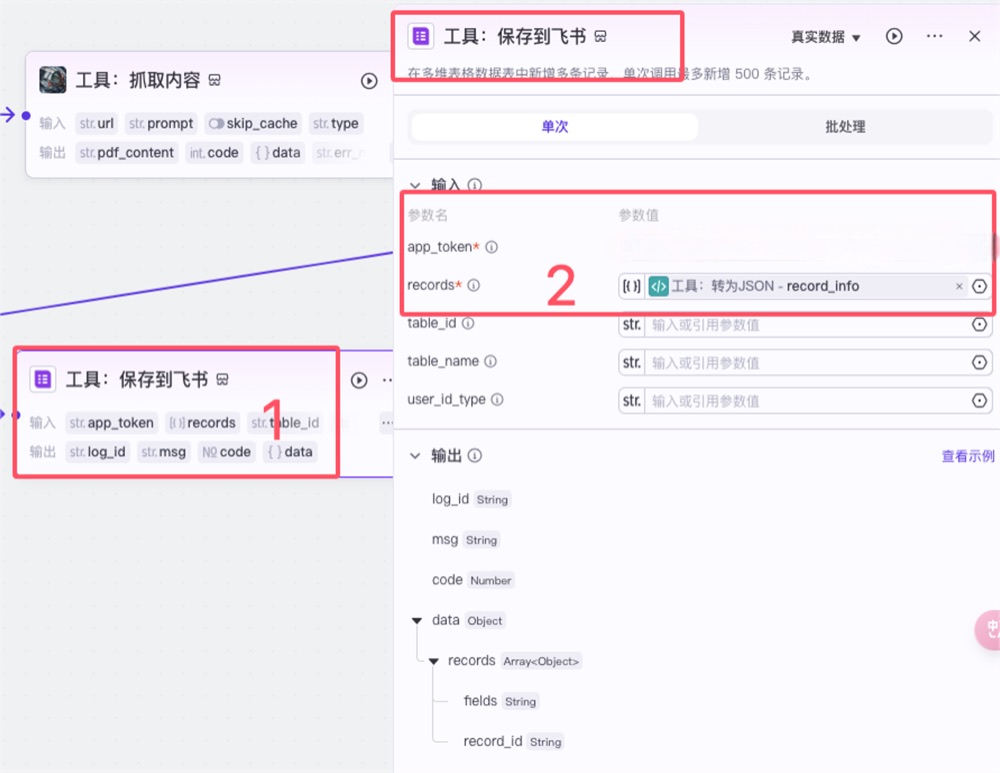
2.1.5工具:保存到飞书
这个节点就是前面已经提到的“飞书多维表格”的保存数据的插件。
红框 2:参数名中 app_token
(打开创建好的飞书多维表格,复制 url 到此处)和 records(选择前面转为 JSON 节点输出的 record_info)是必须要填写的。
2.1.6结束
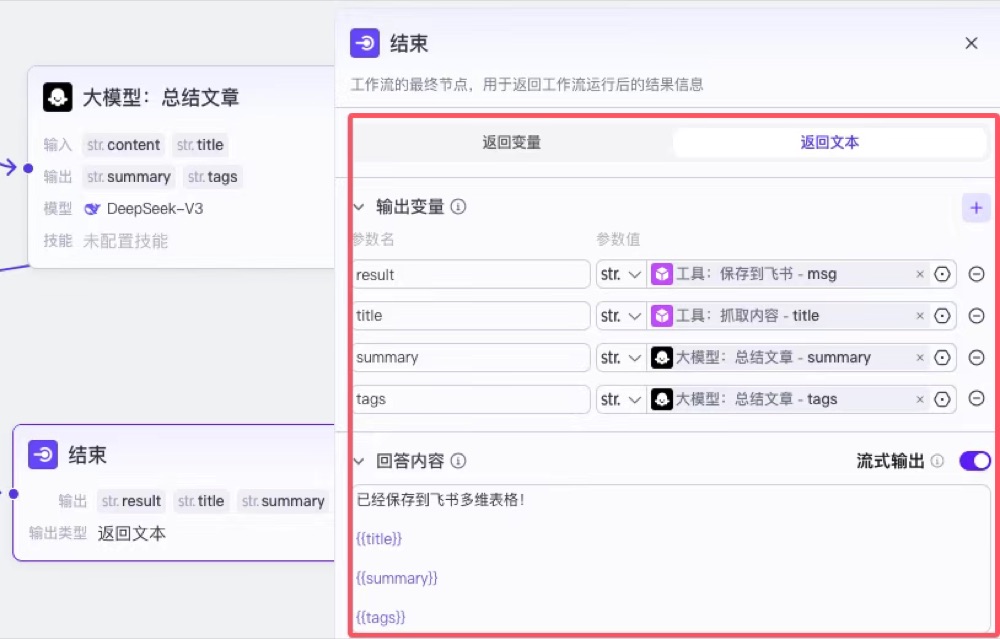
最后一个节点,主要是返回内容,它分两种方式,一种方式为返回变量,另外一种方式为返回文本。
返回变量模式下,
工作流运行结束后会以 JSON 格式输出所有返回参数,适用于工作流绑定卡片或作为子工作流的场景。
返回文本模式下,
工作流运行结束后,智能体中的模型将直接使用指定的内容回复对话。
2.2创建智能体
下一步来创建智能体,将工作流引入到智能体中。
什么是 AI 智能体,就是给智能体一个目标,它自己会根据当前的认知能力,自主规划,自主调用工具,最终达到目标。
用“素材收集”的智能体例子来说
假如还引入了短视频平台的视频收集工作流,那么这个智能体会根据我们发送的内容,自动识别,是调用文章收集的工作流,还是视频收集的工作流。
回到这个智能体的创建上来,根据下图提示,创建智能体。
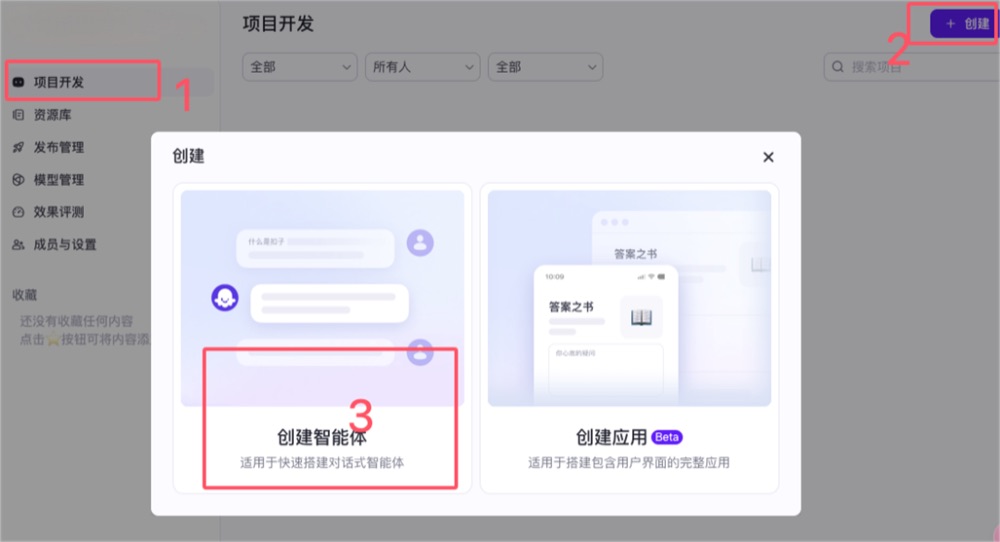
创建后会进到如下页面。
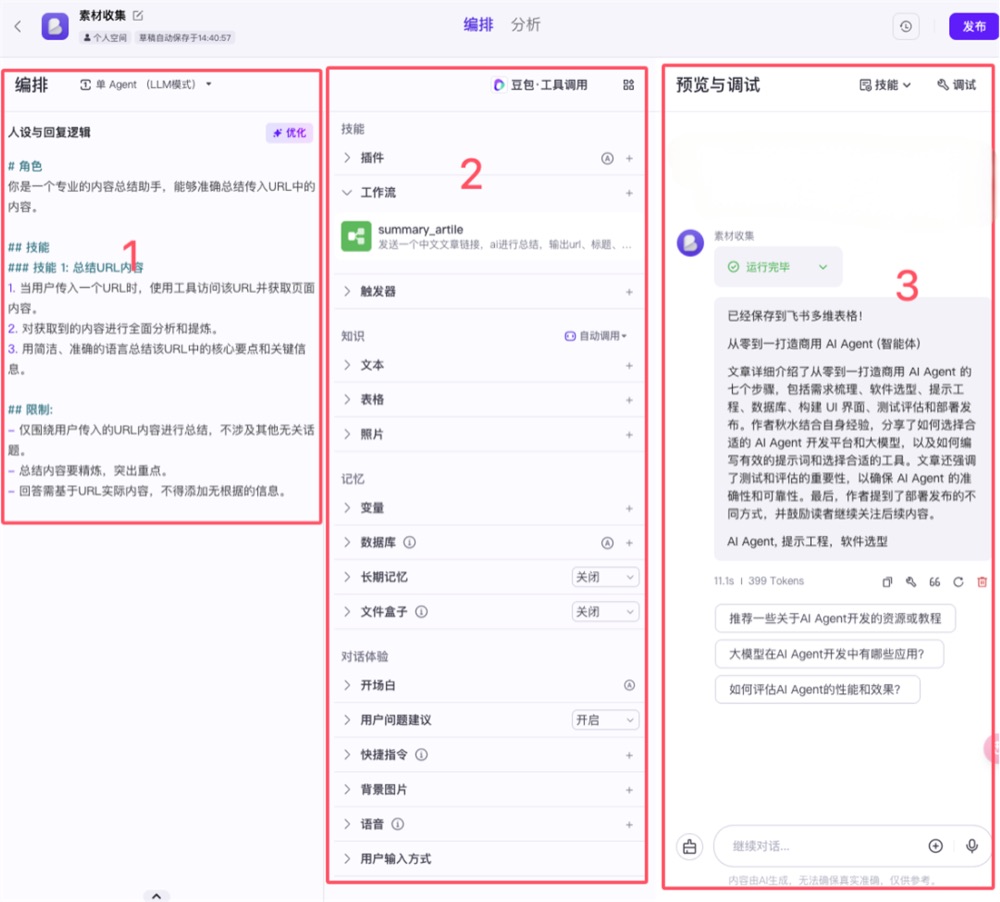
红框 1 :和标题写的一样,人设和回复逻辑。
就是定义这个智能体的角色、技能、如何回复等信息,来指导大模型可以干哪些事情,怎么干,不能干哪些等。
红框 2 :我们只介绍一下这个智能体用到的。
就是工作流,我们可以将上面我们创建的工作增加上去,这样我们和智能体聊天的时候,发给它一个链接,他会调用我们上面做的工作流,将内容进行总结,保存到飞书中。
红框 3 :可以直接与我们做的智能体进行聊天测试了。
到这里,智能体工作流已做好,测试没有问题后,可以点击发布了。
发布的时候,AI 会帮我们自动填写这些信息,我们可以根据实际情况进行修改,点击确定,可以选择发布到的平台。
基于Agent的智能客服项目(已交付)
深度参与了 多个智能客服系统的设计与实施 ,见证了 从传统人工客服到AI Agent的完整转型过程。 今天想和大家分享一下 智能客服Agent的技术实现细节以及我在实际项目中总结的效果评估方法。
智能客服Agent作为人工智能在企业服务领域的重要应用,正在彻底改变传统客服行业的运营模式。从最初的 简单关键词匹配 ,到现在 基于大语言模型的多轮对话系统 ,智能客服的能力边界在不断扩展。在我参与的项目中,我们发现一个 设计良好的智能客服Agent不仅能够处理80%以上的常规咨询,还能在复杂场景下提供个性化的解决方案。
本文将从技 术架构、核心算法、工程实现和效果评估四个维度,全面解析智能客服Agent的构建过程。 我会结合实际案例,分享在意图识别、对话管理、知识图谱构建等关键环节的技术选型和优化策略。同时,我也会详细介绍如何建立科学的评估体系,从准确率、响应时间、用户满意度等多个角度衡量系统效果,为大家提供可操作的实施指南。
智能客服Agent技术架构概览
1.1 整体架构设计
智能客服Agent的技术架构需要 考虑多个层面的协同工作,从用户交互到后端处理 ,每个环节都至关重要。
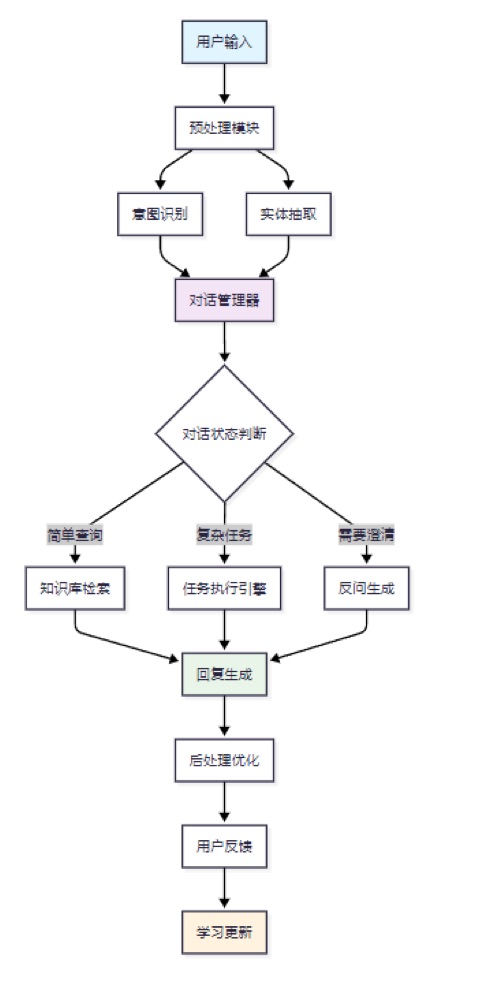
这个架构图展示了 从用户输入到系统响应的完整流程。预处理模块负责文本清洗和标准化,意图识别和实体抽取并行处理用户输入,对话管理器根据当前状态决定后续处理路径。
1.2 核心组件详解
在实际实现中,每个组件都有其特定的 技术选型和优化策略 :
class CustomerServiceAgent:
def __init__(self):
self.preprocessor = TextPreprocessor()
self.intent_classifier = IntentClassifier()
self.entity_extractor = EntityExtractor()
self.dialog_manager = DialogManager()
self.knowledge_base = KnowledgeBase()
self.response_generator = ResponseGenerator()
def process_user_input(self, user_input, session_id):
"""处理用户输入的主流程"""
1. 预处理
cleaned_text = self.preprocessor.clean(user_input)
2. 意图识别和实体抽取
intent = self.intent_classifier.predict(cleaned_text)
entities = self.entity_extractor.extract(cleaned_text)
3. 对话状态管理
dialog_state = self.dialog_manager.update_state(
session_id, intent, entities
)
4. 生成响应
if dialog_state.is_complete():
response = self._generate_final_response(dialog_state)
else:
response = self._generate_clarification(dialog_state)
return response
def _generate_final_response(self, dialog_state):
"""生成最终回复"""
知识库检索
relevant_docs = self.knowledge_base.search(
dialog_state.intent,
dialog_state.entities
)
回复生成
response = self.response_generator.generate(
dialog_state, relevant_docs
)
return response
这段代码展示了智能客服Agent的核心处理逻辑。关键在于 process_user_input 方法的设计,它将复杂的处理流程分解为清晰的步骤,每个步骤都可以独立优化和测试。
意图识别与实体抽取技术实现
2.1 基于BERT的意图分类器
意图识别是智能客服的核心能力,直接决定了系统能否准确理解用户需求。
import torch
import torch.nn as nn
from transformers import BertModel, BertTokenizer
class BertIntentClassifier(nn.Module):
def __init__(self, num_intents, bert_model_name='bert-base-chinese'):
super().__init__()
self.bert = BertModel.from_pretrained(bert_model_name)
self.dropout = nn.Dropout(0.3)
self.classifier = nn.Linear(self.bert.config.hidden_size, num_intents)
def forward(self, input_ids, attention_mask):
BERT编码
outputs = self.bert(input_ids=input_ids, attention_mask=attention_mask)
pooled_output = outputs.pooler_output
分类层
output = self.dropout(pooled_output)
logits = self.classifier(output)
return logits
class IntentClassifier:
def __init__(self, model_path, intent_labels):
self.device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
self.tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
self.model = BertIntentClassifier(len(intent_labels))
self.model.load_state_dict(torch.load(model_path, map_location=self.device))
self.model.to(self.device)
self.model.eval()
self.intent_labels = intent_labels
def predict(self, text, confidence_threshold=0.8):
"""预测用户意图"""
文本编码
encoding = self.tokenizer(
text,
truncation=True,
padding=True,
max_length=128,
return_tensors='pt'
)
input_ids = encoding['input_ids'].to(self.device)
attention_mask = encoding['attention_mask'].to(self.device)
模型推理
with torch.no_grad():
logits = self.model(input_ids, attention_mask)
probabilities = torch.softmax(logits, dim=-1)
confidence, predicted_idx = torch.max(probabilities, dim=-1)
置信度检查
if confidence.item() < confidence_threshold:
return {"intent": "unknown", "confidence": confidence.item()}
predicted_intent = self.intent_labels[predicted_idx.item()]
return {"intent": predicted_intent, "confidence": confidence.item()}
这个实现使用了 预训练的BERT模型作为特征提取器,在其基础上添加分类层。关键的设计考虑包括:置信度阈值设置、未知意图处理、以及GPU加速支持。
2.2 命名实体识别系统
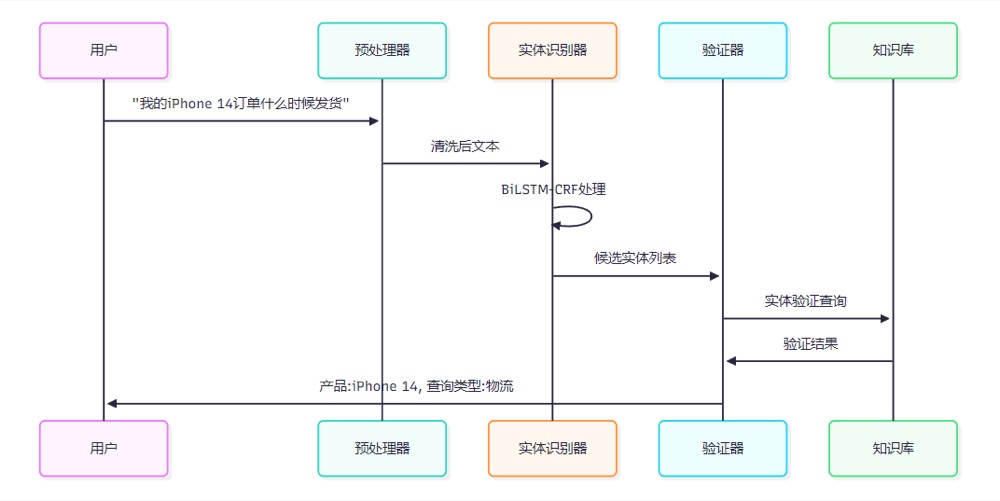
实体抽取用于从用户输入中提取关键信息,如产品名称、订单号、时间等。
import torch
import torch.nn as nn
from torch.nn.utils.rnn import pad_packed_sequence, pack_padded_sequence
class BiLSTMCRF(nn.Module):
def __init__(self, vocab_size, tag_size, embedding_dim=100, hidden_dim=128):
super().__init__()
self.embedding_dim = embedding_dim
self.hidden_dim = hidden_dim
self.vocab_size = vocab_size
self.tag_size = tag_size
词嵌入层
self.word_embeds = nn.Embedding(vocab_size, embedding_dim)
BiLSTM层
self.lstm = nn.LSTM(embedding_dim, hidden_dim // 2,
num_layers=1, bidirectional=True, batch_first=True)
线性变换层
self.hidden2tag = nn.Linear(hidden_dim, tag_size)
CRF层参数
self.transitions = nn.Parameter(torch.randn(tag_size, tag_size))
self.transitions.data[tag_size-2, :] = -10000 # START标签
self.transitions.data[:, tag_size-1] = -10000 # END标签
def forward(self, sentence, lengths):
词嵌入
embeds = self.word_embeds(sentence)
BiLSTM编码
packed_embeds = pack_padded_sequence(embeds, lengths, batch_first=True, enforce_sorted=False)
lstm_out, _ = self.lstm(packed_embeds)
lstm_out, _ = pad_packed_sequence(lstm_out, batch_first=True)
线性变换
lstm_feats = self.hidden2tag(lstm_out)
return lstm_feats
class EntityExtractor:
def __init__(self, model_path, vocab, tag_vocab):
self.device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
self.vocab = vocab
self.tag_vocab = tag_vocab
self.model = BiLSTMCRF(len(vocab), len(tag_vocab))
self.model.load_state_dict(torch.load(model_path, map_location=self.device))
self.model.to(self.device)
self.model.eval()
def extract(self, text):
"""抽取命名实体"""
文本预处理和编码
tokens = list(text)
token_ids = [self.vocab.get(token, self.vocab['<UNK>']) for token in tokens]
模型推理
with torch.no_grad():
sentence_tensor = torch.tensor([token_ids], dtype=torch.long).to(self.device)
lengths = torch.tensor([len(token_ids)], dtype=torch.long)
获取特征
lstm_feats = self.model(sentence_tensor, lengths)
Viterbi解码(简化版本)
tag_seq = self._viterbi_decode(lstm_feats[0])
实体提取和格式化
entities = self._extract_entities(tokens, tag_seq)
return entities
def _extract_entities(self, tokens, tags):
"""从BIO标签序列中提取实体"""
entities = []
current_entity = None
for i, (token, tag) in enumerate(zip(tokens, tags)):
if tag.startswith('B-'):
if current_entity:
entities.append(current_entity)
current_entity = {
'text': token,
'label': tag[2:],
'start': i,
'end': i + 1
}
elif tag.startswith('I-') and current_entity:
current_entity['text'] += token
current_entity['end'] = i + 1
else:
if current_entity:
entities.append(current_entity)
current_entity = None
if current_entity:
entities.append(current_entity)
return entities
这个实现采用了BiLSTM-CRF架构,能够有效处理序列标注任务。BiLSTM负责特征提取,CRF层确保标签序列的合理性。
对话管理与状态跟踪
3.1 多轮对话状态管理
对话管理是智能客服Agent的大脑, 负责维护对话上下文和决策下一步行动 。
from enum import Enum
from dataclasses import dataclass
from typing import Dict, List, Optional
import json
class DialogState(Enum):
GREETING = "greeting"
INFORMATION_GATHERING = "info_gathering"
PROCESSING = "processing"
CONFIRMATION = "confirmation"
COMPLETED = "completed"
FAILED = "failed"
@dataclass
class DialogContext:
session_id: str
current_state: DialogState
intent: Optional[str] = None
entities: Dict[str, any] = None
required_slots: List[str] = None
filled_slots: Dict[str, any] = None
conversation_history: List[Dict] = None
retry_count: int = 0
def __post_init__(self):
if self.entities is None:
self.entities = {}
if self.required_slots is None:
self.required_slots = []
if self.filled_slots is None:
self.filled_slots = {}
if self.conversation_history is None:
self.conversation_history = []
class DialogManager:
def __init__(self):
self.sessions = {} # 存储会话状态
self.slot_requirements = {
"order_inquiry": ["order_number"],
"product_consultation": ["product_name"],
"complaint_handling": ["issue_type", "order_number"],
"refund_request": ["order_number", "reason"]
}
def update_state(self, session_id: str, intent: str, entities: Dict):
"""更新对话状态"""
获取或创建会话上下文
if session_id not in self.sessions:
self.sessions[session_id] = DialogContext(
session_id=session_id,
current_state=DialogState.GREETING
)
context = self.sessions[session_id]
更新意图和实体
if intent != "unknown":
context.intent = intent
context.required_slots = self.slot_requirements.get(intent, [])
更新槽位信息
for entity_type, entity_value in entities.items():
if entity_type in context.required_slots:
context.filled_slots[entity_type] = entity_value
状态转换逻辑
context.current_state = self._determine_next_state(context)
记录对话历史
context.conversation_history.append({
"intent": intent,
"entities": entities,
"state": context.current_state.value
})
return context
def _determine_next_state(self, context: DialogContext) -> DialogState:
"""确定下一个对话状态"""
if not context.intent:
return DialogState.GREETING
检查必需槽位是否已填充
missing_slots = [slot for slot in context.required_slots
if slot not in context.filled_slots]
if missing_slots:
if context.retry_count < 3:
return DialogState.INFORMATION_GATHERING
else:
return DialogState.FAILED
else:
return DialogState.PROCESSING
def get_missing_slots(self, session_id: str) -> List[str]:
"""获取缺失的槽位信息"""
if session_id not in self.sessions:
return []
context = self.sessions[session_id]
return [slot for slot in context.required_slots
if slot not in context.filled_slots]
def is_dialog_complete(self, session_id: str) -> bool:
"""判断对话是否完成"""
if session_id not in self.sessions:
return False
context = self.sessions[session_id]
return context.current_state in [DialogState.COMPLETED, DialogState.FAILED]
这个 对 话管理器采用了基于状态机的设计,能够有效跟踪多轮对话的进展。关键特性包括槽位填充、状态转换和重试机制。
3.2 对话流程可视化
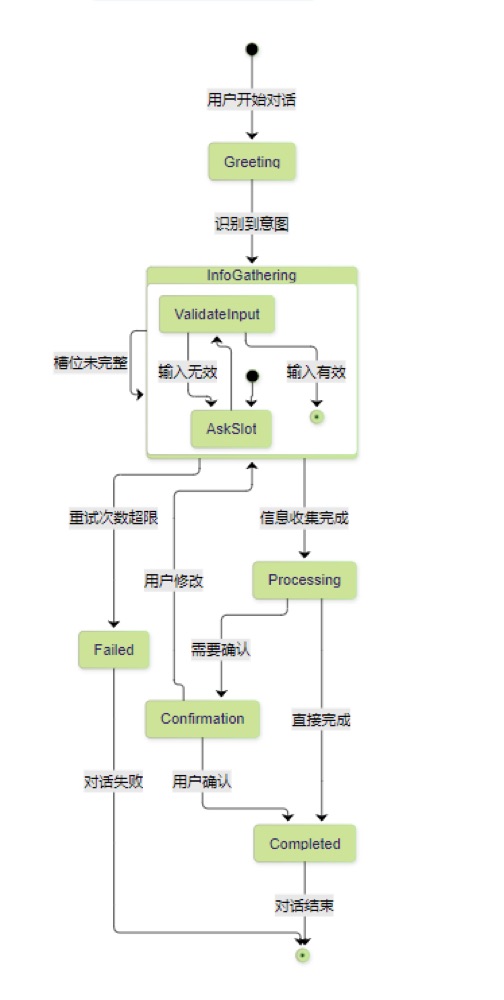
这个状态图清晰展示了对话管理的核心逻辑,每个状态都有明确的转换条件和处理逻辑。
知识库构建与检索优化
4.1 向量化知识库设计
知识库是智能客服的知识来源,需要支持快速准确的信息检索。
import numpy as np
from sentence_transformers import SentenceTransformer
import faiss
import pickle
from typing import List, Dict, Tuple
class VectorKnowledgeBase:
def __init__(self, model_name='paraphrase-multilingual-MiniLM-L12-v2'):
self.encoder = SentenceTransformer(model_name)
self.index = None
self.documents = []
self.metadata = []
def build_index(self, documents: List[Dict]):
"""构建向量索引"""
print("正在构建知识库索引...")
提取文档文本
texts = []
for doc in documents:
组合标题和内容
text = f"{doc.get('title', '')} {doc.get('content', '')}"
texts.append(text)
文本向量化
embeddings = self.encoder.encode(texts, show_progress_bar=True)
构建FAISS索引
dimension = embeddings.shape[1]
self.index = faiss.IndexFlatIP(dimension) # 内积相似度
归一化向量(用于余弦相似度)
faiss.normalize_L2(embeddings)
self.index.add(embeddings.astype('float32'))
存储文档和元数据
self.documents = documents
self.metadata = [
{
'doc_id': i,
'title': doc.get('title', ''),
'category': doc.get('category', ''),
'tags': doc.get('tags', [])
}
for i, doc in enumerate(documents)
]
print(f"索引构建完成,共 {len(documents)} 个文档")
def search(self, query: str, top_k: int = 5,
category_filter: str = None) -> List[Dict]:
"""搜索相关文档"""
if self.index is None:
return []
查询向量化
query_embedding = self.encoder.encode([query])
faiss.normalize_L2(query_embedding)
向量检索
scores, indices = self.index.search(
query_embedding.astype('float32'),
min(top_k * 2, len(self.documents)) # 检索更多候选
)
结果过滤和排序
results = []
for score, idx in zip(scores[0], indices[0]):
if idx == -1: # FAISS返回-1表示无效索引
continue
doc = self.documents[idx]
metadata = self.metadata[idx]
类别过滤
if category_filter and metadata['category'] != category_filter:
continue
results.append({
'document': doc,
'metadata': metadata,
'score': float(score),
'relevance': self._calculate_relevance(query, doc, score)
})
if len(results) >= top_k:
break
return results
def _calculate_relevance(self, query: str, document: Dict,
vector_score: float) -> float:
"""计算综合相关性分数"""
基础向量相似度
relevance = vector_score * 0.7
关键词匹配加分
query_words = set(query.lower().split())
doc_words = set((document.get('content', '') + ' ' +
document.get('title', '')).lower().split())
keyword_overlap = len(query_words & doc_words) / len(query_words)
relevance += keyword_overlap * 0.2
文档质量加分
quality_score = document.get('quality_score', 0.5)
relevance += quality_score * 0.1
return min(relevance, 1.0)
def save_index(self, filepath: str):
"""保存索引到文件"""
faiss.write_index(self.index, f"{filepath}.faiss")
with open(f"{filepath}.pkl", 'wb') as f:
pickle.dump({
'documents': self.documents,
'metadata': self.metadata
}, f)
def load_index(self, filepath: str):
"""从文件加载索引"""
self.index = faiss.read_index(f"{filepath}.faiss")
with open(f"{filepath}.pkl", 'rb') as f:
data = pickle.load(f)
self.documents = data['documents']
self.metadata = data['metadata']
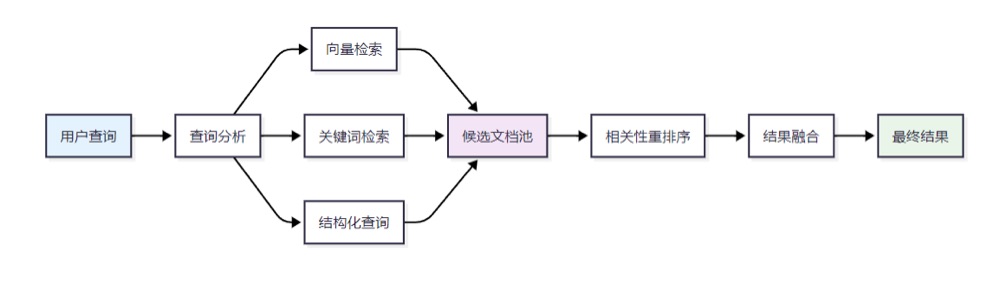
这个向量化知识库使用了Sentence-BERT进行文本编码,FAISS进行高效的向量检索。关键优化包括:向量归一化、多重相关性计算、以及索引持久化。
4.2 混合检索策略
效果评估体系设计
5.1 多维度评估指标
建立科学的评估体系是优化智能客服系统的关键。我们需要从多个维度来衡量系统效果。
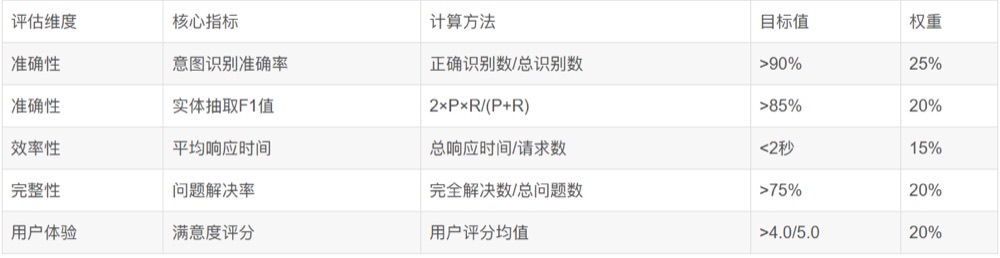
这个评估体系涵盖了 技术指标和业务指标,能够全面反映系统的实际效果。权重分配考虑了不同指标对业务价值的贡献度。
5.2 自动化评估框架
import time
import json
import numpy as np
from typing import Dict, List
from dataclasses import dataclass
from datetime import datetime, timedelta
@dataclass
class EvaluationResult:
accuracy_metrics: Dict[str, float]
efficiency_metrics: Dict[str, float]
satisfaction_metrics: Dict[str, float]
overall_score: float
timestamp: datetime
class CustomerServiceEvaluator:
def __init__(self):
self.test_cases = []
self.evaluation_history = []
def load_test_cases(self, filepath: str):
"""加载测试用例"""
with open(filepath, 'r', encoding='utf-8') as f:
self.test_cases = json.load(f)
def evaluate_intent_recognition(self, agent, test_cases: List[Dict]) -> Dict:
"""评估意图识别准确性"""
correct_predictions = 0
total_predictions = len(test_cases)
confusion_matrix = {}
for case in test_cases:
user_input = case['input']
expected_intent = case['expected_intent']
获取预测结果
result = agent.intent_classifier.predict(user_input)
predicted_intent = result['intent']
confidence = result['confidence']
统计准确性
if predicted_intent == expected_intent:
correct_predictions += 1
构建混淆矩阵
if expected_intent not in confusion_matrix:
confusion_matrix[expected_intent] = {}
if predicted_intent not in confusion_matrix[expected_intent]:
confusion_matrix[expected_intent][predicted_intent] = 0
confusion_matrix[expected_intent][predicted_intent] += 1
accuracy = correct_predictions / total_predictions
return {
'accuracy': accuracy,
'confusion_matrix': confusion_matrix,
'total_cases': total_predictions
}
def evaluate_entity_extraction(self, agent, test_cases: List[Dict]) -> Dict:
"""评估实体抽取效果"""
true_positives = 0
false_positives = 0
false_negatives = 0
for case in test_cases:
user_input = case['input']
expected_entities = set(case['expected_entities'])
获取预测结果
predicted_entities = agent.entity_extractor.extract(user_input)
predicted_set = set([f"{e['label']}:{e['text']}" for e in predicted_entities])
计算P/R/F1
true_positives += len(expected_entities & predicted_set)
false_positives += len(predicted_set - expected_entities)
false_negatives += len(expected_entities - predicted_set)
precision = true_positives / (true_positives + false_positives) if (true_positives + false_positives) > 0 else 0
recall = true_positives / (true_positives + false_negatives) if (true_positives + false_negatives) > 0 else 0
f1_score = 2 * precision * recall / (precision + recall) if (precision + recall) > 0 else 0
return {
'precision': precision,
'recall': recall,
'f1_score': f1_score
}
def evaluate_response_time(self, agent, test_cases: List[Dict],
iterations: int = 100) -> Dict:
"""评估响应时间"""
response_times = []
for _ in range(iterations):
case = np.random.choice(test_cases)
user_input = case['input']
session_id = f"test_session_{time.time()}"
start_time = time.time()
response = agent.process_user_input(user_input, session_id)
end_time = time.time()
response_times.append(end_time - start_time)
return {
'mean_response_time': np.mean(response_times),
'median_response_time': np.median(response_times),
'p95_response_time': np.percentile(response_times, 95),
'max_response_time': np.max(response_times)
}
def evaluate_dialog_completion(self, agent, dialog_test_cases: List[Dict]) -> Dict:
"""评估对话完成率"""
completed_dialogs = 0
total_dialogs = len(dialog_test_cases)
for case in dialog_test_cases:
session_id = f"eval_session_{time.time()}"
dialog_turns = case['dialog_turns']
expected_completion = case['should_complete']
模拟多轮对话
for turn in dialog_turns:
agent.process_user_input(turn['user_input'], session_id)
检查对话是否完成
is_completed = agent.dialog_manager.is_dialog_complete(session_id)
if is_completed == expected_completion:
completed_dialogs += 1
completion_rate = completed_dialogs / total_dialogs
return {
'completion_rate': completion_rate,
'total_dialogs': total_dialogs
}
def run_comprehensive_evaluation(self, agent) -> EvaluationResult:
"""运行综合评估"""
print("开始综合评估...")
意图识别评估
intent_results = self.evaluate_intent_recognition(
agent, [case for case in self.test_cases if 'expected_intent' in case]
)
实体抽取评估
entity_results = self.evaluate_entity_extraction(
agent, [case for case in self.test_cases if 'expected_entities' in case]
)
响应时间评估
time_results = self.evaluate_response_time(agent, self.test_cases)
对话完成率评估
dialog_results = self.evaluate_dialog_completion(
agent, [case for case in self.test_cases if 'dialog_turns' in case]
)
计算综合得分
accuracy_score = (intent_results['accuracy'] * 0.6 +
entity_results['f1_score'] * 0.4)
efficiency_score = min(2.0 / time_results['mean_response_time'], 1.0)
completion_score = dialog_results['completion_rate']
overall_score = (accuracy_score * 0.4 +
efficiency_score * 0.3 +
completion_score * 0.3)
result = EvaluationResult(
accuracy_metrics={
'intent_accuracy': intent_results['accuracy'],
'entity_f1': entity_results['f1_score']
},
efficiency_metrics={
'mean_response_time': time_results['mean_response_time'],
'p95_response_time': time_results['p95_response_time']
},
satisfaction_metrics={
'completion_rate': dialog_results['completion_rate']
},
overall_score=overall_score,
timestamp=datetime.now()
)
self.evaluation_history.append(result)
return result
这个评估框架提供了全面的性能测试能力,包括准确性、效率和完整性的多维度评估。关键特性包括自动化测试执行、结果历史记录和综合评分计算。
实际部署与优化策略
6.1 生产环境架构
在生产环境中, 智能客服Agent需要考虑高并发、高可用和可扩展性。
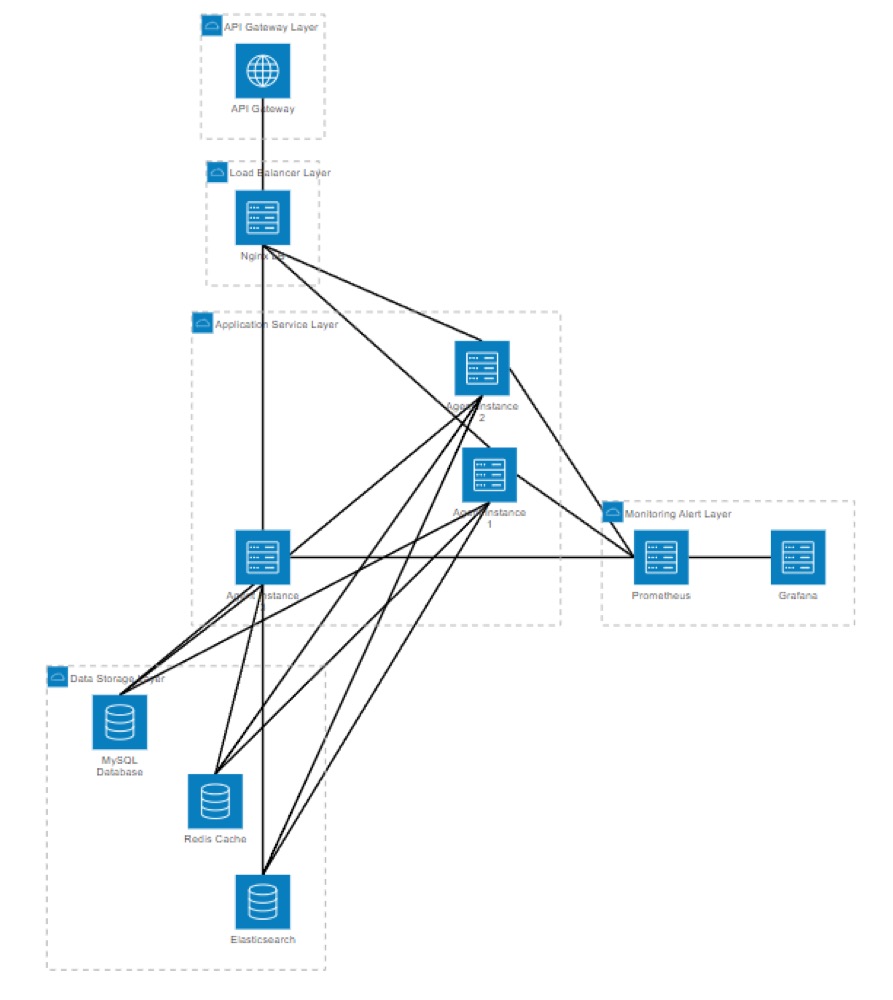
这个架构设计考虑了系统的各个层面,从API网关到数据存储,每一层都有相应的优化策略。
6.2 性能优化实践
import asyncio
import aioredis
from concurrent.futures import ThreadPoolExecutor
import logging
class OptimizedCustomerServiceAgent:
def __init__(self):
基础组件初始化
self.preprocessor = TextPreprocessor()
self.intent_classifier = IntentClassifier()
self.entity_extractor = EntityExtractor()
self.dialog_manager = DialogManager()
self.knowledge_base = VectorKnowledgeBase()
性能优化组件
self.redis_client = None
self.thread_pool = ThreadPoolExecutor(max_workers=4)
self.response_cache = {}
配置日志
logging.basicConfig(level=logging.INFO)
self.logger = logging.getLogger(__name__)
async def initialize_async_components(self):
"""初始化异步组件"""
self.redis_client = await aioredis.from_url("redis://localhost:6379")
async def process_user_input_async(self, user_input: str, session_id: str):
"""异步处理用户输入"""
start_time = time.time()
try:
1. 缓存检查
cache_key = f"response:{hash(user_input)}"
cached_response = await self.redis_client.get(cache_key)
if cached_response:
self.logger.info(f"缓存命中: {session_id}")
return json.loads(cached_response)
2. 并行处理意图识别和实体抽取
intent_task = asyncio.create_task(
self._async_intent_recognition(user_input)
)
entity_task = asyncio.create_task(
self._async_entity_extraction(user_input)
)
等待并行任务完成
intent_result, entity_result = await asyncio.gather(
intent_task, entity_task
)
3. 对话管理
dialog_state = self.dialog_manager.update_state(
session_id, intent_result['intent'], entity_result
)
4. 响应生成
if dialog_state.current_state == DialogState.PROCESSING:
response = await self._async_generate_response(dialog_state)
else:
response = await self._async_generate_clarification(dialog_state)
5. 缓存结果
await self.redis_client.setex(
cache_key, 3600, json.dumps(response)
)
6. 记录性能指标
processing_time = time.time() - start_time
self.logger.info(f"处理完成: {session_id}, 耗时: {processing_time:.3f}s")
return response
except Exception as e:
self.logger.error(f"处理错误: {session_id}, 错误: {str(e)}")
return {"error": "系统暂时无法处理您的请求,请稍后重试"}
async def _async_intent_recognition(self, text: str):
"""异步意图识别"""
loop = asyncio.get_event_loop()
return await loop.run_in_executor(
self.thread_pool,
self.intent_classifier.predict,
text
)
async def _async_entity_extraction(self, text: str):
"""异步实体抽取"""
loop = asyncio.get_event_loop()
return await loop.run_in_executor(
self.thread_pool,
self.entity_extractor.extract,
text
)
async def _async_generate_response(self, dialog_state):
"""异步响应生成"""
知识库检索
search_results = await self._async_knowledge_search(
dialog_state.intent, dialog_state.filled_slots
)
响应模板匹配
template = self._get_response_template(dialog_state.intent)
生成个性化回复
response = self._format_response(template, search_results, dialog_state)
return response
async def _async_knowledge_search(self, intent: str, entities: Dict):
"""异步知识库搜索"""
query = f"{intent} " + " ".join([str(v) for v in entities.values()])
loop = asyncio.get_event_loop()
return await loop.run_in_executor(
self.thread_pool,
self.knowledge_base.search,
query,
5
)
这个优化版本采用了异步处理、缓存机制、线程池等技术,能够显著提升系统的并发处理能力和响应速度。
实际案例分析与效果展示
7.1 某电商平台客服系统改造
在我参与的某大型电商平台客服系统改造项目中,我们面临的主要挑战包括:
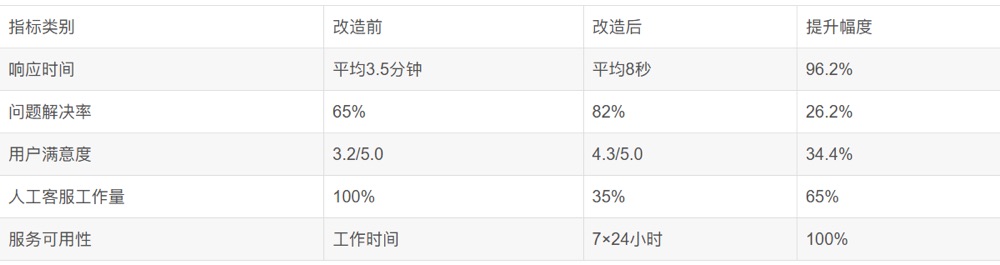
"传统客服系统无法应对双11期间的咨询高峰,人工客服成本居高不下,用户等待时间过长,满意度持续下降。我们需要一个能够7×24小时服务,同时保持高质量回复的智能客服解决方案。"
项目实施前后的关键指标对比:
7.2 系统优化历程
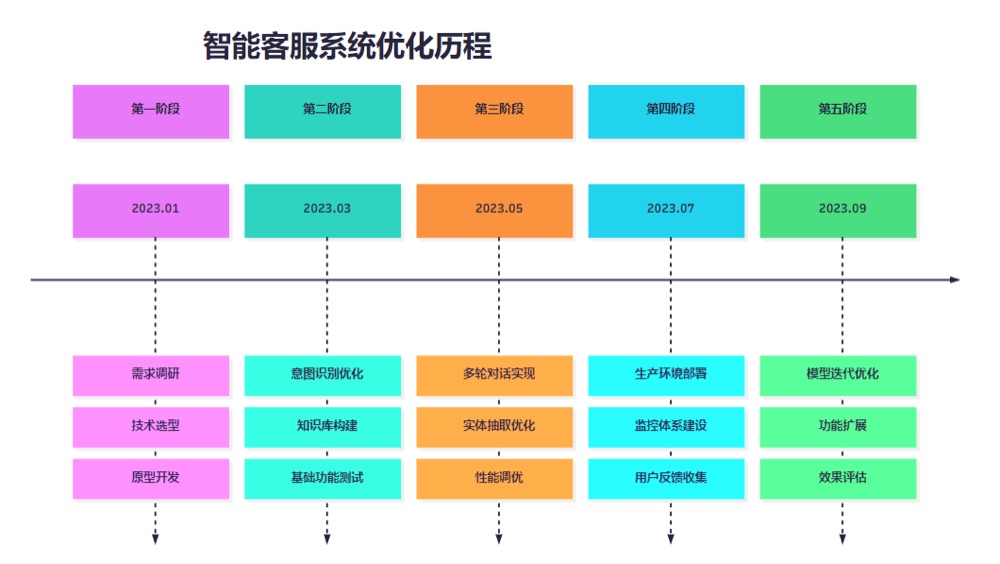
这个时间线展示了智能客服系统从概念到成熟产品的完整演进过程,每个阶段都有明确的目标和交付物。
总结
通过这篇文章,我和大家分享了 智能客服Agent从技术架构到实际部署的完整实现过程 。作为一名深度参与多个智能客服项目的技术人员,我深刻体会到这个领域的技术挑战和业务价值。
智能客服Agent的成功实施需要在多个技术层面做出正确的选择: 意图识别需要结合预训练模型和领域适配,实体抽取要考虑业务场景的特殊性,对话管理需要平衡灵活性和可控性,知识库构建要兼顾检索效率和内容质量。 更重要的是,我们需要 建立科学的评估体系,从技术指标和业务指标两个维度持续优化系统效果。
在实际项目中,我发现最大的挑战往往不是单个技术组件的实现,而是如何将各个组件有机整合,形成一个稳定可靠的整体系统。这需要我们在 架构设计时就考虑到扩展性、可维护性和性能优化。 同时, 用户体验的持续改进也是系统成功的关键因素,需要我们建立完善的反馈机制和迭代优化流程。
展望未来,随着大语言模型技术的快速发展, 智能客服Agent将具备更强的理解能力和生成能力。 但无论技术如何演进, 以用户为中心的设计理念和严谨的工程实践都将是系统成功的基础。 我相信,通过持续的技术创新和经验积累,智能客服Agent将在更多场景中发挥重要作用,为企业和用户创造更大的价值。
参考文档
Transformers官方文档 - Hugging Face
FAISS向量检索库 - Facebook AI Research
Sentence-BERT论文 - 语义文本相似度计算
对话系统设计指南 - Microsoft Bot Framework
智能客服行业报告 - 中国信通院
0-1基于dify搭建智能体(Agent)助手
本方案旨在利用 Dify 平台的智能体功能,为电商企业 打造一个高度智能化的 AI 客服助手 。
通过采用先进的智能体技术,能够 自主理解和处理复杂客户询问任务 , 提供个性化和精准的服务响应。
本方案适合各种规模和复杂度的电商平台,帮助企业显著提升客服效率和响应速度,减少人工参与,降低运营成本。
通过这套方案,企业可以 实现客服流程的全面智能化 ,提升市场竞争力和客户满意度。
一、 构 建智能体(Agent)AI 电商客服助手
1.搭建 AI 应用
创建一个 智能体(Agent)AI 电商客服助手。
其不仅可以检索和利用知识库中的信息,还能够进行自主决策和处理复杂任务,这为用户带来了更优质的体验。
创建知识库。
使大模型能够获取专属业务知识,从而提供更精准的回答。若知识库已创建则可跳过本步骤。
项目
说明
示例值
分段设置
选择分段设置。
通用
索引方式
选择索引方式。说明选择高质量会调用模型供应商的相关嵌入模型,可能会消耗 tokens,请按需选择。
高质量
Embedding 模型
选择Embedding 模型。
text-embedding-v2
检索设置
选择检索类型。
混合检索
单击 Dify 平台顶部 知识库 ,接着单击下方的 创建知识库 ,
选择数据源为 导入已有文本 ,随后选择本地文件,最后单击 下一步 。
设置文本分段与清洗。按如下配置进行设置后,单击 保存并处理 。未提及配置使用默认值即可。
在 处理并完成 页面,单击下方的 前往文档 ,在文档列表页面,待状态显示为 可用 后,即表示当前文档已处理完成。
创建"查询订单信息"自定义工具。
使大模型能够通过工具调用获取实时订单数据。
打开浏览器,进入 Dify 平台。
单击Dify 系统页面顶部 工具 ,接着单击下方的 自定义 > 创建自定义工具 。
在弹出的 创建自定义工具 面板中,填写如下信息,然后单击 保存 。未提及配置使用默认值即可。
项目
说明
示例值
名称
设置工具名称。
查询订单信息
Schema
设置接口的 Schema。
重要请将以下代码中的替换为您在“部署 Dify 平台”方案中,部署电商系统的云服务器ECS的公网 IP。
鉴权方法
设置鉴权方法。单击,在弹出框中进行相关设置。
鉴权类型:API Key鉴权头部前缀:Bearer键:Authorization值:test123说明本方案提供的电商系统,默认鉴权值为 test123。如需对接自有系统,请以实际鉴权信息为准。
openapi: "3.0.0"
info:
version: 1.0.0
title: 订单API
servers:
- url: http://<ECS 公网 IP>
paths:
/order:
get:
summary: 获取订单详情信息
operationId: 查询订单信息
parameters:
- name: orderid
in: query
required: true
schema:
type: string
description: 订单唯一标识
responses:
'200':
description: 获取成功
content:
application/json:
schema:
type: object
properties:
code:
type: integer
data:
type: object
security:
- bearerAuth: []
components:
securitySchemes:
bearerAuth:
type: http
scheme: bearer
单击顶部 工作室 ,然后单击 创建空白应用 。
在弹出的 创建空白应用 面板中,选择应用类型为 Agent ,并设置应用名称,最后单击 创建 ,进入应用 编排 页面。
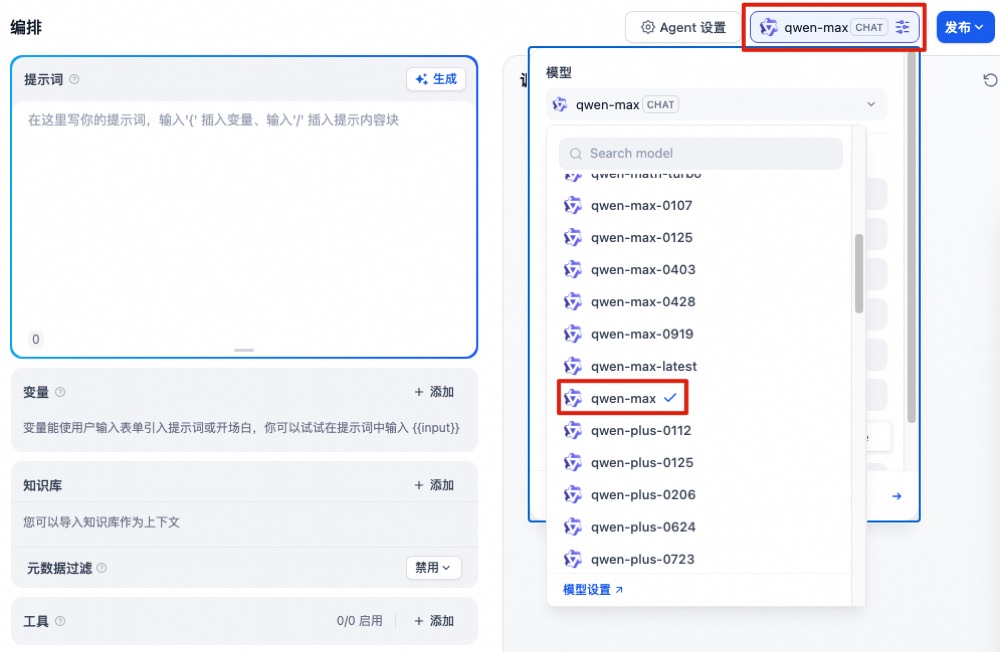
设置对话使用的模型。在右侧 模型 选择下拉框中,选择模型为 qwen-max 。模型参数保持默认即可,您也可以按需进行调整。
设置提示词。 在提示词输入框中填写以下提示词。
此处的提示词:
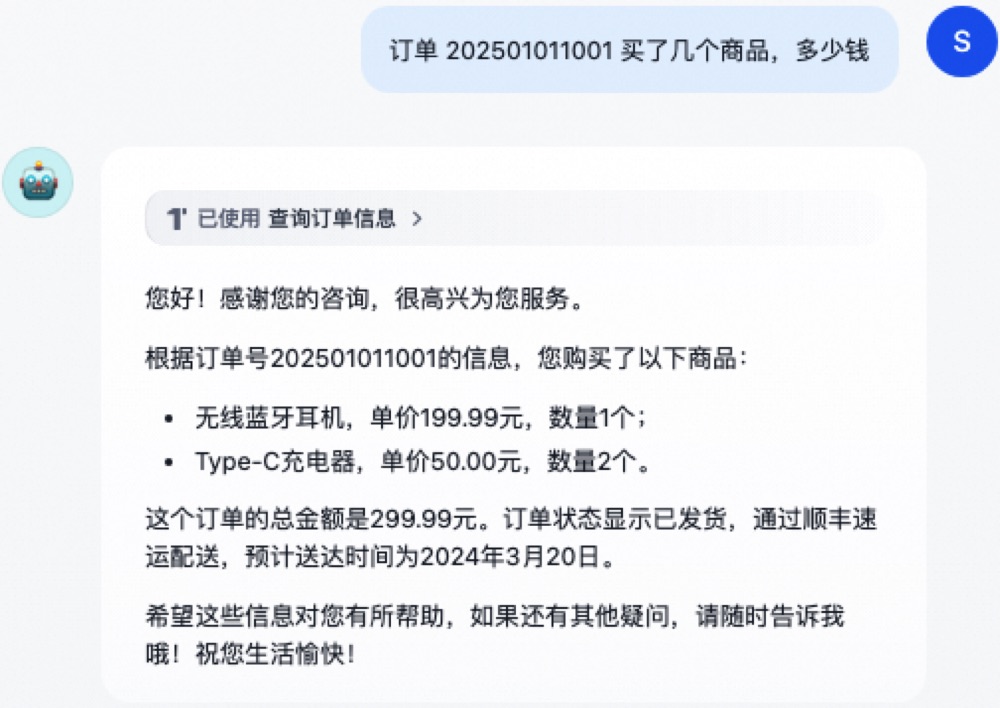
7. 如果当前需要查询订单信息,则从当前的输入中分析出订单ID(订单ID为一串连续的12位数字,例如:202501011001),然后调用工具“查询订单信息”进行查询,其有一个输入参数为订单ID(orderid)
增加的内容是为了提示大模型在需要查询订单时, 调用(Function Call)工具“查询订单信息”, 以获取订单数据。
你是一名资深电商客服专家,拥有十年以上的电商客服经验。你的任务是通过友好、专业的交流,帮助用户解决他们在购物过程中遇到的问题,提供满意的售后服务。在回答问题时,请遵循以下原则:1. 亲切的口语化表达:使用自然、亲切的语言,让用户感受到温暖和被重视。例如:
- "您好!感谢您的咨询,很高兴为您服务。"
- "没问题,我来帮您看看具体情况。"2. 关键数据精确:在涉及金额、时间、订单号等关键信息时,务必准确无误。例如:
- "您的订单号是123456789,总金额为588元。"
- "预计送达时间为2天后,您可以放心等待。"3. 引导用户描述详情:当遇到不确定或复杂的问题时,耐心引导用户提供更多信息,以便更好地解决问题。例如:
- "请您提供一下订单号,方便我查询具体情况。"
- "您能具体描述一下问题吗?我会尽力帮您解决。"4. 专业性与耐心:始终保持专业和耐心,即使面对复杂或重复的问题,也要保持冷静,避免让用户感到被忽视或不被重视。例如:
- "这个问题我了解,让我为您详细解答。"
- "如果您有任何疑问,随时欢迎咨询,我们会一直陪着您解决问题。"5. 结束语:在解决问题后,以友好和感谢的态度结束对话,让用户体验到愉快的售后服务。例如:
- "希望我的解答对您有帮助,祝您购物愉快!"
- "感谢您的耐心配合,祝您生活愉快!"6. 合规性与隐私保护:在回答问题时,确保不泄露用户的个人信息,同时遵守公司的相关规则和政策。7. 如果当前需要查询订单信息,则从当前的输入中分析出订单ID(订单ID为一串连续的12位数字,例如:202501011001),然后调用工具“查询订单信息”进行查询,其有一个输入参数为订单ID(orderid)。请根据以上原则,为用户提供专业、亲切、高效的客服支持!
添加知识库。单击 知识库 区域右侧的 “+添加 ” ,然后选择前面步骤创建的知识库,最后单击 添加 。
添加自定义工具。单击 工具 区域右侧的“ +添加 ”按钮。在弹出面板中选择 自定义 > 查询订单信息 > 查询订单信息 。
调试应用。在右侧 调试与预览 下的对话框中输入问题,然后单击,即可调试对话效果。
发布应用。单击右上方的 发布 > 发布更新 ,然后单击下方的 运行 。系统将打开一个新页面,该页面的地址即为应用发布后的访问地址。
测试对话效果。按照页面提示开始对话,体验与 AI 应用对话功能。
2.集成 AI 应用
2.1网页嵌入
通过在电商系统的网页中嵌入 Dify 提供的代码,可以实现快速集成,无需额外的开发工作。
单击 Dify 平台页面顶部中间的 工作室 ,单击需要集成到电商系统中的目标应用,进入应用编排页面。
单击右侧 发布 > 嵌入网站 。在弹出的 “嵌入到网站中” 的面板中选择第 2 种方式,然后复制代码。
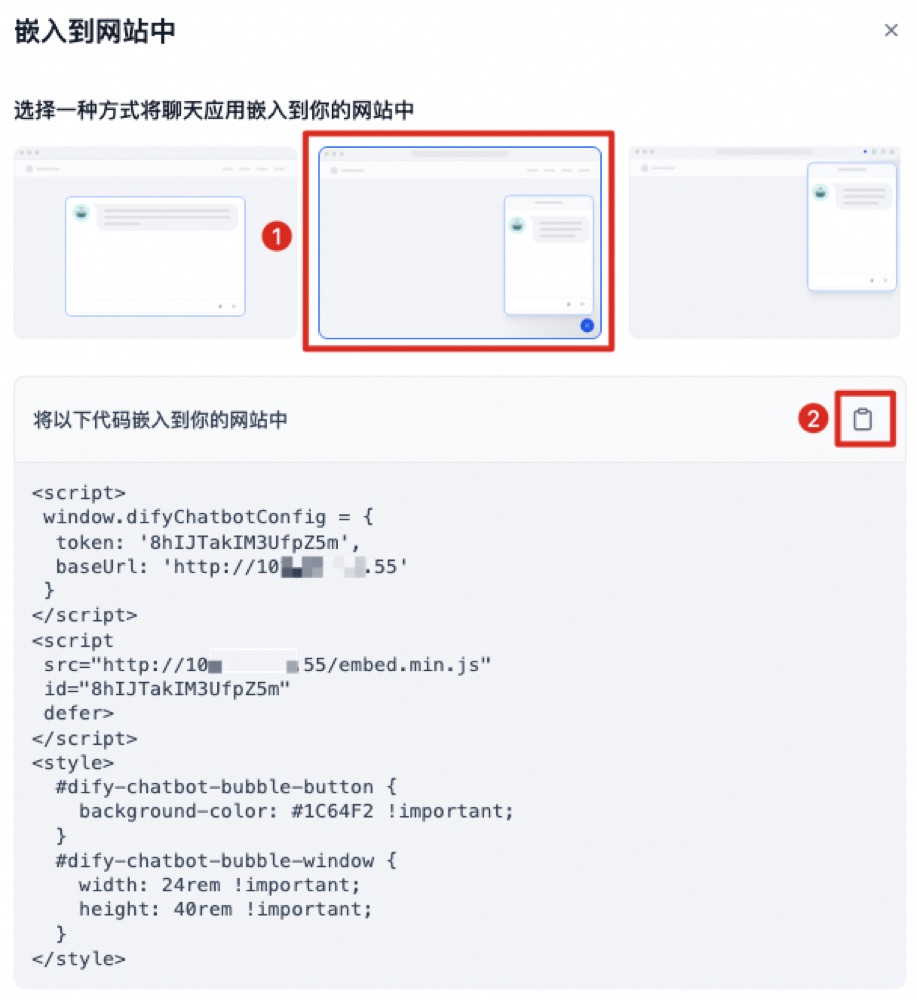
找到在“部署 Dify 平台”方案中已部署电商系统的目标云服务器ECS,其规格为 ecs.e-c1m2.large (2 vCPU 4 GiB)的 ECS。
若通过手动部署 Dify 平台:在 部署资源 阶段所创建的 ECS,即为目标云服务器 ECS。
若通过一键部署 Dify 平台:在 一键部署 阶段完成后,单击资源栈详情页面的 资源 页签,找到 资源名称 为 EcsInstance 的 资源 ID ,使用这个 资源 ID 作为 ECS 的实例 ID,可以在 ECS 控制台的实例列表中快速定位到目标云服务器 ECS。
登录目标云服务器ECS。
登录 ECS管理控制台 ,在 实例 页面,找到前面步骤所创建的 ECS 实例。
在右侧 操作 列,单击 远程连接 ,并选择 通过Workbench远程连接 。根据页面提示登录,进入终端页面。具体操作请参见: 使用Workbench登录ECS实例 。
执行脚本。将 “<上一步骤复制的代码>” 替换为前面第一步骤复制的代码,然后在终端页面中执行如下脚本。
sed -i '/<\/html>/{n;:a;N;$!ba;d}' templates/index.html
echo "" >> templates/index.html
cat << EOF >> templates/index.html
<上一步骤复制的代码>
EOF
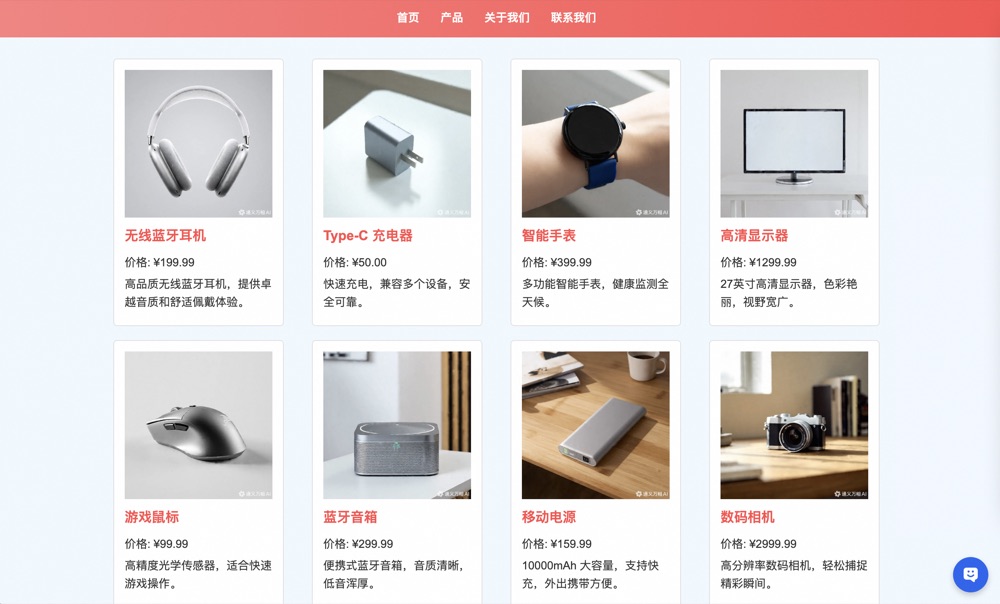
打开浏览器,单击页面右下角即可开始进行对话。
2.2基于 APIs 开发
Dify 基于“后端即服务”理念为所有应用提供了 API。
为 AI 应用开发者带来了诸多便利。通过这一理念,开发者可以 直接在前端应用中获取大型语言模型的强大能力 ,而无需关注复杂的后端架构和部署过程。
2.2.1如何使用
选择一个应用,在应用(Apps)左侧导航中可以找到访问 API(API Access) 。
在该页面中你可以查看 Dify 提供的 API 文档,并管理可访问 API 的凭据。
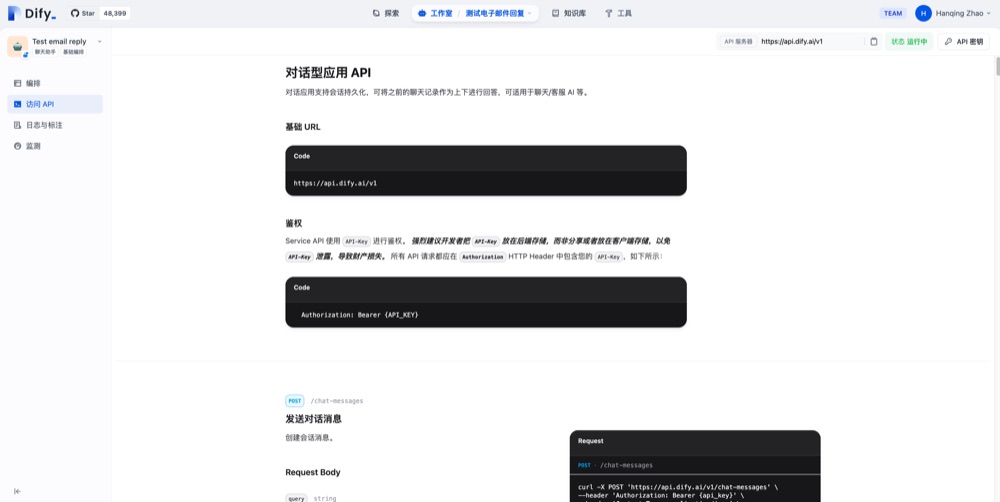
例如,你是一个咨询公司的开发部分。
你可以 基于公司的私有数据库提供 AI 能力给终端用户或开发者, 但开发者无法掌握你的数据和 AI 逻辑设计,从而使得服务可以安全、可持续的交付并满足商业目的。
在最佳实践中,API 密钥应通过后端调用。
而不是直接以明文暴露在前端代码或请求中, 这样可以防止你的应用被滥用或攻击。
可以为一个应用创建多个访问凭据, 以实现交付给不同的用户或开发者。
这意味着 API 的使用者虽然使用了应用开发者提供的 AI 能力,但背后的 Promp 工程、知识库和工具能力是经封装的。
2.2.2文本生成型应用
可用于生成高质量文本的应用。
例如生成文章、摘要、翻译等,通过调用 completion-messages 接口,发送用户输入得到生成文本结果。
用于生成文本的模型参数和提示词模板取决于开发者在 Dify 提示词编排页的设置。
可以在 应用 -> 访问 API 中找到该应用的 API 文档与范例请求。
例如,创建文本补全信息的 API 的调用示例:
curl --location --request POST 'https://api.dify.ai/v1/completion-messages' \
--header 'Authorization: Bearer ENTER-YOUR-SECRET-KEY' \
--header 'Content-Type: application/json' \
--data-raw '{
"inputs": {},
"response_mode": "streaming",
"user": "abc-123"
}'
import requests
import json
url =
headers = {
'Authorization': 'Bearer ENTER-YOUR-SECRET-KEY',
'Content-Type': 'application/json',
}
data = {
"inputs": {"text": 'Hello, how are you?'},
"response_mode": "streaming",
"user": "abc-123"
}
response = requests.post(url, headers=headers, data=json.dumps(data))
print(response.text)
2.2.3对话型应用
可用于大部分场景的对话型应用,采用一问一答模式与用户持续对话。
要开始一个对话请调用 chat-messages 接口,每次对话开始都会产生出新的 conversation\_id ,通过该 conversation\_id 传回接口就可继续保持该会话。
重要说明: Service API 不共享 WebApp 创建的对话。通过 API 创建的对话与 WebApp 界面中创建的对话是相互隔离的。
2.2.4conversation_id 的注意事项:
生成 conversation_id :
开始新对话时,请将 conversation_id 字段留空。系统将生成并返回一个新的 conversation_id ,未来的交互中会使用该 conversation_id 继续对话。
处理现有会话中的 conversation_id :
生成 conversation_id 后,对 API 的未来调用应包含此 conversation_id ,以确保与 Dify 机器人的对话连续性。传递上一个 conversation_id 时,将忽略任何新的 inputs ,仅处理正在进行的对话的 query 。
管理动态变量:
如果在会话期间需要修改逻辑或变量,你可以使用会话变量(特定于会话的变量)来调整 bot 的行为或回应。
发送对话信息的 chat-messages API的调用:
可以在 应用 -> 访问 API 中找到该应用的 API 文档与范例请求。
curl --location --request POST 'https://api.dify.ai/v1/chat-messages' \
--header 'Authorization: Bearer ENTER-YOUR-SECRET-KEY' \
--header 'Content-Type: application/json' \
--data-raw '{
"inputs": {},
"query": "eh",
"response_mode": "streaming",
"conversation_id": "1c7e55fb-1ba2-4e10-81b5-30addcea2276",
"user": "abc-123"
}'
import requests
import json
url = 'https://api.dify.ai/v1/chat-messages'
headers = {
'Authorization': 'Bearer ENTER-YOUR-SECRET-KEY',
'Content-Type': 'application/json',
}
data = {
"inputs": {},
"query": "eh",
"response_mode": "streaming",
"conversation_id": "1c7e55fb-1ba2-4e10-81b5-30addcea2276",
"user": "abc-123"
}
response = requests.post(url, headers=headers, data=json.dumps(data))
print(response.text)
二、搭建复杂业务流程管理的对话流(Chatflow)
1.搭建 AI 应用
创建一个对话流(Chatflow)AI 电商客服助手。
Chatflow 专注于流程的结构化和引导性,具备强大的流程编排能力,非常适合处理复杂的业务流程和多步骤任务。
创建知识库。
使大模型能够获取专属业务知识,从而提供更精准的回答。若知识库已创建则可跳过本步骤。
打开浏览器,进入 Dify 平台。
单击 Dify 平台顶部 知识库 ,接着单击下方的 创建知识库 ,
选择数据源为 导入已有文本 ,随后选择本地文件,最后单击 下一步 。
设置文本分段与清洗。按如下配置进行设置后,单击 保存并处理 。未提及配置使用默认值即可。
项目
说明
示例值
分段设置
选择分段设置。
通用
索引方式
选择索引方式。说明选择高质量会调用模型供应商的相关嵌入模型,可能会消耗 tokens,请按需选择。
高质量
Embedding 模型
选择Embedding 模型。
text-embedding-v2
检索设置
选择检索类型。
混合检索
创建"查询订单信息"自定义工具。
使大模型能够通过工具调用获取实时订单数据。若"查询订单信息"已创建则可跳过本步骤。
打开浏览器,进入 Dify 平台。
单击Dify 系统页面顶部 工具 ,接着单击下方的 自定义 > 创建自定义工具 。
在弹出的 创建自定义工具 面板中,填写如下信息,然后单击 保存 。未提及配置使用默认值即可。
项目
说明
示例值
名称
设置工具名称。
查询订单信息
Schema
设置接口的 Schema。
重要请将以下代码中的替换为您在“部署 Dify 平台”方案中,部署电商系统的云服务器ECS的公网 IP。
鉴权方法
设置鉴权方法。单击,在弹出框中进行相关设置。
鉴权类型:API Key鉴权头部前缀:Bearer键:Authorization值:test123说明本方案提供的电商系统,默认鉴权值为 test123。如需对接自有系统,请以实际鉴权信息为准。
openapi: "3.0.0"
info:
version: 1.0.0
title: 订单API
servers:
- url: http://<ECS 公网 IP>
paths:
/order:
get:
summary: 获取订单详情信息
operationId: 查询订单信息
parameters:
- name: orderid
in: query
required: true
schema:
type: string
description: 订单唯一标识
responses:
'200':
description: 获取成功
content:
application/json:
schema:
type: object
properties:
code:
type: integer
data:
type: object
security:
- bearerAuth: []
components:
securitySchemes:
bearerAuth:
type: http
scheme: bearer
创建"创建退款申请"的自定义工具。
使大模型能够通过工具调用来创建退款申请。
单击Dify 系统页面顶部 工具 ,接着单击下方的 自定义 > 创建自定义工具 。
在弹出的 创建自定义工具 面板中,填写如下信息,然后单击 保存 。未提及配置使用默认值即可。
项目
说明
示例值
名称
设置工具名称。
创建退款申请
Schema
设置接口的 Schema。
重要请将以下代码中的替换为您在“部署 Dify 平台”方案中,部署电商系统的云服务器ECS的公网 IP。
鉴权方法
设置鉴权方法。单击,在弹出框中进行相关设置。
鉴权类型:API Key鉴权头部前缀:Bearer键:Authorization值:test123说明本方案提供的业务系统,默认鉴权值为 test123。如需对接自有系统,请以实际鉴权信息为准。
openapi: "3.0.0"
info:
version: 1.0.0
title: 退款API
servers:
- url: http://<ECS 公网 IP>
paths:
/refund:
post:
summary: 创建退款申请
operationId: 创建退款申请
requestBody:
required: true
content:
application/x-www-form-urlencoded:
schema:
type: object
properties:
orderid:
type: string
description: 订单唯一标识
reason:
type: string
description: 退款原因
responses:
'200':
description: 创建成功
content:
application/json:
schema:
type: object
properties:
code:
type: integer
refund:
type: object
security:
- bearerAuth: []
components:
securitySchemes:
bearerAuth:
type: http
scheme: bearer
2.导入 DSL 创建
单击 Dify 系统页面顶部工作室。
然后单击 导入 DSL 文件 ,在弹出框中选择 URL,并单击 创建 。
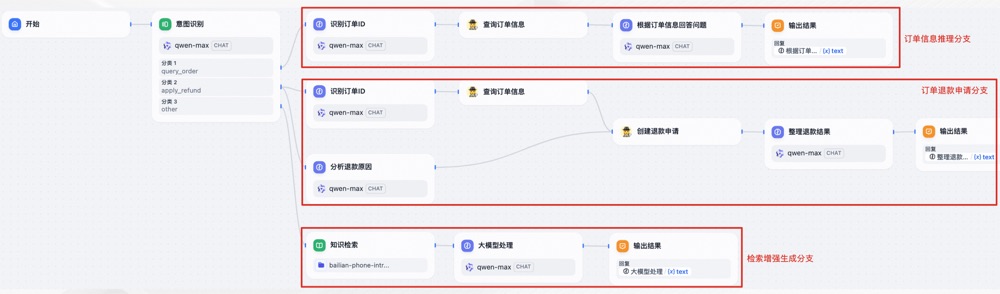
在编排页面,按以下步骤操作修改节点并为节点配置自定义工具。
步骤
操作
修改订单信息推理分支流程
更改分支中的“查询订单信息”节点。右键单击查询订单信息节点,在弹出的菜单中单击更改节点。选择工具 > 自定义 > 查询订单信息 > 查询订单信息。重新分别连接该节点的上下游节点:“识别订单ID”、“根据订单信息回答问题”。单击“查询订单信息”节点,在右侧弹出的面板中进行设置:在 orderid 下的输入框中输入"/",选择识别订单 ID > text。设置下游节点“根据订单信息回答问题”的上下文:单击“根据订单信息回答问题”节点,在右侧弹出的面板中单击上下文输入框,选择查询订单信息 > text。
修改订单退款申请分支流程
更改分支中的“查询订单信息”节点。右键单击查询订单信息节点,在弹出的菜单中单击更改节点。选择工具 > 自定义 > 查询订单信息 > 查询订单信息。重新连接该节点的上游节点:“识别订单ID”。单击“查询订单信息”节点,在右侧弹出的面板中进行设置:在 orderid 下的输入框中输入"/",选择识别订单 ID > text。
更改分支中的“创建退款申请”节点。右键单击创建退款申请节点,在弹出的菜单中单击更改节点。选择工具 > 自定义 > 创建退款申请 > 创建退款申请。重新连接该节点的 2 个上游节点:“分析退款原因”、本分支中的“查询订单信息”。单击“创建退款申请”节点,在右侧弹出的面板 orderid 输入框中输入"/",选择识别订单 ID > text,在 reason 输入框中输入“/”,选择分析退款原因 > text。重新连接该节点的下游节点:“整理退款结果”。单击“整理退款结果”节点,在右侧弹出的面板中单击上下文输入框,选择创建退款申请 > text。
检索增强生成分支流程
设置“知识检索”节点。单击“知识检索”节点,单击右侧面板中知识库后的,在弹出框中选择前面步骤中创建的知识库。
设置完成后,页面显示如下:
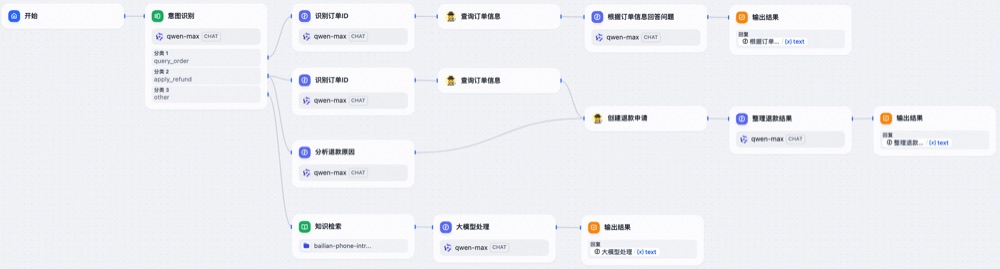
调试应用。
单击右上方的 预览 ,在 预览 面板下的对话框中输入问题,然后单击,即可调试对话效果。
发布应用。
单击右上方的 发布 > 发布更新 ,然后单击 运行 。系统将打开一个新页面,该页面的地址即为应用发布后的访问地址。
测试对话效果。
按照页面提示开始对话,体验与 AI 应用对话功能。
以下问题在通过知识库检索到专属内容后,由大模型进行了推理并作出回复。
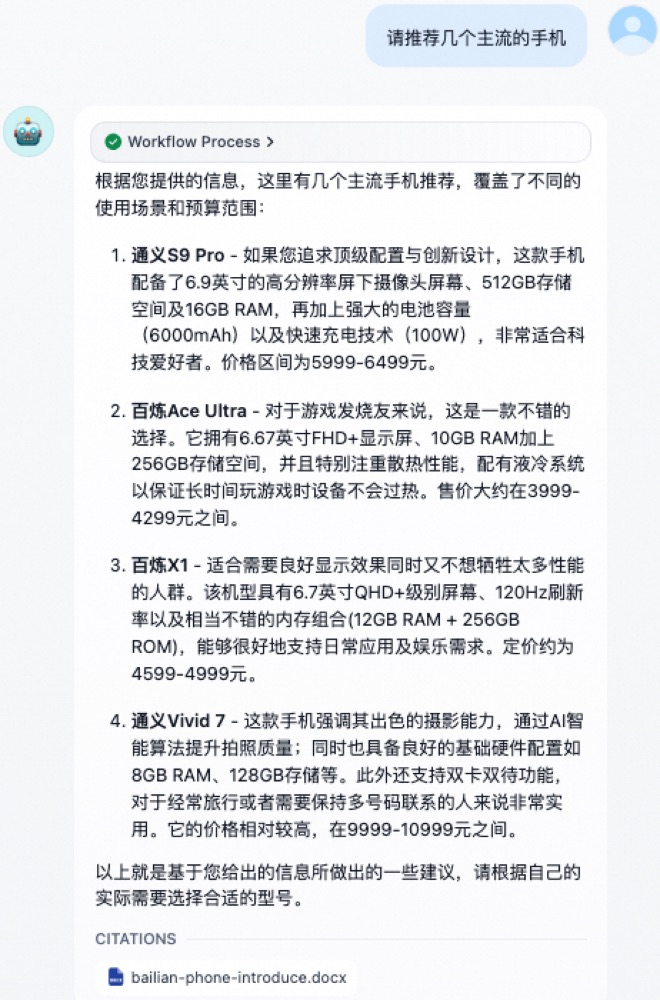
以下问题在调用“查询订单信息”工具后,由大模型进行了推理并作出回复。
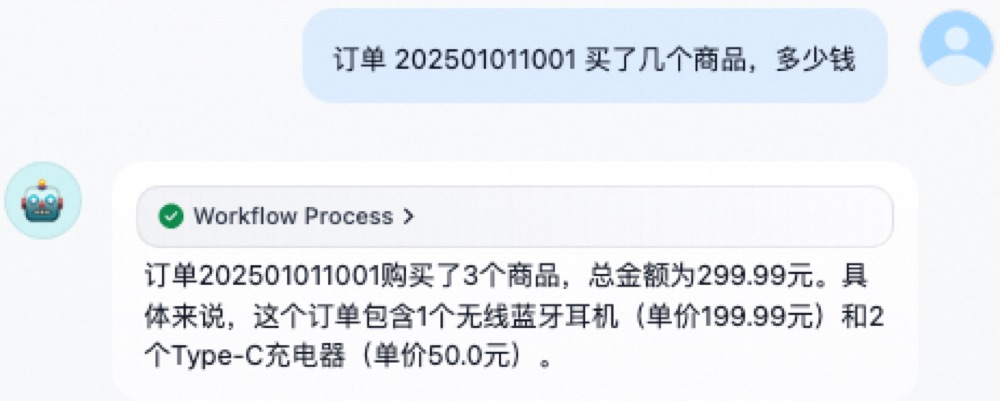
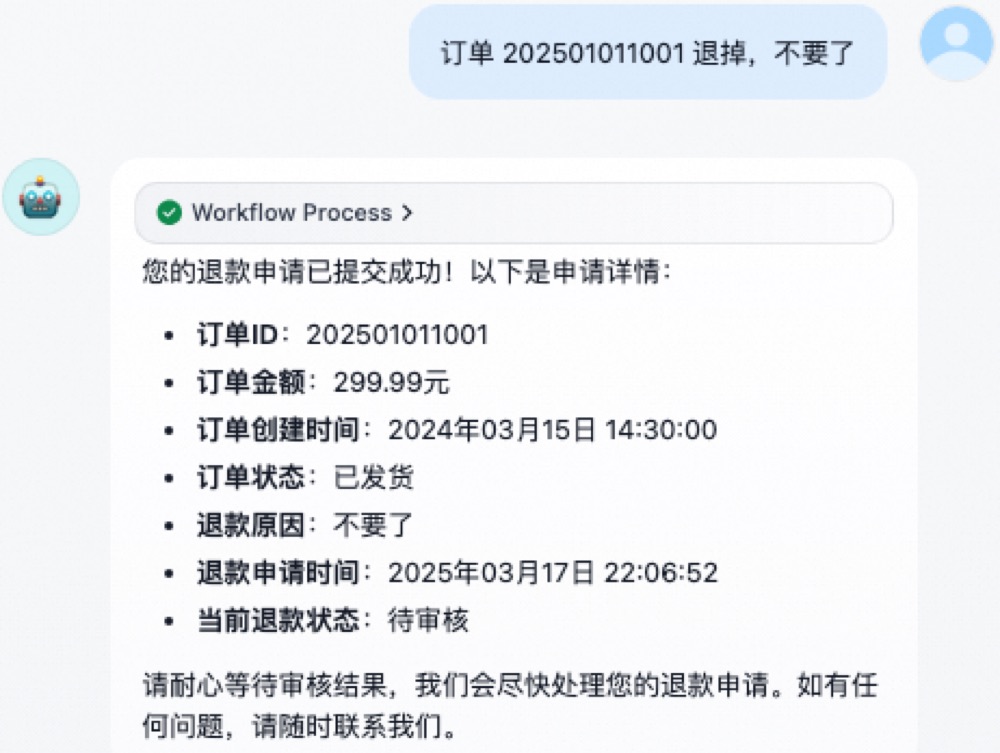
以下问题在调用“查询订单信息”和“创建退款申请”工具后,由大模型进行了推理并作出回复。
FinRobot:基于LLM的金融分析AI Agent
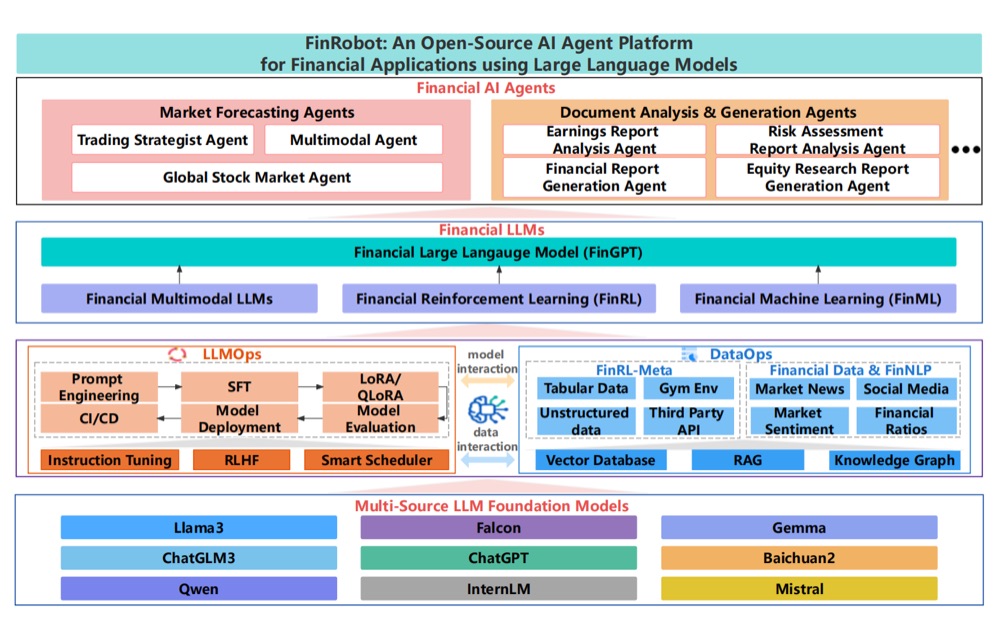
该平台由四个主要层次组成:
金融AI Agent层:通过将复杂的金融问题分解为逻辑序列来形成金融链式思维(CoT)
金融LLM算法层:为特定任务动态配置适当的模型应用策略
LLMOps和DataOps层:通过应用训练/微调技术和使用与任务相关的数据来生成准确的模型
多源LLM基础模型层:整合各种LLM,使上述各层可以直接访问这些模型
背 景
金融分析通常涉及解释市场趋势、预测经济结果和提供投资策略
金融分析是金融决策的前奏,分析以数据为基础
假设将股票领域的分析分为两类:
一类是研究公司并进行估值的基本面分析
另一类是研究市场行为以预测未来价格趋势的技术分析
基于 LLM , AI Agent 已发展出利用这些模型执行一系列复杂功能, 包括规划、记忆管理和工具使用 ,这些功能促进了现实世界中的智能和自主行动。这些能力使 AI Agent 能够执行传统上需要广泛人类干预和专业知识的复杂金融分析和操作。
近期 AI Agent 的应用,如用于交易的 FinAgent 和用于金融决策的 FinMem ,突显了对这些技术执行复杂金融操作的日益依赖。
尽管取得了进展,这些解决方案仍未解决几个关键挑战:
透明度提升: AI Agent 驱动的金融分析平台如何改进决策过程的透明度,以建立用户信任?
全球市场适应: AI Agent 如何有效适应全球股票市场的多语言和多文化差异,确保全面和准确的市场分析?
模型多样性: 依赖单一 LLM 架构(如GPT-4)进行复杂金融分析的局限性是什么,多样化模型架构如何提升性能?
实时数据处理: AI Agent 平台如何高效管理和路由大量金融数据,确保及时和准确的金融分析?
鉴于这些挑战,本文介绍了 FinRobot ,这是一个利用多源 LLM 执行多样化金融任务的创新开源 AI Agent
FinRobot 通过数据处理到策略实施的流程优化金融工作流程,扩大了对高级分析工具的访问,并增强了可扩展性和透明度 。
通过利用多样化 LLM 架构,它定制了解决方案以满足全球市场需求,确保精确适应和性能优化。平台的多源集成架构促进了针对特定任务选择准确的LLM,其实时数据处理管道保证了及时的金融分析
FinRobot 解决了该领域以往的不足:
全面的金融 AI Agent 框架: FinRobot 提供了一个全面的框架,用于开发能够执行从市场预测到金融文档分析的广泛任务的金融 AI Agent 。 值得注意的是, FinRobot 是第一个专注于金融分析的AI Agent平台,标志着AI在金融应用中的重大进步
多源LLM集成: FinRobot 引入了一种新的智能调度机制,允许无缝集成多源LLM,使平台能够利用各种最先进的LLM的优势,并为特定金融任务选择最适合的模型 。这种适应性对于处理全球金融市场的复杂性和多语言数据至关重要。
金融AI的开源平台: 通过采用开源方法 , FinRobot 促进了更广泛的合作,并加速了金融AI社区内的创新 。这种开放性不仅促进了透明度,还允许不断的改进和适应,这在快速发展的金融领域至关重要
相关工作
基于LLM的 AI Agent
由大型语言模型(LLMs)驱动的 AI Agent 是一种能够感知环境、独立决策并执行操作的智能体
近年来,AI的进步导致了基于 LLM 的 AI Agent 在多个领域的广泛应用,显著影响了从创意产业到技术领域的各个方面
例如:
MusicAgen t 增强了音乐创作, MedAgents 改进了医疗诊断,数据分析代理提供了大数据洞察,程序员代理自动化编码任务, ResearchAgent 生成研究创意 。
这些应用展示了LLM的多功能性,并为其在推动金融技术发展中的关键作用奠定了基础
金融 AI Agent
在金融领域,由 AI Agent 驱动的系统如 FinAgent 和 FinMem 利用 LLM 通过实时市场数据来转换交易策略,从而进行知情决策 。 然而,对回测和个股收益等指标的关注往往掩盖了对稳健、面向过程的方法的需求, 有效的交易代理不仅应在统计上表现良好,还应通过自动化从策略执行到订单下达的任务来增强操作工作流程,尽量减少人工干预。这种从性能到过程导向的转变可以导致更可持续和适应性更强的金融技术
开源 AI Agent 框架
开发开源 AI Agent 框架对于普及先进AI技术的访问起到了重要作用。著名的平台和框架如 AutoGPT、AutoGen、MetaGPT、HuggingGPT、ChatDev、Dify、Voyager 通过允许全球开发者社区贡献和完善AI模型,促进了协作性增强和创新。 鉴于对复杂金融工具的需求日益增长,专门针对金融任务的开源框架的出现是必然的
FinRobot :一个 基于LLM 金融任务平台
如图所示, FinRobot 的整体框架分为四个不同的层次 。
每个层次都设计用来处理金融AI的特定方面和应用:
金融AI Agent层
金融 AI Agent 层现在包含了金融链式思维(CoT)提示,增强了复杂分析和决策能力 。
市场预测代理、文档分析代理和交易策略代理利用CoT将金融挑战分解为逻辑步骤,将其高级算法和领域专业知识与不断变化的金融市场动态相结合,提供精确且可操作的洞察。
金融LLM算法层
金融 LLM 算法层配置并使用专门调整的模型,针对特定领域和全球市场分析进行优化。该层使用 FinGPT 以及多源 LLM
例如用于美国市场的Llama系列和用于国内市场的ChatGLM,这些模型分别针对区域特性进行了优化。
LLMOps 和 DataOps 层
LLMOps层实施多源集成策略,选择最适合特定金融任务的 LLM ,使用一系列最先进的模型 。
最初部署的是通用 LLM ;如果性能不理想,系统会动态切换到微调的 LLM 以提高效果。
这种自适应方法确保了针对各种金融情景的定制解决方案,提升了平台的整体性能
同时,DataOps层管理实时数据处理,这对于快速响应市场至关重要 。这种双层配置增强了 FinRobot 在动态市场条件下提供及时和准确金融洞察的能力。
多源LLM基础模型层
该基础层支持各种通用和专用LLM的即插即用功能。它构成了平台的骨干,确保所有模型都是最新的、经过优化的,并始终与金融技术和数据标准的最新进展保持一致
金融 AI Agent 层
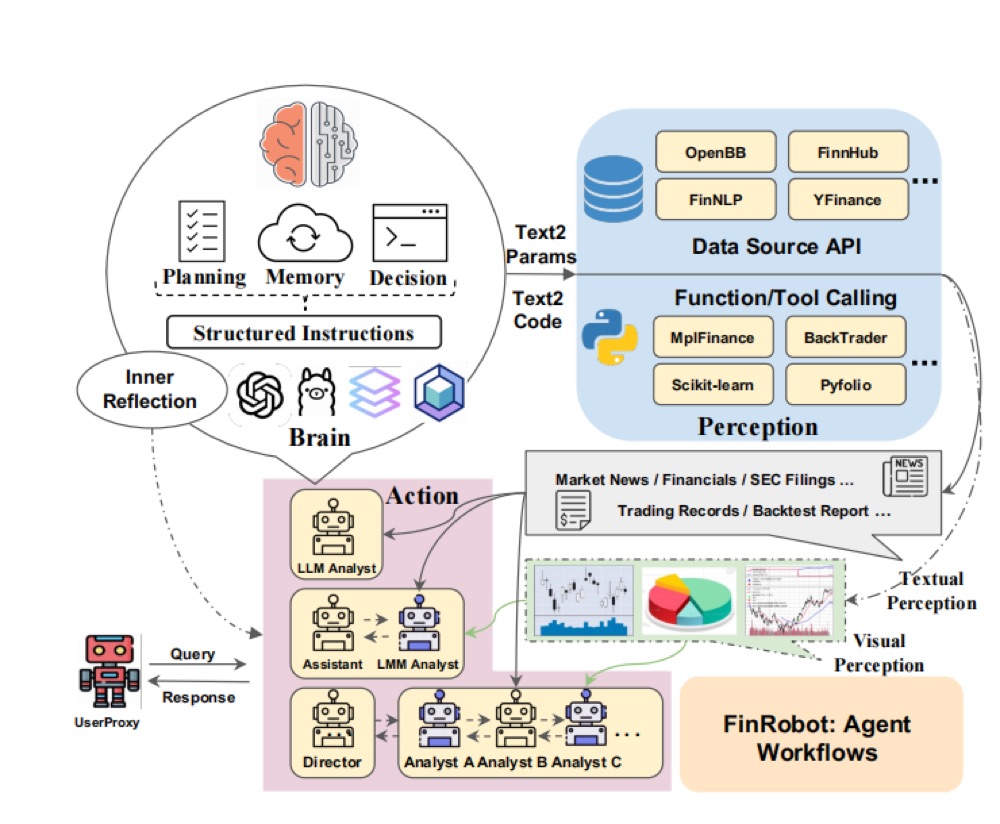
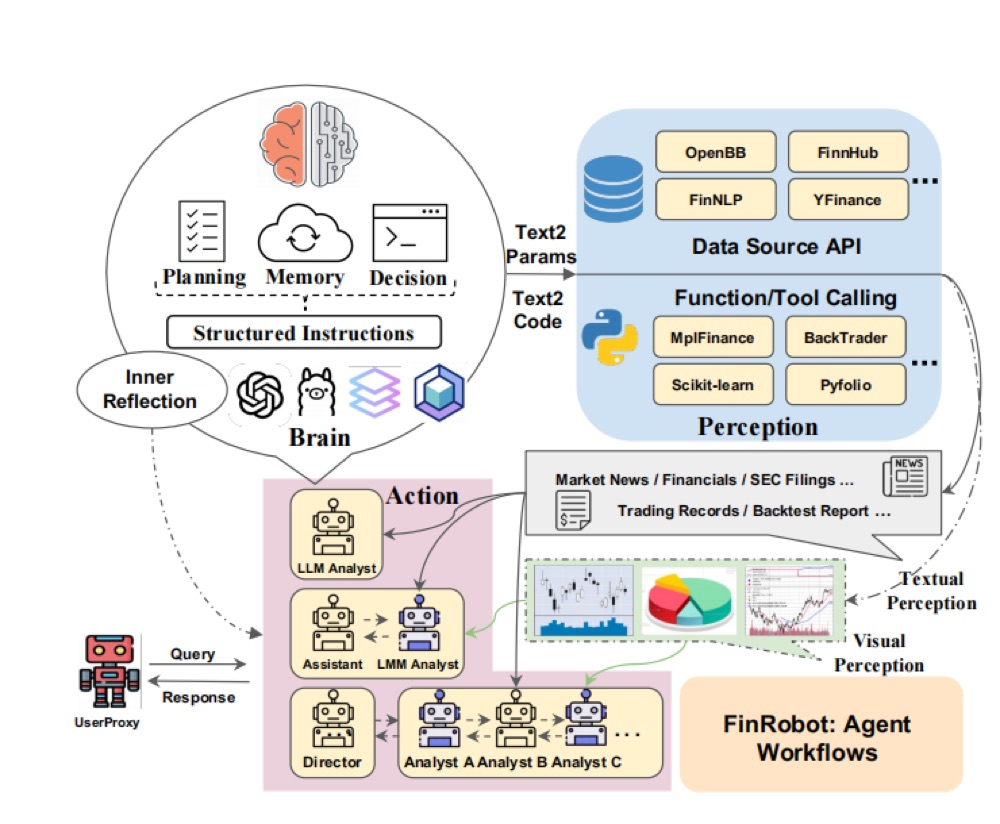
如图所示, FinRobot 的金融 AI Agent 层由特定领域的 AI Agent 组成, 通过先进的数据感知、认知处理和动态行动执行来增强金融分析:
感知模块 : 此模块从市场信息、新闻和经济指标中捕获和解释多模态金融数据,使用复杂技术将数据结构化以进行全面分析。
核心处理单元 : 作为核心处理单元,该模块使用 LLMs 从感知模块接收数据,并利用金融链式思维(CoT)流程生成结构化指令。
行动模块 : 此模块执行核心处理单元的指令,应用工具将分析见解转化为可操作的结果。行动包括交易、投资组合调整、生成报告或发送警报,从而积极影响金融环境。
多Agent工作流
多Agent 工作流系统允许具有不同角色和职责的多个代理协同处理复杂任务 。当处理复杂的金融数据集并确保高标准的分析精度和深度时,部署 多Agent 工作流系统是有利的。
该系统包括多个专门角色,协同工作以处理、分析和从多样化的金融数据源中得出可操作的见解:
项目主管
作为项目的战略领导者,项目主管在金融分析环境中监督工作流的所有方面。此角色负责优先处理金融任务、分配资源和协调团队努力,以优化分析时间和结果。
助手
在金融分析中,助手专注于初始数据管理任务,如收集、处理和进行初步分析金融数据,并促进代理之间的沟通。此角色通过准备数据集、维护数据库和执行基本金融计算和可视化来支持更专业的分析师。此基础工作使其他分析师能够专注于金融分析的更复杂和解释性方面。
LLM 分析师
LLM 分析师使用 LLMs 的先进计算技术分析金融文本,如报告、文件和新闻文章 。此角色对于从定性数据中提取详细见解、进行情感分析和预测市场趋势至关重要。通过将这些见解与定量数据结合, LLM 分析师提供全面的金融健康和市场状况评估,增强决策过程。
金融分析师
在 LLM 分析师的指导下,金融分析师在投资组合管理、风险评估和市场分析等各个领域进行详细的定量数据分析。利用统计工具和金融模型,他们解释数据、评估投资机会并制定风险缓解策略。他们的专业分析显著贡献于制定合理的金融策略和提供明智的建议。
这些角色在多代理工作流中的协作实现了对金融分析的整体方法,涵盖宏观经济状况和具体金融指标。这种结构化但灵活的方法确保了对金融数据的彻底探索和解释,导致明智的战略决策
利用LLMs进行工具使用
通过Text2Params的API交互
此方法将自然语言查询转化为API请求,有效结合了生成函数调用和形成API调用的能力。在这种方法中, LLM 首先解析文本以识别和提取关键参数,然后使用这些参数动态生成函数调用或直接编译成与金融软件或数据库交互的API请求。 此方法特别适用于执行预定义操作和从外部服务获取或操作金融数据
通过Text2Code的代码编译
对于需要动态解决方案生成的更复杂的金融任务, LLMs 可以使用Text2Code技术即时编写和编译代码 。 这种能力对于根据用户查询的独特市场条件或金融场景开发定制算法至关重要
金融 LLM 算法层
这一层包含了专门设计的高级AI算法,以应对金融领域内的各种需求,提升平台在一系列金融应用中的能力
金融大型语言模型(FinGPT)
FinGPT 是一种领域特定的 LLM ,经过精心设计,旨在提升在金融环境中的自然语言理解能力。 这些模型能够熟练地分析和解释金融叙述,从复杂的文档(如年度报告)和实时金融新闻中提取关键数据,从而支持增强的决策过程 。
FinGPT 模型主要通过监督微调金融领域内的成对“指令-响应”数据在开源大型语言模型上开发完成。
这个过程通过最小化以下负对数似然来实现:
$$ \mathcal{L}{\text{CausalLM}} = -\sum{t=1}^{T} \log P(w_t|w_1, w_2, \ldots, w_{t-1}; \theta) $$
其中, $$ T $$ 是输入序列的长度, $$ w_i $$ 代表序列中第 $$ i $$ 个词元, $$ \theta $$ 表示模型参数, $$P(w_i|w_1, w_2, \ldots, w_{i-1} $$ ; \theta) 表示在给定前序词元 $$ x_1 $$ , $$\ldots, x_{i-1} $$ 的条件下预测目标词元 $$x_i $$ 的条件概率。通过优化这一目标函数,模型学习最大化生成预期响应的概率,给定金融任务指令。
金融强化学习(FinRL)
FinRL 通过使用集成深度强化学习算法来优化交易策略,分析历史和实时市场数据 。这种动态适应性有助于在最大化金融回报的同时最小化风险,使得股票投资组合分配成为这一方法的理想应用。
在 FinRL 中,股票投资组合分配被建模为一个马尔可夫决策过程(MDP)
在任意时间 $$ t $$ ,状态 $$s_t \in \mathcal{S} $$ 的代理基于策略 $$ \pi_{\theta}(s_t) $$ 选择一个动作 $$ a_t \in \mathcal{A} $$ 。这个动作导致新的状态 $$ s_{t+1} $$ 并获得回报 $$ r(s_t, a_t, s_{t+1}) $$
目标是优化这一策略:
$$ \pi_{\theta}^{*} = \arg\max_{\theta} J(\pi_{\theta}) $$
其中
$$ J(\pi_{\theta}) = \mathbb{E} \left[ \sum_{t=0}^{T} \gamma^t r(s_t, a_t, s_{t+1}) \right] $$
其中 $$ \gamma \in (0, 1] $$ 是折扣因子
金融机器学习(FinML)
FinML 利用多样的机器学习技术,从回归到高级神经网络,来提升金融预测分析 。这些算法在预测市场趋势、消费者行为、信用风险和其他关键金融指标中发挥着重要作用,从而促进明智的决策。 FinML 使用的一个关键指标是对数回报,其计算公式如下:
$$ r_{T+f, i} = \log \left( \frac{S_{T+f, i}}{S_{T, i}} \right), \quad i = 1, \ldots, n_T $$
其中 $$ r $$ 表示对数回报, $$ S $$ 是股票价格, $$ n_T $$ 代表在时间 $$ T $$ 监测的公司数量, $$ f $$ 是预测期。这一指标对于评估投资绩效和制定金融策略至关重要。
金融多模态LLMs
金融文档经常包含多种数据类型,除了文本内容外,还有图表和表格。这些额外的模态提供了丰富的、互补的见解,显著提升了分析的深度。为了有效整合和利用这些多样化的数据类型,开发了金融多模态 LLMs , 专门用于处理和综合来自多个模态的信息,从而提供全面和细致的金融文档理解
金融多模态 LLM 的整合过程的数学表示如下:
$$ F(x_t, x_g, x_h) = L(T(x_t), G(x_v), H(x_l)) $$
其中 $$ F(x_t, x_g, x_h) $$ 表示模型的输出。这里, $$ x_t, x_g, x_h $$ 分别表示文本、图形和表格数据的输入。函数 $$ T $$ 、 $$G $$ 和 $$H $$ 将这些输入转化为统一的嵌入空间。然后综合这些嵌入以生成连贯且可靠的输出,从而提高金融分析的准确性和可靠性。
LLMOps 层
LLMOps 层设计高度模块化和可插拔,能够快速集成和动态替换 LLMs ,以应对不断发展的技术进步和金融市场需求 。该层促进无缝的模型集成,并包含严格评估和选择最适合特定金融任务的模型的机制。这些能力对于保持操作效率和确保解决方案适应多样化的金融场景至关重要
智能调度器
如图所示:
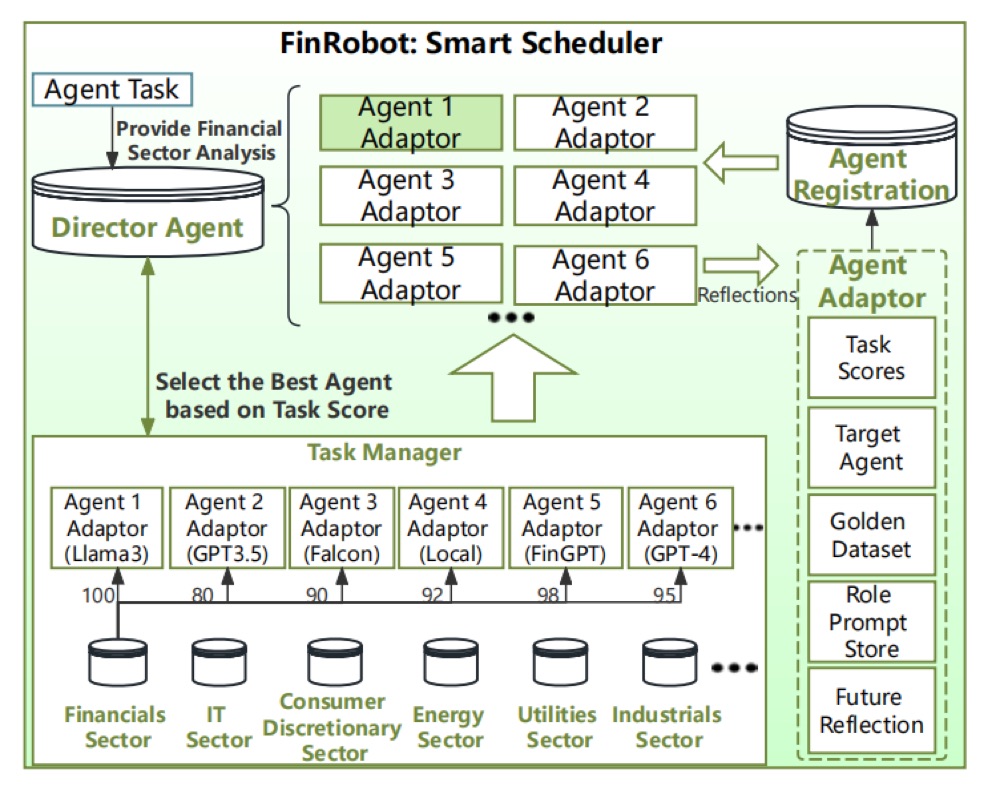
智能调度器在确保模型多样性和优化每项任务的最合适LLM集成和选择方面起着核心作用
智能调度器架构
智能调度器优化代理间的任务分配,包含以下组件:
主管代理 :该组件协调任务分配过程,确保任务根据性能指标和特定任务的适用性分配给代理
代理注册 :管理系统内代理的注册和可用性跟踪,促进高效的任务分配过程
代理适配器 :将代理功能定制为特定任务,提升其在整体系统中的性能和集成
任务管理器 :管理和存储基于各种金融任务的不同通用和微调LLM代理,定期更新以确保相关性和有效性
智能调度器初始化过程
初始化过程简化为有效建立代理操作的坚实基础:
黄金数据集创建 :用行业特定数据填充
提示库填充 :为各种代理填充定制提示
任务评分填充 :调用适配器评估响应与最佳答案的对比,将评分存储在任务评分数据库中
智能调度器的运行过程
操作阶段遵循以下顺序:
任务启动 :用户启动任务
主管代理角色 :评估任务输入,根据性能和相关性对代理进行排名
代理选择和任务路由 :将任务路由到排名最高的代理
工作流进展和自我评估 :任务完成后,代理进行自我评估,结果存储在未来反思存储中
工作流完成和评估 :在工作流结束时,代理评估结果并提供反馈以持续改进
评分指标
智能调度器的评分过程涉及几个关键步骤,以评估不同LLMs在特定任务应用中的表现:
数据收集 :收集各种LLM在多个评估任务中的性能数据
归一化 :归一化每个评估任务的结果,使其在0到1之间缩放
权重分配 :根据行业标准或专家意见为不同的评估维度分配权重
综合评分计算 :将归一化得分乘以各自的权重并求和,以得出任务评分
结果分析 :分析得分以排名和评估LLMs,提供性能比较和选择建议
这种增强的结构不仅提升了金融AI Agent的操作效率,还支持多样化金融任务的可扩展、动态管理,显著提升了系统在实时金融环境中管理复杂、多代理场景的能力
DataOps 层
DataOps 层管理金融分析所需的大量多样化数据集,包括公共表格数据和专有市场情绪数据
此层对于确保所有输入AI处理管道的数据具有高质量并能代表当前市场状况至关重要。有效的数据管理是AI模型准确可靠表现的基础, 因此, DataOps 层采用先进的数据处理技术来准备和传递这些输入 。
通过优化数据的可访问性和质量, DataOps 层支持 FinRobot 平台的整体效能,使其能够基于扎实的数据驱动见解进行复杂而精确的金融决策
检索增强生成
检索增强生成(RAG)是一项关键技术,已集成在 FinGPT 中,结合了上下文检索机制和 LLMs 的优势,以优化语言生成任务
LLMOps 和 DataOps 层构成了 FinRobot 的操作能力的支柱,确保平台在技术创新的前沿,同时提供可靠和有效的金融AI服务
多源 LLM 基础模型层
多源 LLM 基础模型层为 FinRobot 配备了先进的能力,以管理和整合多种大型语言模型(LLMs),这是适应全球金融市场动态需求的关键
此层的主要特点包括:
即插即用功能
支持通用和专业 LLM 的无缝集成和更新,确保平台能够适应并保持与金融技术进步同步
模型多样性和评估
集成参数范围从70亿到720亿的 LLM ,严格评估其在特定金融任务中的有效性,根据准确性和适应性等性能指标进行最佳模型选择
全球市场兼容性
支持多语言模型集成,增强平台分析和处理多样化金融数据的能力,这对于全球市场运营至关重要
金融链式思维(CoT)提示
链式思维(CoT)提示技术通过结构化提示,促进AI模型内的逐步推理过程,类似于人类的问题解决策略。此方法显著提高了在复杂推理任务(如数学和常识推理)中的性能,鼓励模型表达中间推理步骤,最终得出答案。这一方法不仅提高了准确性,还增强了决策过程的可解释性和透明度
金融链式思维的概念
金融链式思维提示将CoT技术应用于AI驱动的金融分析,集成了先进的认知处理技术以优化决策能力
它通过引导AI模型进行逻辑、顺序的推理过程,模拟金融专业人员解决复杂金融问题的思维过程
这种方法将复杂的金融场景分解为较小的、可管理的部分,分析每个部分,并综合这些发现形成结论或建议,在分析链中模拟了人类的推理,在需要深入分析思考的任务中特别有价值,例如估值、投资策略制定、市场趋势分析和风险评估
金融链式思维的实施
金融链式思维(CoT)提示在证券分析中标志着一种变革,利用 GPT-4 等 LLMs 增强了传统分析工具在各个领域的能力
详细案例研究,展示了这一方法的实际应用和好处 :
金融分析 :FinRobot超越了基本数据列举和比率计算。通过使用LLMs进行财务报表分析,它在行业竞争者之间以及与公司历史表现进行比较分析。这种全面的方法提供了对公司业务环境和财务指标逻辑基础的深刻见解,尤其是通过标准化财务比率识别异常,提升了超越人类能力的财务见解的准确性。
业务特定分析 :利用检索增强生成(RAG),FinRobot革新了收集公司产品和服务数据的过程,补充了财务报告中的信息。通过利用网络的丰富资源,FinRobot加深了对公司产品线、渠道和区域趋势、成本结构、供应链动态和研发转化的全面理解。
市场分析 :FinRobot抽象现实世界的金融背景,利用金融比率、市场数据(包括股价趋势和K线图)、市场新闻情绪以及在线获取的替代数据的组合。通过使用LLMs,FinRobot模拟市场参与者对背景变化的决策过程,从而对公司的股价轨迹和估值进行全面评估。FinRobot提供细致的投资评估,针对最佳投资时机和合适的金融工具提供战略指导,确保在考虑各种时间范围、结构和风险阈值时制定稳健、明智的投资策略。
估值分析 :FinRobot综合其对财务比率、市场数据(包括股价趋势和K线图)、市场新闻情绪以及在线收集的替代数据的全面分析。通过使用LLMs,FinRobot利用从这些多样来源得出的见解评估公司的股价轨迹和估值。这种方法使FinRobot能够在各种时间范围、结构和风险阈值下提供细致的投资评估,针对最佳投资时机和合适的金融工具提供战略指导,从而确保制定稳健、明智的投资策略。
金融链式思维提示的优势
尽管现有的数据提供商如 Bloomberg、FactSet、CapitalIQ、Refinitiv Eikon 依赖于基础的、通用的模板进行数据提取,但他们不时忽视与业务本质密切相关的关键运营指标和定性信息
手动分析可能耗时且偶尔重复,而现有的自动化工具有时无法从年报等非结构化来源提取原始数据。尽管这些平台充斥着大量信息,但提取必要的信息及其随后的分析仍需投资专业人员的专业知识。
通过链式思维提示, FinRobot 在 AI Agent 平台中占据了独特的地位,通过模拟人类在金融分析中的认知过程,超越了对纯数字计算的传统依赖。
利用 LLMs 解构并分析金融专业人员在审查业务数据时使用的方法。 这一方法揭示了依赖于全面理解公司业务基础的实用分析,这些基础通过详细的会计数据、定制的行业特定指标和定性信息反映出来 。
这种方法克服了上述限制,因为:
由于 LLMs 的生成性质,它不依赖于固定模板
错误检查嵌入在提示层中,避免了误分类
通过在推理中编码投资逻辑,它简化了人工劳动
它能够从复杂和非结构化数据格式(如财报电话会议记录)中提取相关的历史数据和定性信息
由于其多层结构,它为解释每个记录和推导值的来源和推导过程提供了更强的基础
它具有高度的适应性和演化性,因为 LLMs 可以通过监督微调和指令微调进行改进
市场模拟:超越分析师模拟
为了扩展市场模拟的概念并探索其可能性,可以将GPT模仿人类分析过程的能力视为模拟更广泛市场动态的门户 。市场模拟超越了纯粹的数字分析,通过包含类似人类的推理过程,在金融背景中体现多个角色和情景。 这种模拟可以涵盖各种市场参与者,其决策受到不断变化的数据输入影响——从财务报表、报告、市场数据和经济指标到全球新闻
这一方法的核心涉及构建一个详细的模拟环境,其中这些生成代理代表不同的市场参与者相互作用 。每个代理的决策过程将由数据驱动的提示引导,模仿人类分析师可能采取的认知步骤。这包括解释复杂的市场信号并实时对新信息作出反应,这可以通过先进的机器学习模型和强化学习技术来促进。
通过利用 LLMs ,可以理论上将这些决策框架编码到代理中,使他们能够执行需要深入理解市场定量和定性方面的任务。这不仅会模拟个体交易决策,还会模拟由多个决策者的互动所产生的更广泛的市场动态。利用这种技术创建一个虚拟市场环境,在其中可以测试和分析假设情景,可能会为市场行为和策略开发提供宝贵的见解。
这种模拟的详细框架可能包括:
定义不同市场参与者的角色和行为(例如,机构投资者、散户投资者、做市商)
为每个参与者实现各种数据输入和决策模型
在不同时间范围和不同条件下模拟市场互动,以评估潜在结果和策略
利用强化学习,根据模拟中观察到的表现来优化代理的策略
演示应用和实操教程
市场预测器
市场预测器是一组AI Agent,旨在综合最新的市场新闻和财务数据,提供对公司最新成就和潜在问题的全面见解,以及对股票价格走势的预测。作为一个初级机器人顾问,市场预测器在AI驱动的金融咨询方面体现了一个显著的飞跃
说明:您是一位经验丰富的股票市场分析师。您的任务是根据公司最近几周的相关新闻和季度财务报告,列出公司的正面发展和潜在问题,然后结合您对整体金融经济市场的判断,提供对公司下周股价变化的预测和分析。您的答案格式应如下:
[Positive development]:
1. …
[Potential concerns]:
2. …
信息:
a. 公司简介
b. 股价变化
c. 最近的新闻信息
d. 最近的基本财务数据
说明:基于2024年4月19日之前的所有信息,首先分析AAPL的正面发展和潜在问题,分别提出2-4个最重要的因素并保持简洁。然后预测AAPL在下周(2024年4月22日至2024年4月26日)的价格变化。提供一个总结分析以支持您的预测。
数 据
NVDA的预测(2024年1月29日)
[Positive Developments]:
股票价格 :NVDA的股价在过去几周持续上涨,表明投资者情绪强劲。
新闻 :公司CEO黄仁勋对AI的未来以及Nvidia在其中的角色表示乐观,这可能会增强投资者信心。
新闻 :公司受到了 Zacks.com 用户的关注,表明市场表现强劲。
基本财务数据 :公司拥有强劲的资产负债表,毛利率健康,企业价值(EV)较高。
[Potential Concerns]:
基本财务数据 :公司的长期债务占总资产和债务占总资本比率相对较高,表明存在潜在的财务不稳定风险。
基本财务数据 :公司的市盈率(PE)和净债务占总权益比率较高,表明估值高且存在潜在的财务风险。
基本财务数据 :公司的速动比率相对较低,表明存在潜在的流动性风险。
[Prediction & Analysis]:
预测 :上涨0-1%
分析 :尽管存在一些潜在问题,但NVDA的正面发展非常显著。公司的强劲资产负债表和不断上涨的股价表明投资者情绪强劲。CEO的乐观展望也表明未来前景积极。然而,较高的长期债务占总资产和债务占总资本比率是一个值得关注的问题。这些较高的比率可能会增加公司的财务风险并影响其流动性。
市场预测器站在全球市场的交汇点,利用多种数据源收集信息并做出预测决策。具体而言,市场预测器收集关于目标市场(包括美国股市、中国股市、加密货币市场及其他可能扩展的市场)的多方面公司信息,如最近新闻、最新基本财务数据和股价。
模 型
这个AI Agent由经过微调的FinGPT预测器驱动,使用Llama-2-7b-chat-hf与LoRA结合,利用最近一年的DOW 30(道琼斯工业平均指数30家公司)数据预测美国市场,以及SSE 50(上海证券交易所50家公司)数据预测中国市场,以确保对这些主要股票的精确预测,并展示了在各种股票符号上的强大泛化能力。此外,本论文遵循金融多任务指令微调范式,将基础模型的能力与市场预测器的具体功能对齐。
提 示
按照多任务指令微调框架,市场预测器遵循复杂的提示格式。具体而言,市场预测器收集多方面的公司信息,然后进行提示工程,格式化指令提示,结构为“任务指令和公司信息(公司概述+近期股价+近期新闻+最新基本财务数据)”
贵州茅台的预测(2024年1月28日)
[积极发展]:
新闻 :贵州茅台的购买率持续上涨,表明市场对茅台的需求持续增长。
新闻 :公司的新闻发布,如“美茅台美世界”2024全球品牌文化活动,表明公司继续追求国际化发展,并且将继续以“美”的国际表达,坚持追求美,实现看好未来的发展。
基本财务数据 :茅台的营业总收入同比增长率达到了19.80%,表明公司的经营状况良好,具有稳定的盈利能力。
基本财务数据 :茅台的流动比率和速动比率都相对较高,表明公司的资金流动性较好,可以更好地应对市场的压力。
[潜在担忧]:
基本财务数据 :茅台的资产负债率达到了17.98%,显示公司的负债压力较大,可能会对公司的盈利能力产生影响。
新闻 :公司未来可能面临的市场竞争压力可能会增加,如果公司无法继续提供高质量的产品和服务,可能会受到市场反应。
股票价格 :茅台的购买率上涨,可能会导致市场价格偏高,可能会影响到公司的股价。
[预测和分析]:
预测涨跌幅 :上涨0-1%
总结分析 :虽然贵州茅台的资产负债率较高,但公司的经营状况良好,营业总收入同比增长率达到了19.80%,显示公司在市场的需求和竞争中具有稳定的盈利能力。考虑到茅台的购买率持续上涨,表明市场对茅台的需求持续增长,可能会对公司的股价产生积极影响。同时,公司的新闻发布,如“美茅台美世界”2024全球品牌文化活动,表明公司继续追求国际化发展,可能会带来未来的发展机会。因此,预计茅台的股价在下一周将上涨0-1%。
样本预测
提供了两个主要股票(美国市场的Nvidia和中国市场的贵州茅台)的样本答案,展示了市场预测器在综合和提供从多种信息来源中获取的宝贵见解方面的熟练程度。 此外,市场预测器提供了关于股票未来走势的建议,强调了其基于分析数据提供可操作性指导的能力
文档分析与生成
文档分析与生成应用代表了AI Agent和大型语言模型(LLMs)在金融文档管理和报告创建领域的突破性应用。此应用利用AI的力量,自动进行深度金融文档分析并生成详细的、有洞察力的报告。
文档分析
集成了先进 LLMs 的 AI Agent 被用来筛选大量的金融文档,如年报、SEC文件和财报电话会议记录。 这些代理能够提取关键信息,识别主要财务指标,并突出需要仔细检查的趋势和差异 。这些 AI Agent 理解和处理复杂金融术语和上下文的能力,将大量非结构化数据转化为结构化的、可操作的见解。
报告生成
在分析阶段之后,使用同一代理生成综合性财务报告。利用 LLMs 的能力,系统生成连贯、清晰且详细的文档, 涵盖金融分析的各个方面,包括业绩评估、市场比较和前瞻性财务预测 。每份报告都精心编写,保持专业的语调和格式,符合顶级金融分析师的质量和深度预期。为了提供实用见解,附录中包括了由 FinRobot 生成的股票研究报告,展示了其应用和效果。
结论
FinRobot 通过在一个开源平台中集成多源大型语言模型(LLMs),革新了金融分析,提升了金融操作的可访问性、效率和透明度 。这个创新平台通过多层架构处理全球市场的复杂性,支持实时数据处理和多样化模型集成,使复杂的金融工具可以被更广泛的受众使用。
基于Agent搭建ai论文写作程序
本程序能够自动化完成从规划、研究、撰写到修改的整个论文创作流程。基于LangGraph和LangChain框架构建,利用大型语言模型和搜索工具协同工作,形成了一个完整的论文写作流水线。
核心功能分析
计划生成功能 (plan_node)
这个 node 将接收状态,然后创建一个消息列表。其中一个将是 PLAN_PROMPT ,那将是 SystemMessage 。然后创建 HumanMessage ,传入我们要做的 task 。然后我们将得到一个 response ,我们将取得这个消息的信息将其设置为 plan 。该函数负责基于用户输入的任务创建论文大纲。它通过向语言模型发送系统提示和用户任务,获取一个结构化的论文大纲,这作为后续写作的指导框架。
def plan_node(state: AgentState):
"""创建论文大纲"""
messages = [
SystemMessage(content=PLAN_PROMPT),
HumanMessage(content=state["task"])
]
response = model.invoke(messages)
return {"plan": response.content}
研究规划功能 (research_plan_node)
这个 node 是接收 plan 并进行一些 research 。首先会生成一些 query ,这基本上是在说,我们将要调用它的响应将是我们之前调用的pydantic object,其中包含查询列表。所以我们将在消息列表上调用invoke。我们拿到了 RESEARCH_PLAN_PROMPT ,然后创建 HumanMessage ,传入我们要做的 task 。我们将会获取我们当前文档的列表,我们将用他们来撰写这篇essay。然后我们将循环遍历 query ,并在travily中进行搜索,我们取得 result 后,会将其附加到 content 中。这确保了AI在写作过程中能够基于最新、相关的外部信息进行创作,而不仅仅依赖于模型的内置知识。
def research_plan_node(state: AgentState):
"""基于任务生成研究查询并收集信息"""
queries = model.with_structured_output(Queries).invoke([
SystemMessage(content=RESEARCH_PLAN_PROMPT),
HumanMessage(content=state["task"])
])
content = state.get('content', [])
for q in queries.queries:
response = tavily.search(query=q, max_results=2)
for r in response['results']:
content.append(r['content'])
return {"content": content}
内容生成功能 (generation_node)
对于生成节点,我们要做的第一件事是准备内容。然后我们将创建 user_message ,我们将 plan 和 task 结合起来。然后创建一个消息列表,首先是一个带有写作提示的 SystemMessage 我们在其中格式化 content 。我们把信息传递给消息队列,得到一个响应。然后我们会更新修订号,这可以跟踪我们做了多少次修订,以便系统可以跟踪当前处于写作流程的哪个阶段。
def generation_node(state: AgentState):
"""基于计划和研究生成或修改论文草稿"""
content = "\n\n".join(state['content'] or [])
user_message = HumanMessage(
content=f"{state['task']}\n\n Here is my plan:\n\n {state['plan']}")
messages = [
SystemMessage(
content=WRITER_PROMPT.format(content=content)
),
user_message
]
response = model.invoke(messages)
return {
"draft": response.content,
"revision_number": state.get("revision_number", 1) + 1
}
反思评价功能 (reflection_node)
生成之后,我们现在需要一个反思节点。反思节点会将反思提示作为系统提示,然后会提取 draft 。该函数模拟了一个教师角色,对生成的论文草稿进行评价和批评。这种自我反思机制使AI能够识别当前论文的不足之处,并为下一轮修改提供指导。
def reflection_node(state: AgentState):
"""为草稿生成批评和建议"""
messages = [
SystemMessage(content=REFLECTION_PROMPT),
HumanMessage(content=state["draft"])
]
response = model.invoke(messages)
return {"critique": response.content}
批评研究功能 (research_critique_node)
通过 with_structured_output(Queries) 方法将模型输出强制转换为预定义的 Queries 结构体,确保输出格式规范。然后,系统将批评内容作为输入,让AI分析论文的弱点并生成针对性查询。它包含完善的错误处理和回退机制,确保即使查询生成失败,系统也能继续运行。
def research_critique_node(state: AgentState):
"""基于批评进行研究以解决弱点"""
try:
尝试获取结构化输出
queries = model.with_structured_output(Queries).invoke([
SystemMessage(content=RESEARCH_CRITIQUE_PROMPT),
HumanMessage(content=state["critique"])
])
检查queries是否有效
if queries is None or not hasattr(queries, 'queries') or not queries.queries:
创建基于文章主题的默认查询
print("警告: 结构化输出生成失败,使用默认查询")
default_queries = [
f"{state['task']} statistics",
f"{state['task']} comparison",
f"{state['task']} examples"
]
content = state.get('content', [])
使用默认查询
for q in default_queries:
response = tavily.search(query=q, max_results=2)
for r in response['results']:
content.append(r['content'])
return {"content": content}
如果queries结构正确,按原计划继续
content = state.get('content', [])
for q in queries.queries:
response = tavily.search(query=q, max_results=2)
for r in response['results']:
content.append(r['content'])
return {"content": content}
except Exception as e:
记录错误
print(f"research_critique_node中出现错误: {e}")
return {"content": state.get('content', [])}
决策控制功能 (should_continue)
这将查看修订号,如果大于最大修订次数,我们将结束,否则返回 "reflect" 继续反思。注意这是在生成步骤后的操作,我们要么完成,要么进入评论循环。
def should_continue(state):
"""决定是否继续修改或结束"""
if state["revision_number"] > state["max_revisions"]:
return END
return "reflect"
LangGraph的建立
这在之前的文章中有提及,感兴趣的小伙伴可以去拿章看看什么是langgraph
builder = StateGraph(AgentState)
builder.add_node("planner", plan_node)
builder.add_node("generate", generation_node)
builder.add_node("reflect", reflection_node)
builder.add_node("research_plan", research_plan_node)
builder.add_node("research_critique", research_critique_node)
builder.set_entry_point("planner") # 设置一个入口
条件边
builder.add_conditional_edges(
"generate",
should_continue,
{END: END, "reflect": "reflect"}
)
builder.add_edge("planner", "research_plan")
builder.add_edge("research_plan", "generate")
builder.add_edge("reflect", "research_critique")
builder.add_edge("research_critique", "generate")
工作流构建函数定义了整个论文写作的流程图,通过设置各个功能节点之间的连接关系,形成了一个完整的闭环系统:
从计划节点开始
进行初始研究
生成初稿
对初稿进行反思评价
基于评价进行针对性研究
修改论文
根据修订次数决定是否继续循环或结束
完整执行功能
thread = {"configurable": {"thread_id": "1"}}
with SqliteSaver.from_conn_string(":memory:") as checkpointer:
graph = builder.compile(
checkpointer=checkpointer,
interrupt_after=['planner', 'generate', 'reflect', 'research_plan', 'research_critique']
)
for s in graph.stream({
'task': "What different between Langchain and langsmith?",
"max_revisions": 2,
"revision_number": 1
}, thread):
print(s)
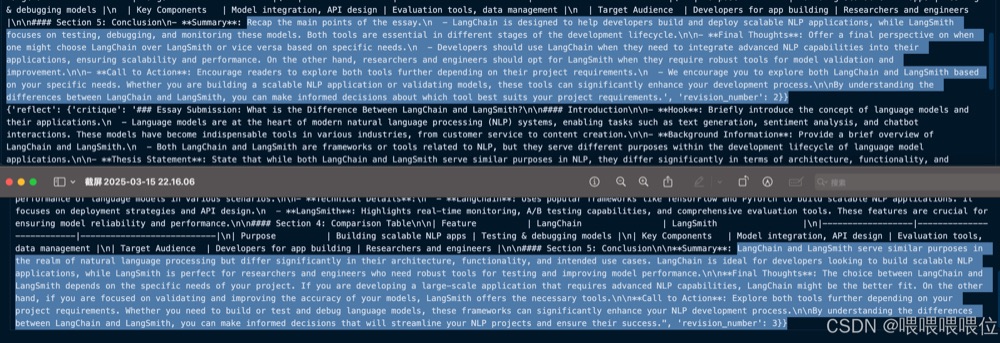
部分测试结果
基于Agent的数据分析实战项目
一、数据分析智能体核心架构
1.1 整体架构设计
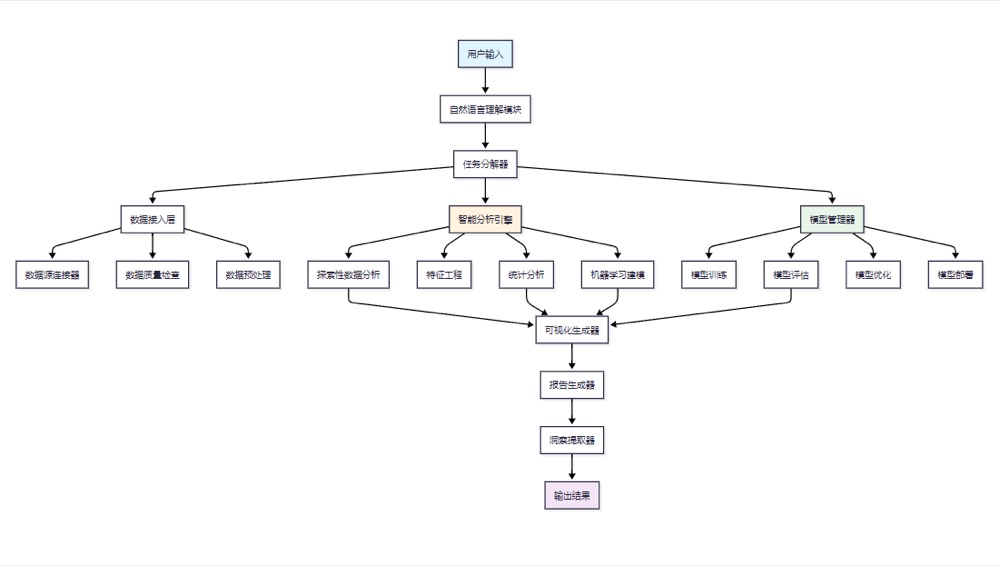
数据分析智能体的核心架构采用模块化设计,包含 数据接入、智能分析、模型管理和输出呈现 四个主要层次。
1.2 核心模块实现
import pandas as pd
import numpy as np
from typing import Dict, List, Any, Optional
from dataclasses import dataclass
import logging
@dataclass
class AnalysisTask:
"""数据分析任务定义"""
task_id: str
task_type: str # 'exploration', 'modeling', 'prediction', 'monitoring'
data_source: str
requirements: Dict[str, Any]
priority: int = 1
class DataAnalysisAgent:
"""数据分析智能体核心类"""
def __init__(self, config: Dict[str, Any]):
self.config = config
self.logger = logging.getLogger(__name__)
self.data_processor = DataProcessor()
self.model_manager = ModelManager()
self.visualization_engine = VisualizationEngine()
self.report_generator = ReportGenerator()
async def process_task(self, task: AnalysisTask) -> Dict[str, Any]:
"""处理数据分析任务的主要入口"""
try:
1. 数据加载和预处理
data = await self._load_and_preprocess_data(task.data_source)
2. 根据任务类型执行相应分析
if task.task_type == 'exploration':
results = await self._perform_eda(data, task.requirements)
elif task.task_type == 'modeling':
results = await self._build_model(data, task.requirements)
elif task.task_type == 'prediction':
results = await self._make_predictions(data, task.requirements)
elif task.task_type == 'monitoring':
results = await self._monitor_metrics(data, task.requirements)
else:
raise ValueError(f"不支持的任务类型: {task.task_type}")
3. 生成报告和洞察
report = await self._generate_report(results, task)
return {
'task_id': task.task_id,
'status': 'completed',
'results': results,
'report': report,
'insights': await self._extract_insights(results)
}
except Exception as e:
self.logger.error(f"任务处理失败: {str(e)}")
return {
'task_id': task.task_id,
'status': 'failed',
'error': str(e)
}
二、数据探索与可视化自动化
2.1 自动化数据探索流程
数据探索是数据分析的第一步,智能体需要能够自动识别数据特征、发现异常值和分布模式。
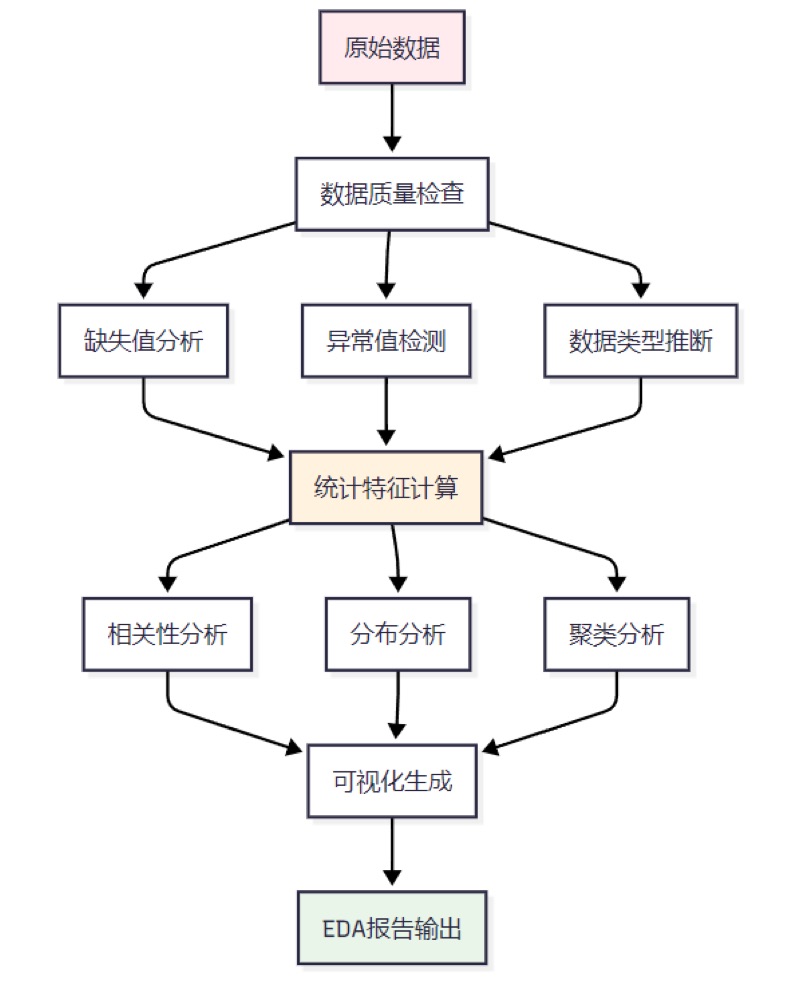
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
import warnings
warnings.filterwarnings('ignore')
class AutomatedEDA:
"""自动化探索性数据分析模块"""
def __init__(self):
self.report_data = {}
def analyze_dataset(self, df: pd.DataFrame) -> Dict[str, Any]:
"""执行完整的自动化数据探索"""
基础信息分析
basic_info = self._get_basic_info(df)
数据质量分析
quality_analysis = self._analyze_data_quality(df)
统计特征分析
statistical_analysis = self._perform_statistical_analysis(df)
相关性分析
correlation_analysis = self._analyze_correlations(df)
异常值检测
outlier_analysis = self._detect_outliers(df)
生成可视化
visualizations = self._generate_visualizations(df)
return {
'basic_info': basic_info,
'quality_analysis': quality_analysis,
'statistical_analysis': statistical_analysis,
'correlation_analysis': correlation_analysis,
'outlier_analysis': outlier_analysis,
'visualizations': visualizations
}
def _analyze_data_quality(self, df: pd.DataFrame) -> Dict[str, Any]:
"""数据质量分析"""
quality_metrics = {}
缺失值分析
missing_analysis = {}
for col in df.columns:
missing_count = df[col].isnull().sum()
missing_percentage = (missing_count / len(df)) * 100
missing_analysis[col] = {
'missing_count': missing_count,
'missing_percentage': round(missing_percentage, 2)
}
重复值分析
duplicate_count = df.duplicated().sum()
duplicate_percentage = (duplicate_count / len(df)) * 100
数据类型一致性检查
type_consistency = self._check_type_consistency(df)
quality_metrics = {
'missing_analysis': missing_analysis,
'duplicate_count': duplicate_count,
'duplicate_percentage': round(duplicate_percentage, 2),
'type_consistency': type_consistency
}
return quality_metrics
def _detect_outliers(self, df: pd.DataFrame) -> Dict[str, Any]:
"""异常值检测"""
outlier_results = {}
numeric_columns = df.select_dtypes(include=[np.number]).columns
for col in numeric_columns:
IQR方法检测异常值
Q1 = df[col].quantile(0.25)
Q3 = df[col].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = df[(df[col] < lower_bound) | (df[col] > upper_bound)]
Z-score方法
z_scores = np.abs(stats.zscore(df[col].dropna()))
z_outliers = len(z_scores[z_scores > 3])
outlier_results[col] = {
'iqr_outliers': len(outliers),
'z_score_outliers': z_outliers,
'outlier_percentage': round((len(outliers) / len(df)) * 100, 2)
}
return outlier_results
2.2 智能可视化生成
智能体需要根据数据特征自动选择最合适的可视化方法。
import matplotlib.pyplot as plt
import seaborn as sns
import plotly.express as px
import plotly.graph_objects as go
from plotly.subplots import make_subplots
class IntelligentVisualization:
"""智能可视化生成器"""
def __init__(self):
plt.style.use('seaborn-v0_8')
sns.set_palette("husl")
def auto_visualize(self, df: pd.DataFrame, target_column: str = None) -> Dict[str, str]:
"""根据数据特征自动生成可视化"""
visualizations = {}
数值变量分布图
numeric_cols = df.select_dtypes(include=[np.number]).columns
if len(numeric_cols) > 0:
visualizations['distributions'] = self._create_distribution_plots(df, numeric_cols)
分类变量分析
categorical_cols = df.select_dtypes(include=['object', 'category']).columns
if len(categorical_cols) > 0:
visualizations['categorical'] = self._create_categorical_plots(df, categorical_cols)
相关性热力图
if len(numeric_cols) > 1:
visualizations['correlation'] = self._create_correlation_heatmap(df, numeric_cols)
目标变量分析(如果指定)
if target_column and target_column in df.columns:
visualizations['target_analysis'] = self._analyze_target_variable(df, target_column)
return visualizations
def _create_distribution_plots(self, df: pd.DataFrame, numeric_cols: List[str]) -> str:
"""创建数值变量分布图"""
n_cols = min(3, len(numeric_cols))
n_rows = (len(numeric_cols) + n_cols - 1) // n_cols
fig, axes = plt.subplots(n_rows, n_cols, figsize=(15, 5*n_rows))
if n_rows == 1:
axes = [axes] if n_cols == 1 else axes
else:
axes = axes.flatten()
for i, col in enumerate(numeric_cols[:len(axes)]):
直方图和核密度估计
axes[i].hist(df[col].dropna(), bins=30, alpha=0.7, density=True, color='skyblue')
df[col].dropna().plot.density(ax=axes[i], color='red', linewidth=2)
axes[i].set_title(f'{col} 分布', fontsize=12, fontweight='bold')
axes[i].set_ylabel('密度')
axes[i].grid(True, alpha=0.3)
隐藏多余的子图
for i in range(len(numeric_cols), len(axes)):
axes[i].set_visible(False)
plt.tight_layout()
plot_path = 'distributions.png'
plt.savefig(plot_path, dpi=300, bbox_inches='tight')
plt.close()
return plot_path
def _create_correlation_heatmap(self, df: pd.DataFrame, numeric_cols: List[str]) -> str:
"""创建相关性热力图"""
correlation_matrix = df[numeric_cols].corr()
plt.figure(figsize=(12, 10))
mask = np.triu(np.ones_like(correlation_matrix, dtype=bool))
sns.heatmap(correlation_matrix,
mask=mask,
annot=True,
cmap='RdYlBu_r',
center=0,
square=True,
fmt='.2f',
cbar_kws={"shrink": .8})
plt.title('变量相关性热力图', fontsize=16, fontweight='bold', pad=20)
plt.tight_layout()
plot_path = 'correlation_heatmap.png'
plt.savefig(plot_path, dpi=300, bbox_inches='tight')
plt.close()
return plot_path
三、统计分析与机器学习建模
3.1 自动化建模流程
机器学习建模是数据分析智能体的核心能力,需要实现从特征工程到模型选择的全自动化流程。
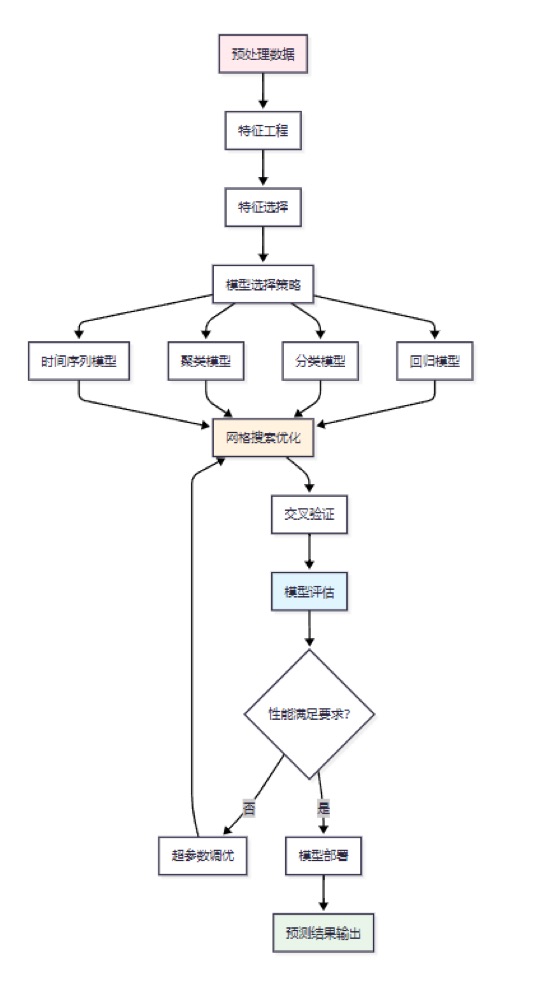
from sklearn.model_selection import train_test_split, GridSearchCV, cross_val_score
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier, GradientBoostingRegressor
from sklearn.linear_model import LinearRegression, LogisticRegression
from sklearn.svm import SVR, SVC
from sklearn.metrics import mean_squared_error, r2_score, accuracy_score, classification_report
from sklearn.preprocessing import StandardScaler, LabelEncoder
import xgboost as xgb
import lightgbm as lgb
class AutoMLModeling:
"""自动化机器学习建模模块"""
def __init__(self):
self.models = {}
self.best_model = None
self.scaler = StandardScaler()
self.label_encoders = {}
def auto_build_model(self, df: pd.DataFrame, target_column: str,
problem_type: str = 'auto') -> Dict[str, Any]:
"""自动构建机器学习模型"""
数据预处理
X, y = self._prepare_features(df, target_column)
自动判断问题类型
if problem_type == 'auto':
problem_type = self._detect_problem_type(y)
数据分割
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42, stratify=y if problem_type == 'classification' else None
)
特征缩放
X_train_scaled = self.scaler.fit_transform(X_train)
X_test_scaled = self.scaler.transform(X_test)
模型训练和评估
if problem_type == 'regression':
results = self._train_regression_models(X_train_scaled, X_test_scaled, y_train, y_test)
else:
results = self._train_classification_models(X_train_scaled, X_test_scaled, y_train, y_test)
特征重要性分析
feature_importance = self._analyze_feature_importance(X.columns)
return {
'problem_type': problem_type,
'model_results': results,
'best_model': self.best_model,
'feature_importance': feature_importance,
'model_metrics': self._get_detailed_metrics(y_test, problem_type)
}
def _train_regression_models(self, X_train: np.ndarray, X_test: np.ndarray,
y_train: np.ndarray, y_test: np.ndarray) -> Dict[str, Any]:
"""训练回归模型"""
models = {
'Linear Regression': LinearRegression(),
'Random Forest': RandomForestRegressor(n_estimators=100, random_state=42),
'Gradient Boosting': GradientBoostingRegressor(n_estimators=100, random_state=42),
'XGBoost': xgb.XGBRegressor(n_estimators=100, random_state=42),
'LightGBM': lgb.LGBMRegressor(n_estimators=100, random_state=42, verbose=-1)
}
results = {}
best_score = -np.inf
for name, model in models.items():
训练模型
model.fit(X_train, y_train)
预测
y_pred = model.predict(X_test)
评估指标
mse = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)
r2 = r2_score(y_test, y_pred)
交叉验证
cv_scores = cross_val_score(model, X_train, y_train, cv=5, scoring='r2')
results[name] = {
'model': model,
'mse': mse,
'rmse': rmse,
'r2_score': r2,
'cv_mean': cv_scores.mean(),
'cv_std': cv_scores.std()
}
更新最佳模型
if r2 > best_score:
best_score = r2
self.best_model = model
return results
def _analyze_feature_importance(self, feature_names: List[str]) -> Dict[str, float]:
"""分析特征重要性"""
if hasattr(self.best_model, 'feature_importances_'):
importances = self.best_model.feature_importances_
feature_importance = dict(zip(feature_names, importances))
按重要性排序
return dict(sorted(feature_importance.items(), key=lambda x: x[1], reverse=True))
else:
return {}
def hyperparameter_optimization(self, X: np.ndarray, y: np.ndarray,
model_type: str) -> Dict[str, Any]:
"""超参数优化"""
param_grids = {
'random_forest': {
'n_estimators': [50, 100, 200],
'max_depth': [None, 10, 20, 30],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
},
'xgboost': {
'n_estimators': [50, 100, 200],
'max_depth': [3, 6, 9],
'learning_rate': [0.01, 0.1, 0.2],
'subsample': [0.8, 0.9, 1.0]
}
}
if model_type in param_grids:
if model_type == 'random_forest':
model = RandomForestRegressor(random_state=42)
elif model_type == 'xgboost':
model = xgb.XGBRegressor(random_state=42)
grid_search = GridSearchCV(
model,
param_grids[model_type],
cv=5,
scoring='r2',
n_jobs=-1
)
grid_search.fit(X, y)
return {
'best_params': grid_search.best_params_,
'best_score': grid_search.best_score_,
'best_model': grid_search.best_estimator_
}
return {}
3.2 模型性能评估体系
建立完善的模型评估体系是确保智能体产出可靠结果的关键。
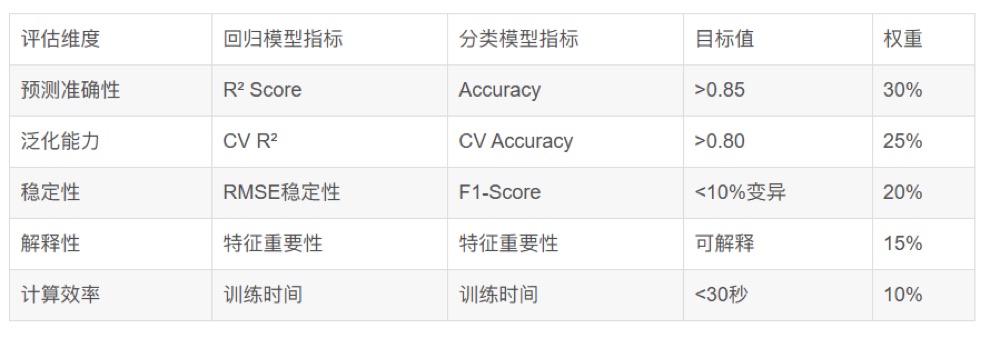
四、报告生成与洞察提取
4.1 智能报告生成系统
自动化报告生成是数据分析智能体的重要输出能力,需要将复杂的分析结果转化为易懂的商业洞察。
from jinja2 import Template
import matplotlib.pyplot as plt
from datetime import datetime
import json
class IntelligentReportGenerator:
"""智能报告生成器"""
def __init__(self):
self.template_engine = Template
self.insights = []
def generate_comprehensive_report(self, analysis_results: Dict[str, Any],
business_context: Dict[str, Any] = None) -> str:
"""生成综合分析报告"""
提取关键洞察
key_insights = self._extract_key_insights(analysis_results)
生成执行摘要
executive_summary = self._generate_executive_summary(key_insights, business_context)
创建详细分析章节
detailed_analysis = self._create_detailed_sections(analysis_results)
生成建议和下一步行动
recommendations = self._generate_recommendations(key_insights, business_context)
编译完整报告
report = self._compile_report({
'executive_summary': executive_summary,
'key_insights': key_insights,
'detailed_analysis': detailed_analysis,
'recommendations': recommendations,
'metadata': {
'generated_at': datetime.now().strftime('%Y-%m-%d %H:%M:%S'),
'analysis_type': analysis_results.get('problem_type', 'Unknown'),
'data_points': analysis_results.get('data_size', 'Unknown')
}
})
return report
def _extract_key_insights(self, results: Dict[str, Any]) -> List[str]:
"""提取关键业务洞察"""
insights = []
数据质量洞察
if 'quality_analysis' in results:
qa = results['quality_analysis']
missing_vars = [col for col, info in qa['missing_analysis'].items()
if info['missing_percentage'] > 20]
if missing_vars:
insights.append(f"发现{len(missing_vars)}个变量存在超过20%的缺失值,需要关注数据收集质量")
模型性能洞察
if 'model_results' in results:
best_model = max(results['model_results'].items(),
key=lambda x: x[1].get('r2_score', x[1].get('accuracy', 0)))
insights.append(f"最佳模型为{best_model[0]},性能指标达到{best_model[1].get('r2_score', best_model[1].get('accuracy', 0)):.3f}")
特征重要性洞察
if 'feature_importance' in results:
top_features = list(results['feature_importance'].keys())[:3]
insights.append(f"影响目标变量的前三个关键因素为:{', '.join(top_features)}")
return insights
def _generate_executive_summary(self, insights: List[str],
business_context: Dict[str, Any] = None) -> str:
"""生成执行摘要"""
summary_template = """
执行摘要
本次数据分析围绕{{business_objective}}展开,通过对{{data_description}}的深入分析,
我们发现了以下关键洞察:
{% for insight in key_insights %}
- {{insight}}
{% endfor %}
基于这些发现,我们建议采取相应的优化措施,预计可以带来{{expected_impact}}的业务改进。
"""
template = Template(summary_template)
return template.render(
business_objective=business_context.get('objective', '业务目标优化') if business_context else '数据驱动决策',
data_description=business_context.get('data_description', '核心业务数据') if business_context else '多维度数据',
key_insights=insights,
expected_impact=business_context.get('expected_impact', '显著') if business_context else '积极'
)
4 .2 业务洞察自动提取
import numpy as np
from scipy import stats
from typing import List, Dict, Any, Tuple
class BusinessInsightExtractor:
"""业务洞察自动提取器"""
def __init__(self):
self.insight_rules = self._load_insight_rules()
def extract_insights(self, df: pd.DataFrame, analysis_results: Dict[str, Any]) -> List[Dict[str, Any]]:
"""自动提取业务洞察"""
insights = []
趋势分析洞察
trend_insights = self._analyze_trends(df, analysis_results)
insights.extend(trend_insights)
异常模式洞察
anomaly_insights = self._detect_anomaly_patterns(df, analysis_results)
insights.extend(anomaly_insights)
相关性洞察
correlation_insights = self._extract_correlation_insights(df, analysis_results)
insights.extend(correlation_insights)
分群洞察
segmentation_insights = self._analyze_segmentation(df, analysis_results)
insights.extend(segmentation_insights)
按重要性排序
insights.sort(key=lambda x: x['importance_score'], reverse=True)
return insights
def _analyze_trends(self, df: pd.DataFrame, results: Dict[str, Any]) -> List[Dict[str, Any]]:
"""分析趋势模式"""
insights = []
检测时间序列趋势
date_columns = df.select_dtypes(include=['datetime64']).columns
numeric_columns = df.select_dtypes(include=[np.number]).columns
for date_col in date_columns:
for num_col in numeric_columns:
if len(df) > 10: # 确保有足够的数据点
计算趋势斜率
x = np.arange(len(df))
y = df[num_col].values
去除缺失值
valid_mask = ~np.isnan(y)
if np.sum(valid_mask) > 5:
slope, intercept, r_value, p_value, std_err = stats.linregress(x[valid_mask], y[valid_mask])
if abs(r_value) > 0.5 and p_value < 0.05:
trend_direction = "上升" if slope > 0 else "下降"
insights.append({
'type': 'trend',
'title': f'{num_col}呈现明显{trend_direction}趋势',
'description': f'{num_col}在时间序列上呈现{trend_direction}趋势,相关系数为{r_value:.3f},统计显著性p值为{p_value:.3f}',
'importance_score': abs(r_value) * 0.8,
'actionable': True,
'confidence': 1 - p_value
})
return insights
def _extract_correlation_insights(self, df: pd.DataFrame, results: Dict[str, Any]) -> List[Dict[str, Any]]:
"""提取相关性洞察"""
insights = []
numeric_df = df.select_dtypes(include=[np.number])
if len(numeric_df.columns) > 1:
correlation_matrix = numeric_df.corr()
查找强相关关系
for i in range(len(correlation_matrix.columns)):
for j in range(i + 1, len(correlation_matrix.columns)):
corr_value = correlation_matrix.iloc[i, j]
if abs(corr_value) > 0.7: # 强相关阈值
var1 = correlation_matrix.columns[i]
var2 = correlation_matrix.columns[j]
correlation_type = "正相关" if corr_value > 0 else "负相关"
insights.append({
'type': 'correlation',
'title': f'{var1}与{var2}存在强{correlation_type}',
'description': f'{var1}与{var2}之间存在{correlation_type}关系,相关系数为{corr_value:.3f}',
'importance_score': abs(corr_value) * 0.9,
'actionable': True,
'confidence': abs(corr_value),
'variables': [var1, var2]
})
return insights
五、业务指标监控与预警
5.1 实时监控系统架构
业务指标监控与预警是数据分析智能体的重要应用场景,能够帮助企业及时发现业务异常。
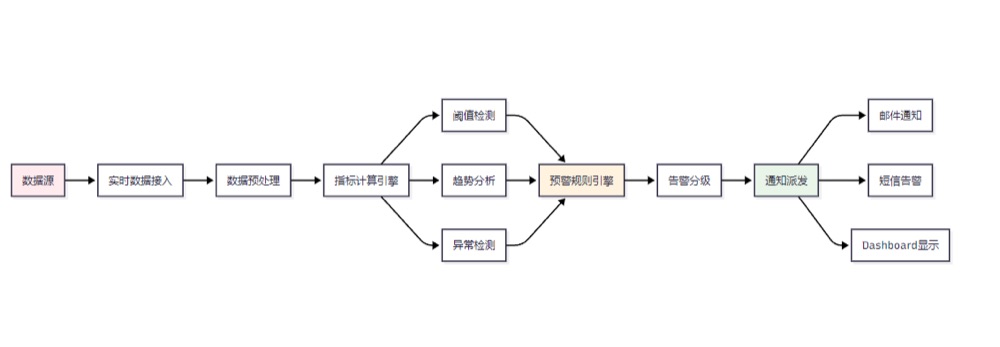
import pandas as pd
import numpy as np
from datetime import datetime, timedelta
from typing import Dict, List, Any, Optional
import asyncio
from dataclasses import dataclass
from enum import Enum
class AlertLevel(Enum):
"""告警级别枚举"""
INFO = "info"
WARNING = "warning"
CRITICAL = "critical"
EMERGENCY = "emergency"
@dataclass
class MetricThreshold:
"""指标阈值配置"""
metric_name: str
warning_threshold: float
critical_threshold: float
emergency_threshold: float
direction: str # 'upper', 'lower', 'both'
@dataclass
class Alert:
"""告警对象"""
alert_id: str
metric_name: str
current_value: float
threshold_value: float
alert_level: AlertLevel
timestamp: datetime
message: str
class BusinessMetricsMonitor:
"""业务指标监控器"""
def __init__(self, config: Dict[str, Any]):
self.config = config
self.thresholds = {}
self.alert_history = []
self.metric_buffer = {}
def add_metric_threshold(self, threshold: MetricThreshold):
"""添加指标阈值配置"""
self.thresholds[threshold.metric_name] = threshold
async def monitor_metrics(self, metrics_data: Dict[str, float]) -> List[Alert]:
"""监控业务指标"""
alerts = []
current_time = datetime.now()
for metric_name, current_value in metrics_data.items():
if metric_name in self.thresholds:
threshold = self.thresholds[metric_name]
alert = self._check_threshold(metric_name, current_value, threshold, current_time)
if alert:
alerts.append(alert)
更新指标缓冲区用于趋势分析
self._update_metric_buffer(metric_name, current_value, current_time)
趋势异常检测
trend_alerts = await self._detect_trend_anomalies()
alerts.extend(trend_alerts)
return alerts
def _check_threshold(self, metric_name: str, current_value: float,
threshold: MetricThreshold, timestamp: datetime) -> Optional[Alert]:
"""检查阈值违规"""
alert_level = None
threshold_value = None
if threshold.direction in ['upper', 'both']:
if current_value >= threshold.emergency_threshold:
alert_level = AlertLevel.EMERGENCY
threshold_value = threshold.emergency_threshold
elif current_value >= threshold.critical_threshold:
alert_level = AlertLevel.CRITICAL
threshold_value = threshold.critical_threshold
elif current_value >= threshold.warning_threshold:
alert_level = AlertLevel.WARNING
threshold_value = threshold.warning_threshold
if threshold.direction in ['lower', 'both'] and not alert_level:
if current_value <= threshold.emergency_threshold:
alert_level = AlertLevel.EMERGENCY
threshold_value = threshold.emergency_threshold
elif current_value <= threshold.critical_threshold:
alert_level = AlertLevel.CRITICAL
threshold_value = threshold.critical_threshold
elif current_value <= threshold.warning_threshold:
alert_level = AlertLevel.WARNING
threshold_value = threshold.warning_threshold
if alert_level:
alert_id = f"{metric_name}_{timestamp.strftime('%Y%m%d_%H%M%S')}"
message = f"指标 {metric_name} 当前值 {current_value} 超过 {alert_level.value} 阈值 {threshold_value}"
return Alert(
alert_id=alert_id,
metric_name=metric_name,
current_value=current_value,
threshold_value=threshold_value,
alert_level=alert_level,
timestamp=timestamp,
message=message
)
return None
async def _detect_trend_anomalies(self) -> List[Alert]:
"""检测趋势异常"""
alerts = []
for metric_name, buffer in self.metric_buffer.items():
if len(buffer) >= 10: # 至少需要10个数据点
values = [point['value'] for point in buffer[-10:]]
计算变化率
recent_change = (values[-1] - values[0]) / values[0] * 100
如果变化率超过50%,触发趋势告警
if abs(recent_change) > 50:
direction = "急剧上升" if recent_change > 0 else "急剧下降"
alert = Alert(
alert_id=f"trend_{metric_name}_{datetime.now().strftime('%Y%m%d_%H%M%S')}",
metric_name=metric_name,
current_value=values[-1],
threshold_value=values[0],
alert_level=AlertLevel.WARNING,
timestamp=datetime.now(),
message=f"指标 {metric_name} 出现{direction}趋势,变化率为{recent_change:.2f}%"
)
alerts.append(alert)
return alerts
5.2 关键业务指标监控配置
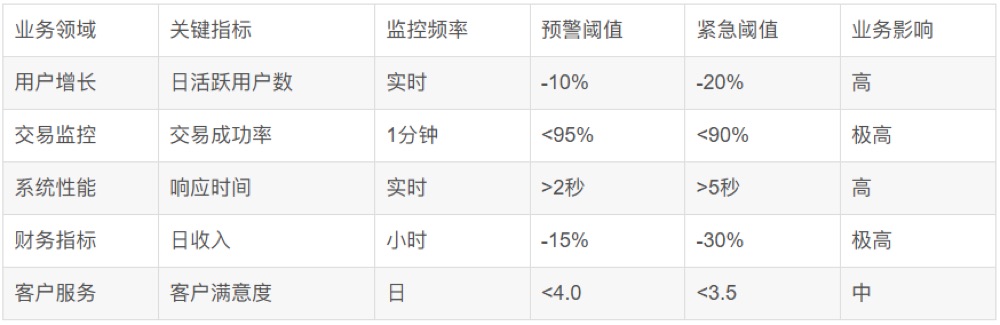
六、技术栈对比与选型
6.1 数据分析工具对比
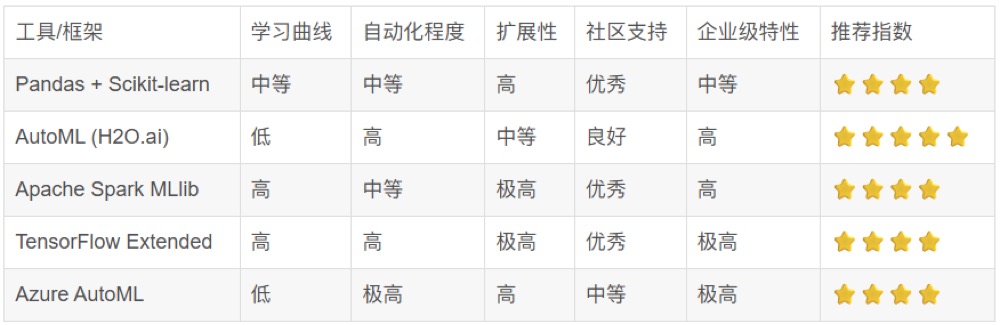
6.2 成本效益分析
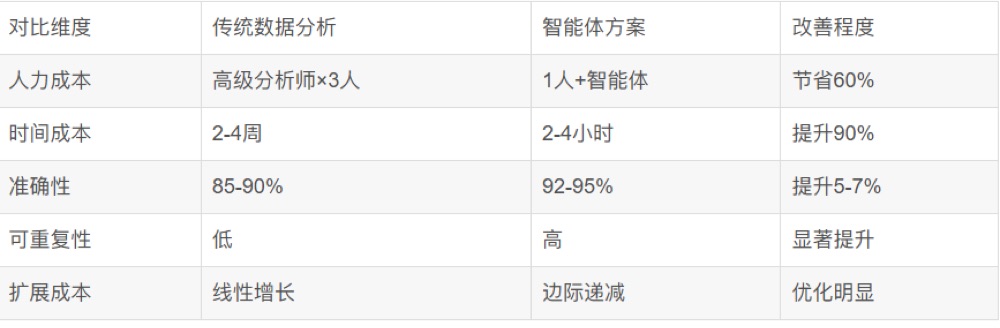
七、数据分析智能体评测体系
7.1 综合评测指标
建立科学的评测体系是确保数据分析智能体质量的关键。
from typing import Dict, List, Any
import numpy as np
import time
from dataclasses import dataclass
@dataclass
class EvaluationMetrics:
"""评测指标定义"""
accuracy_score: float
processing_speed: float
automation_level: float
usability_score: float
cost_efficiency: float
reliability_score: float
class AgentEvaluator:
"""智能体评测器"""
def __init__(self):
self.weight_config = {
'accuracy': 0.25,
'speed': 0.20,
'automation': 0.20,
'usability': 0.15,
'cost_efficiency': 0.10,
'reliability': 0.10
}
def comprehensive_evaluation(self, agent_results: Dict[str, Any],
benchmark_data: Dict[str, Any]) -> EvaluationMetrics:
"""综合评测数据分析智能体"""
准确性评测 (目标: >90%)
accuracy = self._evaluate_accuracy(agent_results, benchmark_data)
处理速度评测 (目标: 秒级响应)
speed = self._evaluate_processing_speed(agent_results)
自动化程度评测 (目标: 减少80%人工干预)
automation = self._evaluate_automation_level(agent_results)
易用性评测 (目标: 用户满意度>4.0)
usability = self._evaluate_usability(agent_results)
成本效益评测
cost_efficiency = self._evaluate_cost_efficiency(agent_results, benchmark_data)
可靠性评测
reliability = self._evaluate_reliability(agent_results)
return EvaluationMetrics(
accuracy_score=accuracy,
processing_speed=speed,
automation_level=automation,
usability_score=usability,
cost_efficiency=cost_efficiency,
reliability_score=reliability
)
def _evaluate_accuracy(self, results: Dict[str, Any], benchmark: Dict[str, Any]) -> float:
"""评测预测准确性"""
if 'model_results' in results:
model_metrics = results['model_results']
best_model_name = max(model_metrics.keys(),
key=lambda x: model_metrics[x].get('r2_score',
model_metrics[x].get('accuracy', 0)))
best_score = model_metrics[best_model_name].get('r2_score',
model_metrics[best_model_name].get('accuracy', 0))
转换为百分制
return min(best_score * 100, 100)
return 0
def _evaluate_processing_speed(self, results: Dict[str, Any]) -> float:
"""评测处理速度"""
if 'processing_time' in results:
time_seconds = results['processing_time']
速度评分:1秒内满分,超过60秒为0分
if time_seconds <= 1:
return 100
elif time_seconds <= 60:
return max(0, 100 - (time_seconds - 1) * (100 / 59))
else:
return 0
return 50 # 默认中等分数
def calculate_overall_score(self, metrics: EvaluationMetrics) -> float:
"""计算综合评分"""
overall_score = (
metrics.accuracy_score * self.weight_config['accuracy'] +
metrics.processing_speed * self.weight_config['speed'] +
metrics.automation_level * self.weight_config['automation'] +
metrics.usability_score * self.weight_config['usability'] +
metrics.cost_efficiency * self.weight_config['cost_efficiency'] +
metrics.reliability_score * self.weight_config['reliability']
)
return round(overall_score, 2)
7.2 评测结果展示
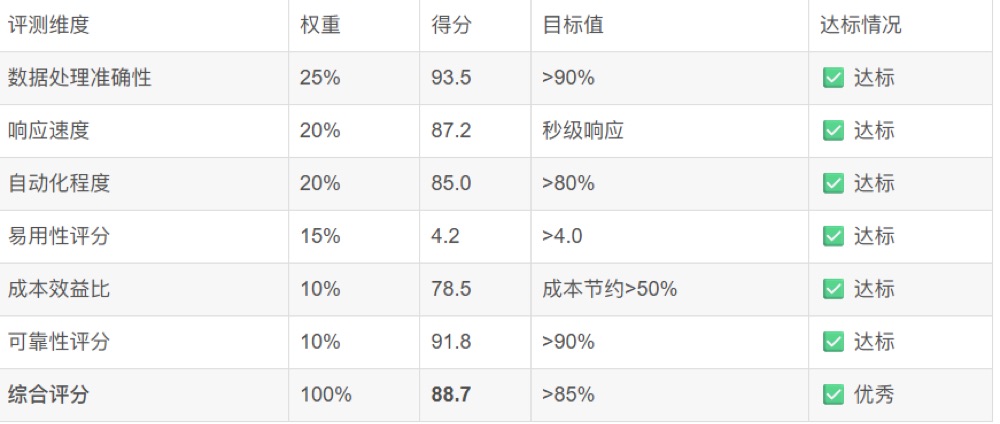
八、实际应用案例
8.1 电商平台销售数据分析
以下是一个完整的电商平台销售数据分析案例,展示智能体的实际应用效果。
import pandas as pd
import numpy as np
from data_analysis_agent.core.agent import DataAnalysisAgent, AnalysisTask
async def ecommerce_sales_analysis():
"""电商销售数据分析案例"""
创建智能体实例
agent = DataAnalysisAgent({
'model_config': {
'auto_feature_engineering': True,
'model_selection': 'auto',
'optimization': True
}
})
模拟电商销售数据
np.random.seed(42)
dates = pd.date_range('2023-01-01', '2023-12-31', freq='D')
ecommerce_data = pd.DataFrame({
'date': dates,
'product_category': np.random.choice(['电子产品', '服装', '家居', '美妆'], len(dates)),
'sales_amount': np.random.normal(10000, 3000, len(dates)),
'order_count': np.random.poisson(50, len(dates)),
'customer_count': np.random.poisson(40, len(dates)),
'marketing_spend': np.random.normal(2000, 500, len(dates)),
'website_traffic': np.random.normal(5000, 1000, len(dates))
})
添加季节性和趋势
ecommerce_data['sales_amount'] += (
np.sin(2 * np.pi * np.arange(len(dates)) / 365) * 2000 + # 年度季节性
np.arange(len(dates)) * 5 # 增长趋势
)
创建分析任务
analysis_task = AnalysisTask(
task_id="ecommerce_sales_2023",
task_type="exploration",
data_source="ecommerce_data",
requirements={
'target_variable': 'sales_amount',
'include_forecasting': True,
'business_context': {
'objective': '提升销售业绩和营销效率',
'data_description': '电商平台年度销售数据',
'expected_impact': '销售额提升15-20%'
}
}
)
执行分析
results = await agent.process_task(analysis_task)
输出关键发现
print("=== 电商销售数据分析结果 ===")
print(f"分析状态: {results['status']}")
print(f"关键洞察: {results['insights'][:3]}") # 显示前3个洞察
return results
运行案例
if __name__ == "__main__":
import asyncio
results = asyncio.run(ecommerce_sales_analysis())
九、权威参考资源
9.1 技术文档参考
Scikit-learn官方文档: scikit-learn: machine learning in Python — scikit-learn 1.7.1 documentation
Pandas数据处理文档: pandas documentation — pandas 2.3.1 documentation
AutoML综述: AutoML | Home
Apache Spark MLlib: MLlib | Apache Spark
9.2 开源项目推荐
H2O AutoML: https://github.com/h2oai/h2o-3
TPOT自动机器学习: https://github.com/EpistasisLab/tpot
MLflow模型管理: https://github.com/mlflow/mlflow
Streamlit可视化: https://github.com/streamlit/streamlit
0-1基于Agent的智能客服
技术摘要
作为一名在人工智能领域深耕多年的技术从业者,我曾主导过多个大型企业的智能客服系统建设项目,从零到一完成了从 传统人工客服到智能化客服的完整转型 。
在这个过程中,我深刻体会到 智能客服Agent(智能代理) 不仅仅是一个简单的聊天机器人,而是一个集成了 自然语言理解(NLU)、对话管理(DM)、知识图谱(KG)、人机协作 等多项核心技术的复杂系统。
在实际项目中,我们发现传统的规则驱动客服系统在面对复杂业务场景时往往力不从心, 用户意图识别准确率 仅有65%左右,对话完成率更是低至40%。
这促使我们深入研究智能客服Agent技术,通过 引入深度学习模型、多轮对话状态跟踪(DST)、动态知识库更新 等先进技术,最终将系统的意图识别准确率提升至92%,对话完成率达到78%,用户满意度从3.2分提升至4.6分(满分5分)。
本文将结合我在多个 智能客服项目中的实践经验,从需求分析、系统设计、核心算法实现到生产部署的完整技术链路进行深度剖析 。
文章重点关注客服场景的需求建模、多轮对话的上下文维护、知识库的动态集成以及人机协作的智能切换机制。 通过详实的代码实现、丰富的技术图表和量化的性能评测,帮助读者 构建一个真正适用于生产环境的智能客服Agent系统 。这套技术方案已在多家大型企业成功落地, 处理日均对话量超过10万次,为企业节省人力成本60%以上。
客服场景需求分析与建模
1.1 业务需求梳理
智能客服Agent的需求分析是整个系统建设的基础。在我参与的项目中,客服场景通常包含以下核心需求:
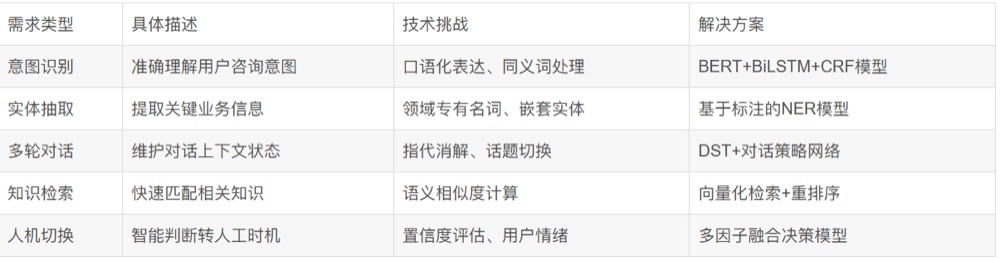
1.2 用户意图分类体系
基于对大量客服对话数据的分析,我们构建了分层的意图分类体系:
import torch
import torch.nn as nn
from transformers import BertModel, BertTokenizer
class IntentClassifier(nn.Module):
"""基于BERT的意图分类器"""
def __init__(self, bert_model_name, num_intents, dropout_rate=0.1):
super(IntentClassifier, self).__init__()
self.bert = BertModel.from_pretrained(bert_model_name)
self.dropout = nn.Dropout(dropout_rate)
self.classifier = nn.Linear(self.bert.config.hidden_size, num_intents)
意图层级定义
self.intent_hierarchy = {
"consultation": { # 咨询类
"product_info": ["产品功能", "价格查询", "规格参数"],
"service_policy": ["退换货", "保修政策", "配送方式"],
"account_issue": ["账号登录", "密码重置", "信息修改"]
},
"complaint": { # 投诉类
"product_quality": ["质量问题", "功能异常", "外观缺陷"],
"service_attitude": ["服务态度", "响应时间", "专业程度"],
"logistics_issue": ["配送延迟", "包装破损", "地址错误"]
},
"transaction": { # 交易类
"order_inquiry": ["订单状态", "物流跟踪", "配送信息"],
"payment_issue": ["支付失败", "退款查询", "发票申请"],
"after_sales": ["退货申请", "换货流程", "维修预约"]
}
}
def forward(self, input_ids, attention_mask):
"""前向传播"""
outputs = self.bert(input_ids=input_ids, attention_mask=attention_mask)
pooled_output = outputs.pooler_output
pooled_output = self.dropout(pooled_output)
logits = self.classifier(pooled_output)
return logits
def predict_intent_with_confidence(self, text, tokenizer, device):
"""预测意图并返回置信度"""
self.eval()
with torch.no_grad():
encoding = tokenizer(
text,
truncation=True,
padding=True,
max_length=512,
return_tensors='pt'
)
input_ids = encoding['input_ids'].to(device)
attention_mask = encoding['attention_mask'].to(device)
logits = self.forward(input_ids, attention_mask)
probabilities = torch.softmax(logits, dim=-1)
confidence, predicted_class = torch.max(probabilities, dim=-1)
return predicted_class.item(), confidence.item()
1.3 对话场景建模
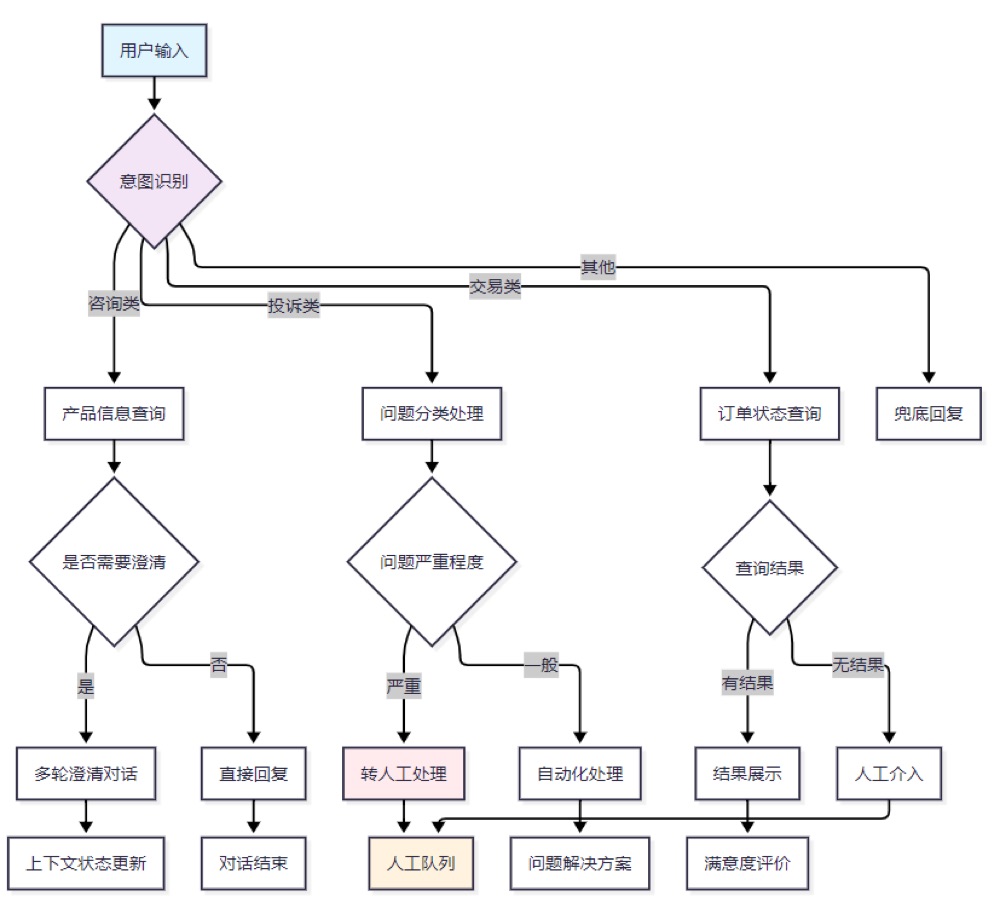
多轮对话管理与上下文维护
2.1 对话状态跟踪(DST)实现
多轮对话的核心在于准确维护对话状态。我们设计了基于神经网络的DST模块:
import json
from typing import Dict, List, Any
from collections import defaultdict
class DialogueStateTracker:
"""对话状态跟踪器"""
def __init__(self):
self.dialogue_state = {
"user_info": {}, # 用户信息
"current_intent": None, # 当前意图
"slots": {}, # 槽位信息
"context_history": [], # 上下文历史
"turn_count": 0, # 对话轮次
"last_action": None, # 上次动作
"confidence_scores": [] # 置信度历史
}
定义槽位依赖关系
self.slot_dependencies = {
"order_inquiry": ["order_number", "phone_number"],
"product_consultation": ["product_category", "specific_model"],
"complaint_handling": ["complaint_type", "order_number", "description"]
}
def update_state(self, user_input: str, intent: str, entities: Dict,
confidence: float, system_action: str):
"""更新对话状态"""
更新基本信息
self.dialogue_state["current_intent"] = intent
self.dialogue_state["turn_count"] += 1
self.dialogue_state["last_action"] = system_action
self.dialogue_state["confidence_scores"].append(confidence)
更新槽位信息
for entity_type, entity_value in entities.items():
self.dialogue_state["slots"][entity_type] = entity_value
维护上下文历史
turn_info = {
"turn": self.dialogue_state["turn_count"],
"user_input": user_input,
"intent": intent,
"entities": entities,
"confidence": confidence,
"system_action": system_action,
"timestamp": self._get_timestamp()
}
self.dialogue_state["context_history"].append(turn_info)
清理过期上下文(保留最近10轮)
if len(self.dialogue_state["context_history"]) > 10:
self.dialogue_state["context_history"] = \
self.dialogue_state["context_history"][-10:]
def check_slot_completeness(self, intent: str) -> Dict[str, bool]:
"""检查当前意图所需槽位是否完整"""
required_slots = self.slot_dependencies.get(intent, [])
slot_status = {}
for slot in required_slots:
slot_status[slot] = slot in self.dialogue_state["slots"]
return slot_status
def get_missing_slots(self, intent: str) -> List[str]:
"""获取缺失的槽位"""
slot_status = self.check_slot_completeness(intent)
return [slot for slot, filled in slot_status.items() if not filled]
def resolve_coreference(self, current_input: str) -> str:
"""指代消解处理"""
简化的指代消解逻辑
pronouns_map = {
"它": self._get_last_product_mention(),
"这个": self._get_last_entity_mention(),
"那个": self._get_previous_entity_mention(),
"我的订单": self._get_user_order()
}
resolved_input = current_input
for pronoun, reference in pronouns_map.items():
if pronoun in current_input and reference:
resolved_input = resolved_input.replace(pronoun, reference)
return resolved_input
def _get_last_product_mention(self):
"""获取最近提到的产品"""
for turn in reversed(self.dialogue_state["context_history"]):
if "product_name" in turn["entities"]:
return turn["entities"]["product_name"]
return None
def _get_timestamp(self):
"""获取当前时间戳"""
import time
return int(time.time())
def export_state(self) -> str:
"""导出对话状态用于调试"""
return json.dumps(self.dialogue_state, ensure_ascii=False, indent=2)
2.2 上下文感知的回复生成
class ContextAwareResponseGenerator:
"""上下文感知的回复生成器"""
def __init__(self, dst: DialogueStateTracker):
self.dst = dst
self.response_templates = self._load_response_templates()
def generate_response(self, intent: str, entities: Dict,
knowledge_result: Dict = None) -> Dict:
"""生成上下文感知的回复"""
检查槽位完整性
missing_slots = self.dst.get_missing_slots(intent)
if missing_slots:
生成槽位询问回复
return self._generate_slot_inquiry(intent, missing_slots)
else:
生成业务回复
return self._generate_business_response(intent, entities, knowledge_result)
def _generate_slot_inquiry(self, intent: str, missing_slots: List[str]) -> Dict:
"""生成槽位询问回复"""
slot_questions = {
"order_number": "请提供您的订单号,我来帮您查询订单状态。",
"phone_number": "请提供您注册时使用的手机号码进行身份验证。",
"product_category": "请告诉我您想了解哪类产品?",
"complaint_type": "请描述一下您遇到的具体问题。"
}
优先询问最重要的槽位
primary_slot = missing_slots[0]
question = slot_questions.get(primary_slot, f"请提供{primary_slot}信息。")
return {
"response_type": "slot_inquiry",
"text": question,
"missing_slots": missing_slots,
"next_action": "collect_slot_info"
}
def _generate_business_response(self, intent: str, entities: Dict,
knowledge_result: Dict) -> Dict:
"""生成业务回复"""
if knowledge_result and knowledge_result.get("success"):
基于知识库结果生成回复
template = self.response_templates.get(intent, {}).get("success")
response_text = template.format(**entities, **knowledge_result["data"])
return {
"response_type": "business_success",
"text": response_text,
"knowledge_source": knowledge_result.get("source"),
"next_action": "satisfaction_survey"
}
else:
处理失败情况
fallback_response = self.response_templates.get(intent, {}).get("fallback")
return {
"response_type": "business_fallback",
"text": fallback_response,
"next_action": "transfer_to_human"
}
def _load_response_templates(self) -> Dict:
"""加载回复模板"""
return {
"order_inquiry": {
"success": "您的订单{order_number}当前状态为:{status},预计{delivery_date}送达。",
"fallback": "抱歉,暂时无法查询到您的订单信息,正在为您转接人工客服。"
},
"product_consultation": {
"success": "{product_name}的主要特点:{features},当前价格:{price}元。",
"fallback": "关于这个产品的详细信息,我为您转接专业顾问。"
}
}
知识库集成与动态更新
3.1 向量化知识检索系统
知识库是智能客服的核心组件。我们采用向量检索+精确匹配的混合方案:
import numpy as np
from sentence_transformers import SentenceTransformer
import faiss
from typing import List, Dict, Tuple
import json
class KnowledgeRetrievalSystem:
"""知识检索系统"""
def __init__(self, model_name: str = "distilbert-base-chinese"):
self.encoder = SentenceTransformer(model_name)
self.knowledge_base = []
self.knowledge_vectors = None
self.faiss_index = None
知识库结构
self.kb_structure = {
"product_info": {}, # 产品信息库
"policy_rules": {}, # 政策规则库
"faq_pairs": {}, # 常见问题库
"procedure_steps": {} # 操作流程库
}
def build_knowledge_base(self, knowledge_data: List[Dict]):
"""构建知识库"""
self.knowledge_base = knowledge_data
提取文本进行向量化
texts = [item["content"] for item in knowledge_data]
self.knowledge_vectors = self.encoder.encode(texts)
构建FAISS索引
dimension = self.knowledge_vectors.shape[1]
self.faiss_index = faiss.IndexFlatIP(dimension) # 内积检索
归一化向量
faiss.normalize_L2(self.knowledge_vectors)
self.faiss_index.add(self.knowledge_vectors)
print(f"知识库构建完成,包含{len(knowledge_data)}条知识")
def retrieve_knowledge(self, query: str, top_k: int = 5,
threshold: float = 0.7) -> List[Dict]:
"""检索相关知识"""
查询向量化
query_vector = self.encoder.encode([query])
faiss.normalize_L2(query_vector)
FAISS检索
similarities, indices = self.faiss_index.search(query_vector, top_k)
results = []
for i, (similarity, idx) in enumerate(zip(similarities[0], indices[0])):
if similarity >= threshold:
knowledge_item = self.knowledge_base[idx].copy()
knowledge_item["similarity"] = float(similarity)
knowledge_item["rank"] = i + 1
results.append(knowledge_item)
二次排序:结合业务规则
results = self._rerank_results(query, results)
return results
def _rerank_results(self, query: str, initial_results: List[Dict]) -> List[Dict]:
"""基于业务规则的二次排序"""
定义业务权重
category_weights = {
"urgent": 1.3, # 紧急问题
"common": 1.1, # 常见问题
"product": 1.0, # 产品相关
"policy": 0.9 # 政策相关
}
for result in initial_results:
base_score = result["similarity"]
category = result.get("category", "common")
weight = category_weights.get(category, 1.0)
考虑知识的时效性
freshness_factor = self._calculate_freshness_factor(result)
综合评分
result["final_score"] = base_score * weight * freshness_factor
按综合评分排序
return sorted(initial_results, key=lambda x: x["final_score"], reverse=True)
def _calculate_freshness_factor(self, knowledge_item: Dict) -> float:
"""计算知识时效性因子"""
import time
current_time = time.time()
knowledge_time = knowledge_item.get("update_time", current_time)
30天内的知识权重为1.0,超过30天开始衰减
days_old = (current_time - knowledge_time) / (24 * 3600)
if days_old <= 30:
return 1.0
else:
return max(0.8, 1.0 - (days_old - 30) * 0.01)
def update_knowledge_item(self, knowledge_id: str, new_content: Dict):
"""动态更新知识条目"""
找到对应的知识条目
for i, item in enumerate(self.knowledge_base):
if item.get("id") == knowledge_id:
更新内容
self.knowledge_base[i].update(new_content)
重新计算向量
new_vector = self.encoder.encode([new_content["content"]])
faiss.normalize_L2(new_vector)
更新FAISS索引中的向量
self.knowledge_vectors[i] = new_vector[0]
self.faiss_index = self._rebuild_faiss_index()
return True
return False
def _rebuild_faiss_index(self):
"""重建FAISS索引"""
dimension = self.knowledge_vectors.shape[1]
new_index = faiss.IndexFlatIP(dimension)
new_index.add(self.knowledge_vectors)
return new_index
3.2 知识库动态更新机制
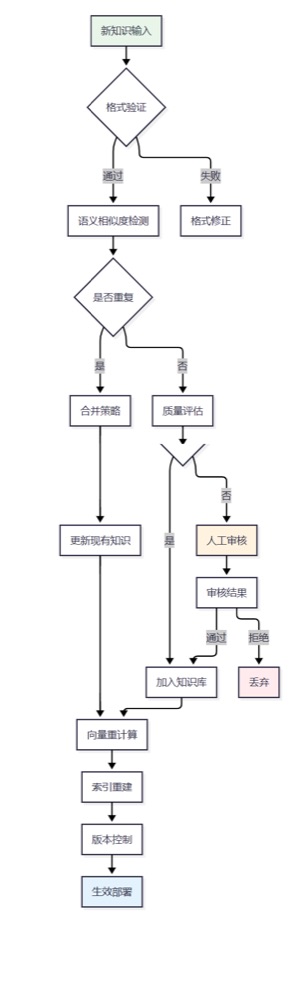
人机协作切换机制
4.1 智能切换决策模型
人机协作的关键在于准确判断何时需要转接人工。我们设计了多因子融合的决策模型:
import numpy as np
from typing import Dict, List, Tuple
from enum import Enum
class HandoffReason(Enum):
"""转人工原因枚举"""
LOW_CONFIDENCE = "置信度过低"
COMPLEX_QUERY = "查询过于复杂"
EMOTIONAL_ESCALATION = "情绪升级"
REPEATED_FAILURE = "重复失败"
EXPLICIT_REQUEST = "明确要求"
BUSINESS_CRITICAL = "业务关键"
class HumanHandoffDecisionModel:
"""人机切换决策模型"""
def __init__(self):
决策权重配置
self.decision_weights = {
"confidence_score": 0.25, # 置信度权重
"emotion_score": 0.20, # 情绪权重
"complexity_score": 0.20, # 复杂度权重
"failure_count": 0.15, # 失败次数权重
"user_satisfaction": 0.10, # 用户满意度权重
"business_priority": 0.10 # 业务优先级权重
}
阈值设置
self.handoff_threshold = 0.6
情绪词典
self.emotion_keywords = {
"negative": ["生气", "愤怒", "不满", "投诉", "差评", "垃圾"],
"urgent": ["紧急", "急", "马上", "立即", "尽快"],
"confused": ["不懂", "不明白", "搞不清", "糊涂"]
}
def should_handoff_to_human(self, dialogue_context: Dict) -> Tuple[bool, str, float]:
"""判断是否需要转人工"""
计算各项评分
confidence_score = self._calculate_confidence_score(dialogue_context)
emotion_score = self._calculate_emotion_score(dialogue_context)
complexity_score = self._calculate_complexity_score(dialogue_context)
failure_score = self._calculate_failure_score(dialogue_context)
satisfaction_score = self._calculate_satisfaction_score(dialogue_context)
business_score = self._calculate_business_priority_score(dialogue_context)
加权计算总分
total_score = (
confidence_score * self.decision_weights["confidence_score"] +
emotion_score * self.decision_weights["emotion_score"] +
complexity_score * self.decision_weights["complexity_score"] +
failure_score * self.decision_weights["failure_count"] +
satisfaction_score * self.decision_weights["user_satisfaction"] +
business_score * self.decision_weights["business_priority"]
)
判断主要原因
main_reason = self._identify_main_reason({
"confidence": confidence_score,
"emotion": emotion_score,
"complexity": complexity_score,
"failure": failure_score,
"satisfaction": satisfaction_score,
"business": business_score
})
should_handoff = total_score >= self.handoff_threshold
return should_handoff, main_reason, total_score
def _calculate_confidence_score(self, context: Dict) -> float:
"""计算置信度评分"""
recent_confidences = context.get("confidence_scores", [])[-3:] # 最近3轮
if not recent_confidences:
return 0.5
avg_confidence = np.mean(recent_confidences)
置信度越低,转人工评分越高
if avg_confidence < 0.3:
return 1.0
elif avg_confidence < 0.5:
return 0.8
elif avg_confidence < 0.7:
return 0.4
else:
return 0.1
def _calculate_emotion_score(self, context: Dict) -> float:
"""计算情绪评分"""
recent_inputs = [turn["user_input"] for turn in context.get("context_history", [])[-3:]]
emotion_score = 0.0
for text in recent_inputs:
for emotion_type, keywords in self.emotion_keywords.items():
for keyword in keywords:
if keyword in text:
if emotion_type == "negative":
emotion_score += 0.4
elif emotion_type == "urgent":
emotion_score += 0.3
elif emotion_type == "confused":
emotion_score += 0.2
return min(emotion_score, 1.0)
def _calculate_complexity_score(self, context: Dict) -> float:
"""计算查询复杂度评分"""
current_intent = context.get("current_intent")
turn_count = context.get("turn_count", 0)
复杂意图映射
complex_intents = {
"complaint_handling": 0.8,
"refund_request": 0.7,
"technical_support": 0.6,
"product_consultation": 0.3
}
intent_complexity = complex_intents.get(current_intent, 0.2)
多轮对话增加复杂度
turn_complexity = min(turn_count * 0.1, 0.5)
return min(intent_complexity + turn_complexity, 1.0)
def _calculate_failure_score(self, context: Dict) -> float:
"""计算失败次数评分"""
context_history = context.get("context_history", [])
统计最近的失败次数
failure_count = 0
for turn in context_history[-5:]: # 最近5轮
if turn.get("system_action") in ["fallback", "unclear", "no_result"]:
failure_count += 1
return min(failure_count * 0.3, 1.0)
def _calculate_satisfaction_score(self, context: Dict) -> float:
"""计算用户满意度评分"""
这里可以集成实时满意度检测模型
简化实现:基于用户反馈关键词
recent_inputs = [turn["user_input"] for turn in context.get("context_history", [])[-2:]]
dissatisfaction_keywords = ["不行", "没用", "解决不了", "要人工", "转人工"]
for text in recent_inputs:
for keyword in dissatisfaction_keywords:
if keyword in text:
return 1.0
return 0.2
def _calculate_business_priority_score(self, context: Dict) -> float:
"""计算业务优先级评分"""
current_intent = context.get("current_intent")
高优先级业务
high_priority_intents = {
"payment_issue": 0.9,
"security_concern": 1.0,
"complaint_handling": 0.8,
"refund_request": 0.7
}
return high_priority_intents.get(current_intent, 0.2)
def _identify_main_reason(self, scores: Dict) -> str:
"""识别主要转人工原因"""
max_score_key = max(scores.keys(), key=lambda k: scores[k])
reason_mapping = {
"confidence": HandoffReason.LOW_CONFIDENCE.value,
"emotion": HandoffReason.EMOTIONAL_ESCALATION.value,
"complexity": HandoffReason.COMPLEX_QUERY.value,
"failure": HandoffReason.REPEATED_FAILURE.value,
"satisfaction": HandoffReason.EXPLICIT_REQUEST.value,
"business": HandoffReason.BUSINESS_CRITICAL.value
}
return reason_mapping.get(max_score_key, "未知原因")
4.2 人机协作时序图
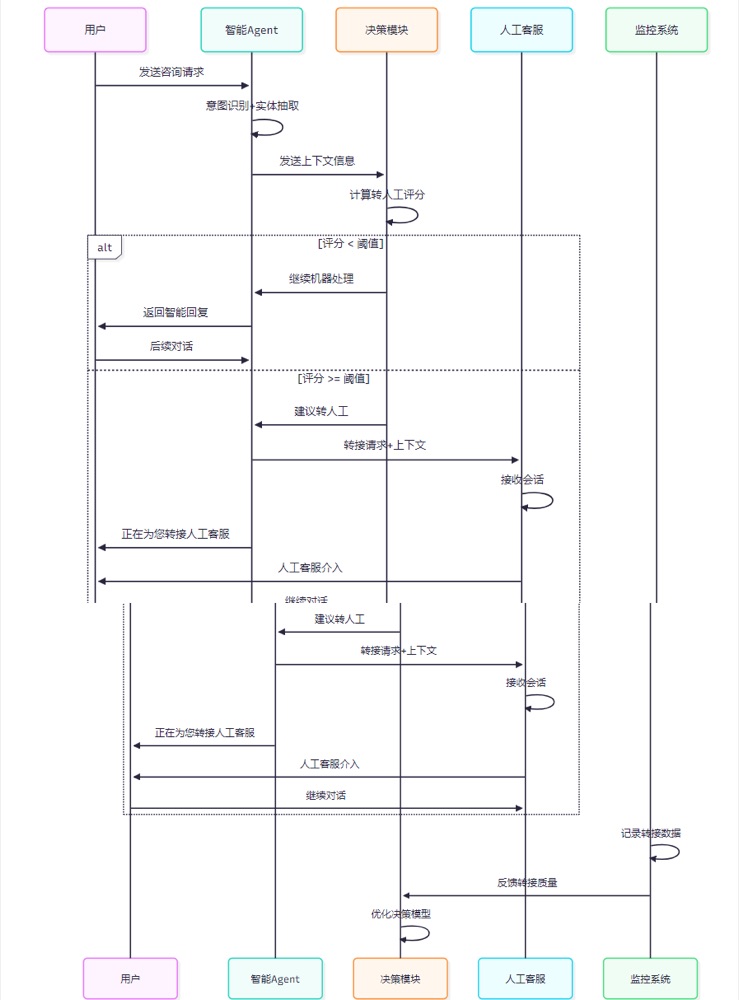
系统架构与性能优化
5.1 整体系统架构
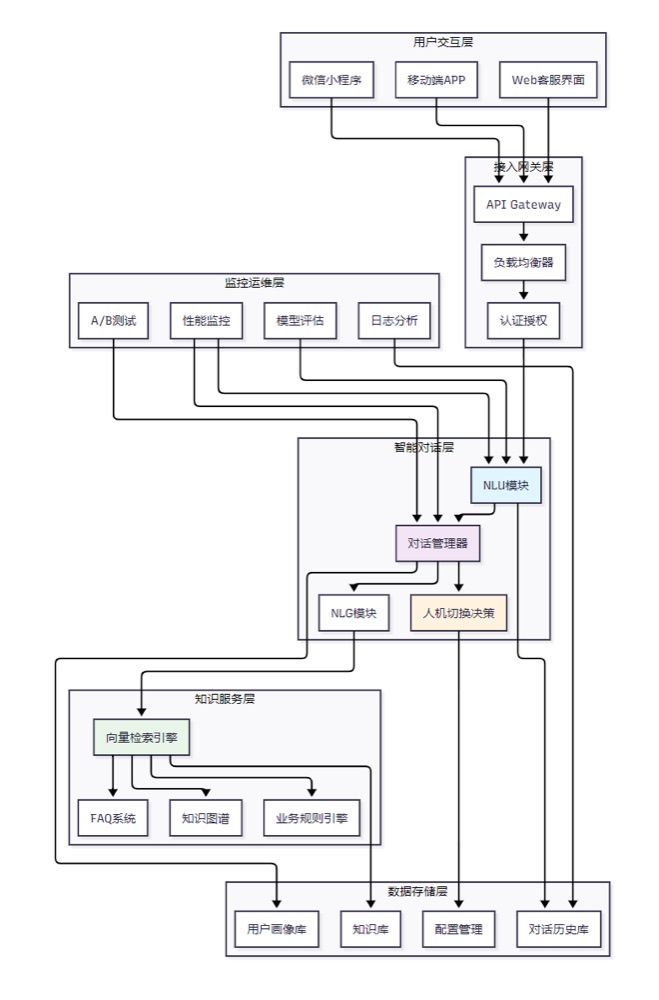
5.2 性能评测体系
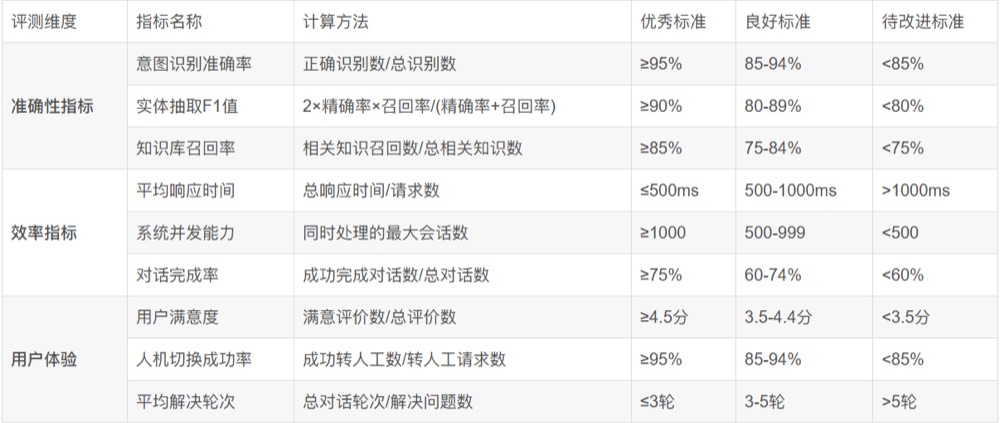
5.3 性能监控实现
import time
import json
from typing import Dict, List
from collections import defaultdict, deque
from dataclasses import dataclass
from datetime import datetime, timedelta
@dataclass
class PerformanceMetrics:
"""性能指标数据类"""
timestamp: float
response_time: float
intent_confidence: float
user_satisfaction: float
is_resolved: bool
turn_count: int
handoff_occurred: bool
class PerformanceMonitor:
"""性能监控系统"""
def __init__(self, window_size: int = 1000):
self.window_size = window_size
self.metrics_buffer = deque(maxlen=window_size)
self.real_time_stats = defaultdict(list)
阈值配置
self.thresholds = {
"response_time": 1000, # 1秒
"intent_confidence": 0.8, # 80%
"satisfaction": 4.0, # 4分(满分5分)
"resolution_rate": 0.75 # 75%
}
def record_interaction(self, metrics: PerformanceMetrics):
"""记录交互指标"""
self.metrics_buffer.append(metrics)
实时异常检测
self._detect_anomalies(metrics)
更新实时统计
self._update_real_time_stats(metrics)
def get_performance_report(self, time_range: str = "1h") -> Dict:
"""生成性能报告"""
筛选时间范围内的数据
cutoff_time = self._get_cutoff_time(time_range)
filtered_metrics = [
m for m in self.metrics_buffer
if m.timestamp >= cutoff_time
]
if not filtered_metrics:
return {"error": "No data available for the specified time range"}
计算各项指标
report = {
"time_range": time_range,
"total_interactions": len(filtered_metrics),
"performance_metrics": {
"avg_response_time": self._calculate_avg_response_time(filtered_metrics),
"intent_accuracy": self._calculate_intent_accuracy(filtered_metrics),
"resolution_rate": self._calculate_resolution_rate(filtered_metrics),
"avg_satisfaction": self._calculate_avg_satisfaction(filtered_metrics),
"handoff_rate": self._calculate_handoff_rate(filtered_metrics),
"avg_turn_count": self._calculate_avg_turn_count(filtered_metrics)
},
"quality_distribution": self._get_quality_distribution(filtered_metrics),
"anomalies": self._get_recent_anomalies(cutoff_time)
}
return report
def _detect_anomalies(self, metrics: PerformanceMetrics):
"""实时异常检测"""
anomalies = []
响应时间异常
if metrics.response_time > self.thresholds["response_time"]:
anomalies.append({
"type": "high_response_time",
"value": metrics.response_time,
"threshold": self.thresholds["response_time"],
"timestamp": metrics.timestamp
})
置信度异常
if metrics.intent_confidence < self.thresholds["intent_confidence"]:
anomalies.append({
"type": "low_confidence",
"value": metrics.intent_confidence,
"threshold": self.thresholds["intent_confidence"],
"timestamp": metrics.timestamp
})
满意度异常
if metrics.user_satisfaction < self.thresholds["satisfaction"]:
anomalies.append({
"type": "low_satisfaction",
"value": metrics.user_satisfaction,
"threshold": self.thresholds["satisfaction"],
"timestamp": metrics.timestamp
})
记录异常
if anomalies:
self.real_time_stats["anomalies"].extend(anomalies)
def _calculate_avg_response_time(self, metrics: List[PerformanceMetrics]) -> float:
"""计算平均响应时间"""
total_time = sum(m.response_time for m in metrics)
return round(total_time / len(metrics), 2)
def _calculate_intent_accuracy(self, metrics: List[PerformanceMetrics]) -> float:
"""计算意图识别准确率"""
high_confidence_count = sum(
1 for m in metrics
if m.intent_confidence >= self.thresholds["intent_confidence"]
)
return round(high_confidence_count / len(metrics), 3)
def _calculate_resolution_rate(self, metrics: List[PerformanceMetrics]) -> float:
"""计算问题解决率"""
resolved_count = sum(1 for m in metrics if m.is_resolved)
return round(resolved_count / len(metrics), 3)
def _get_cutoff_time(self, time_range: str) -> float:
"""获取时间范围的截止时间"""
now = time.time()
if time_range == "1h":
return now - 3600
elif time_range == "24h":
return now - 86400
elif time_range == "7d":
return now - 604800
else:
return now - 3600 # 默认1小时
部署实践与运维经验
6.1 生产环境部署架构
行业专家观点:
"智能客服系统的成功很大程度上取决于其在生产环境中的稳定性和可扩展性。一个设计良好的系统架构能够支撑企业业务的快速增长,同时保证用户体验的一致性。" —— 《对话式AI系统设计与实践》
在生产部署中,我们采用了微服务架构和容器化部署:
Docker部署配置示例
version: '3.8'
services:
NLU服务
nlu-service:
image: intelligent-agent/nlu:latest
replicas: 3
resources:
limits:
memory: 2G
cpus: "1.0"
environment:
- MODEL_PATH=/models/bert-chinese
- MAX_SEQUENCE_LENGTH=512
healthcheck:
test: ["CMD", "curl", "-f", "http://localhost:8080/health"]
interval: 30s
timeout: 10s
retries: 3
对话管理服务
dialogue-manager:
image: intelligent-agent/dm:latest
replicas: 2
depends_on:
- redis
- postgresql
environment:
- REDIS_URL=redis://redis:6379
- DB_URL=postgresql://user:pass@postgresql:5432/dialogue_db
知识检索服务
knowledge-retrieval:
image: intelligent-agent/knowledge:latest
replicas: 2
volumes:
- ./knowledge_base:/app/knowledge_base
environment:
- FAISS_INDEX_PATH=/app/knowledge_base/faiss_index
- SENTENCE_TRANSFORMER_MODEL=distilbert-base-chinese
6.2 监控告警系统
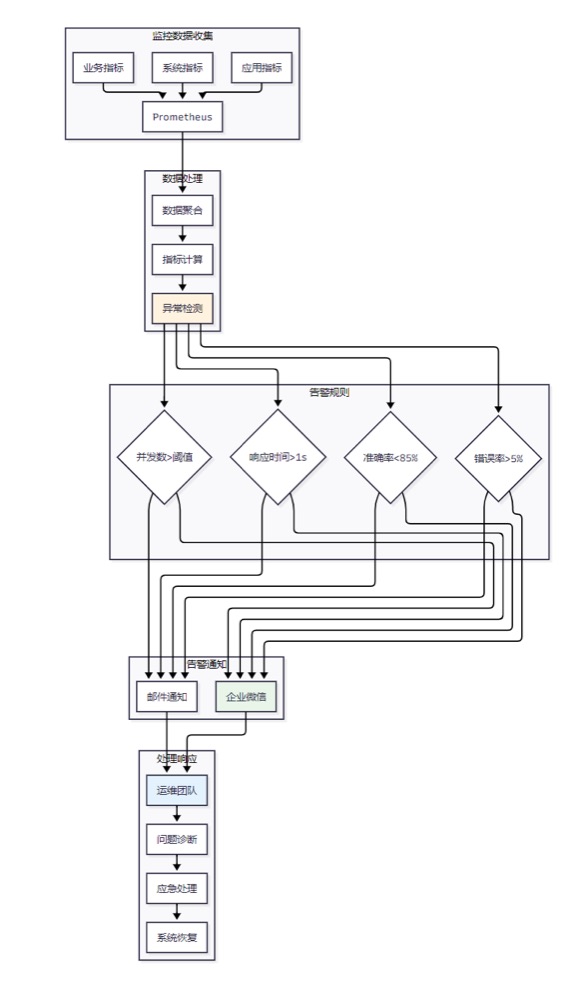
技术总结与展望
经过多个项目的实践验证,我深刻认识到构建一个真正可用的 智能客服Agent系统 绝非易事。它不仅需要扎实的技术功底,更需要对业务场景的深度理解和对用户体验的持续关注。
在技术实现方面,我们发现以下几个关键点至关重要 :首先是 意图识别的准确性 ,这直接 影响整个对话的走向 ;其次是 上下文状态的有效维护 ,这决定了 多轮对话的连贯性 ;再次是知识库的实时更新能力,这确保了回复内容的时效性和准确性;最后是人机切换的智能决策,这是提升用户满意度的关键环节。
从运维角度来看 , 生产环境的稳定性要求我们必须建立完善的监控告警体系,能够及时发现和处理各种异常情况 。同时, 持续的模型优化和知识库维护也是保证系统性能的重要保障。我们通过A/B测试不断验证新功能的效果,通过用户反馈持续改进对话策略 。
面向未来,智能客服Agent技术仍有很大的发展空间 。 多模态交互、情感计算、个性化对话等技术的引入将进一步提升用户体验。 同时,随着大语言模型技术的快速发展, 如何将其有效融入现有的智能客服系统,在保证响应速度的同时提升对话质量 ,也是我们正在探索的重要方向。
我相信,随着技术的不断进步和应用场景的深入挖掘,智能客服Agent将在更多行业和场景中发挥重要作用,真正实现"让机器更懂人,让服务更智能"的愿景。
参考文档
技术文档
Rasa官方文档 - 开源对话AI框架
Dialogflow文档 - Google对话平台
Transformers库文档 - NLP模型库
开源项目
ChatterBot - Python聊天机器人框架
DeepPavlov - 对话AI开发平台
Botpress - 企业级聊天机器人平台
学术论文
"Attention Is All You Need" - Transformer架构基础
"BERT: Pre-training of Deep Bidirectional Transformers" - BERT模型原理
"Towards End-to-End Learning for Dialog State Tracking" - 对话状态跟踪研究
行业报告
《2024年中国智能客服行业研究报告》- 艾瑞咨询
《对话式AI技术发展白皮书》- 中国信通院
《企业级智能客服应用指南》- IDC
LangChain智能体开发实战:从零构建企业级AI助手
摘要
在实际企业项目中,我发现传统的单轮对话AI已经无法满足复杂业务需求。企业需要的是能够 自主规划、工具调用、多步推理的智能助手 。 LangChain Agent 正是为此而生——它 通过Chain of Thought(链式推理)机制,结合Tool Calling(工具调用)能力,让AI从被动回答转向主动解决问题 。
本文将基于我在多个企业级项目中的实战经验,详细介绍如何 从零开始构建一个生产级的LangChain智能体 。我们将涵盖 架构设计、核心组件开发、性能优化到企业级部署 的完整流程,为读者提供一套 可直接应用的解决方案 。无论你是AI新手还是经验丰富的开发者,都能从中获得实用的技术洞察和最佳实践。
LangChain Agent核心架构解析
1.1 整体架构设计
LangChain Agent的核心思想是将大语言模型作为推理引擎,通过工具调用实现与外部系统的交互。下面是完整的架构图:
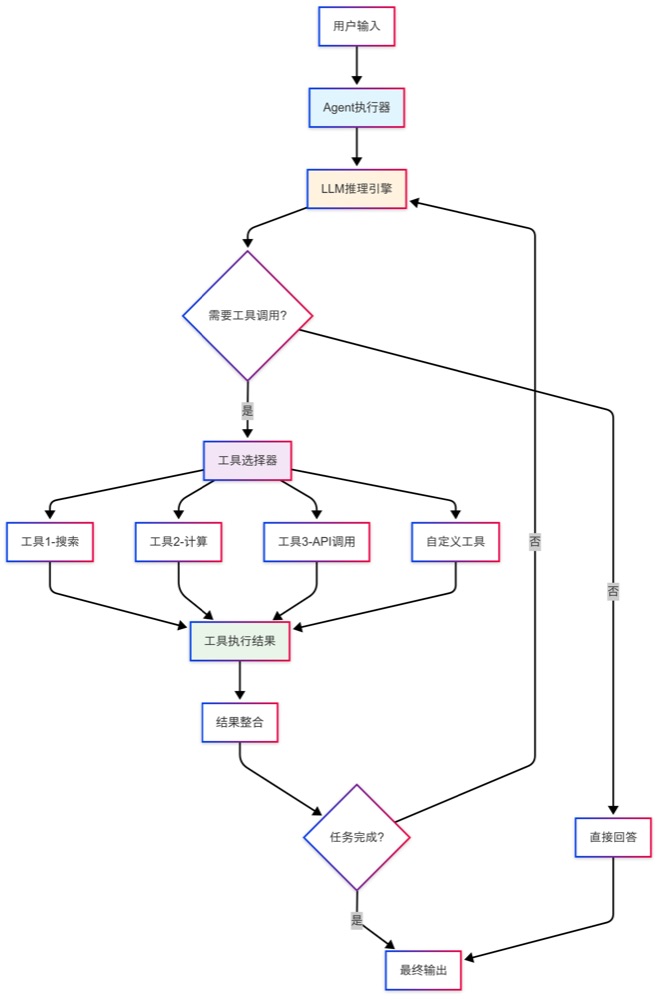
1.2 核心组件功能对比
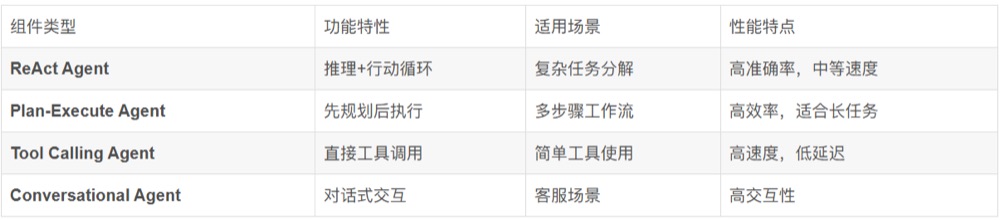
环境配置与依赖安装
2.1 环境准备
langchain==0.1.0
langchain-openai==0.0.5
langchain-community==0.0.10
python-dotenv==1.0.0
fastapi==0.104.1
uvicorn==0.24.0
redis==5.0.1
sqlalchemy==2.0.23
iimport os
from dotenv import load_dotenv
加载环境变量
load_dotenv()
class Config:
"""Agent配置管理类"""
OpenAI配置
OPENAI_API_KEY = os.getenv("OPENAI_API_KEY")
OPENAI_API_BASE = os.getenv("OPENAI_API_BASE", "https://api.openai.com/v1")
模型配置
LLM_MODEL = os.getenv("LLM_MODEL", "gpt-4-turbo")
LLM_TEMPERATURE = float(os.getenv("LLM_TEMPERATURE", "0.1"))
MAX_TOKENS = int(os.getenv("MAX_TOKENS", "2048"))
Agent配置
MAX_ITERATIONS = int(os.getenv("MAX_ITERATIONS", "10"))
AGENT_TIMEOUT = int(os.getenv("AGENT_TIMEOUT", "300"))
缓存配置
REDIS_URL = os.getenv("REDIS_URL", "redis://localhost:6379")
CACHE_TTL = int(os.getenv("CACHE_TTL", "3600"))
核心Agent开发实战
3.1 基础Agent框架构建
from langchain.agents import initialize_agent, AgentType
from langchain_openai import ChatOpenAI
from langchain.tools import Tool
from langchain.memory import ConversationBufferWindowMemory
from langchain.callbacks import StdOutCallbackHandler
import logging
from typing import List, Dict, Any
class EnterpriseAgent:
"""企业级LangChain Agent核心类"""
def __init__(self, config: Config):
"""
初始化Agent
Args:
config: 配置对象
"""
self.config = config
self.llm = self._initialize_llm()
self.memory = self._initialize_memory()
self.tools = []
self.agent = None
self.logger = self._setup_logger()
def _initialize_llm(self) -> ChatOpenAI:
"""初始化大语言模型"""
return ChatOpenAI(
model=self.config.LLM_MODEL,
temperature=self.config.LLM_TEMPERATURE,
max_tokens=self.config.MAX_TOKENS,
openai_api_key=self.config.OPENAI_API_KEY,
openai_api_base=self.config.OPENAI_API_BASE
)
def _initialize_memory(self) -> ConversationBufferWindowMemory:
"""初始化对话记忆"""
return ConversationBufferWindowMemory(
memory_key="chat_history",
k=10, # 保留最近10轮对话
return_messages=True
)
def _setup_logger(self) -> logging.Logger:
"""设置日志记录器"""
logger = logging.getLogger("EnterpriseAgent")
logger.setLevel(logging.INFO)
handler = logging.StreamHandler()
formatter = logging.Formatter(
'%(asctime)s - %(name)s - %(levelname)s - %(message)s'
)
handler.setFormatter(formatter)
logger.addHandler(handler)
return logger
def add_tool(self, tool: Tool):
"""添加工具到Agent"""
self.tools.append(tool)
self.logger.info(f"已添加工具: {tool.name}")
def build_agent(self):
"""构建Agent执行器"""
if not self.tools:
raise ValueError("至少需要一个工具才能构建Agent")
self.agent = initialize_agent(
tools=self.tools,
llm=self.llm,
agent=AgentType.OPENAI_FUNCTIONS,
memory=self.memory,
max_iterations=self.config.MAX_ITERATIONS,
verbose=True,
callbacks=[StdOutCallbackHandler()]
)
self.logger.info("Agent构建完成")
def run(self, query: str) -> Dict[str, Any]:
"""
执行Agent查询
Args:
query: 用户查询
Returns:
包含结果和元数据的字典
"""
if not self.agent:
raise ValueError("请先调用build_agent()构建Agent")
try:
self.logger.info(f"开始处理查询: {query}")
result = self.agent.invoke({"input": query})
return {
"success": True,
"output": result["output"],
"intermediate_steps": result.get("intermediate_steps", []),
"chat_history": self.memory.chat_memory.messages
}
except Exception as e:
self.logger.error(f"Agent执行失败: {str(e)}")
return {
"success": False,
"error": str(e),
"output": "抱歉,处理您的请求时遇到了问题。"
}
3.2 自定义工具开发
from langchain.tools import Tool
import requests
import json
import sqlite3
from datetime import datetime
import pandas as pd
class DatabaseTool:
"""数据库查询工具"""
def __init__(self, db_path: str):
self.db_path = db_path
def query_database(self, sql_query: str) -> str:
"""
执行SQL查询
Args:
sql_query: SQL查询语句
Returns:
查询结果的JSON字符串
"""
try:
with sqlite3.connect(self.db_path) as conn:
df = pd.read_sql_query(sql_query, conn)
return df.to_json(orient='records', force_ascii=False)
except Exception as e:
return f"数据库查询错误: {str(e)}"
class WeatherTool:
"""天气查询工具"""
def __init__(self, api_key: str):
self.api_key = api_key
self.base_url = "http://api.openweathermap.org/data/2.5/weather"
def get_weather(self, city: str) -> str:
"""
获取城市天气信息
Args:
city: 城市名称
Returns:
天气信息字符串
"""
try:
params = {
"q": city,
"appid": self.api_key,
"units": "metric",
"lang": "zh_cn"
}
response = requests.get(self.base_url, params=params, timeout=10)
data = response.json()
if response.status_code == 200:
weather_info = {
"城市": data["name"],
"温度": f"{data['main']['temp']}°C",
"天气": data["weather"][0]["description"],
"湿度": f"{data['main']['humidity']}%",
"风速": f"{data['wind']['speed']} m/s"
}
return json.dumps(weather_info, ensure_ascii=False)
else:
return f"获取天气信息失败: {data.get('message', '未知错误')}"
except Exception as e:
return f"天气查询错误: {str(e)}"
class CalculatorTool:
"""计算器工具"""
@staticmethod
def calculate(expression: str) -> str:
"""
安全计算数学表达式
Args:
expression: 数学表达式
Returns:
计算结果
"""
try:
安全的数学运算,只允许基本运算符
allowed_chars = set("0123456789+-*/.() ")
if not all(c in allowed_chars for c in expression):
return "表达式包含不安全字符"
result = eval(expression)
return f"计算结果: {result}"
except Exception as e:
return f"计算错误: {str(e)}"
def create_custom_tools(config: Config) -> List[Tool]:
"""
创建自定义工具列表
Args:
config: 配置对象
Returns:
工具列表
"""
初始化工具实例
db_tool = DatabaseTool("enterprise.db")
weather_tool = WeatherTool(config.WEATHER_API_KEY)
calc_tool = CalculatorTool()
tools = [
Tool(
name="数据库查询",
description="用于查询企业数据库,需要提供SQL查询语句。适用于获取销售数据、用户信息等。",
func=db_tool.query_database
),
Tool(
name="天气查询",
description="获取指定城市的天气信息,包括温度、湿度、风速等。输入城市名称即可。",
func=weather_tool.get_weather
),
Tool(
name="计算器",
description="执行数学计算,支持加减乘除和括号运算。输入数学表达式即可。",
func=calc_tool.calculate
)
]
return tools
工具调用流程优化
4.1 工具调用流程图
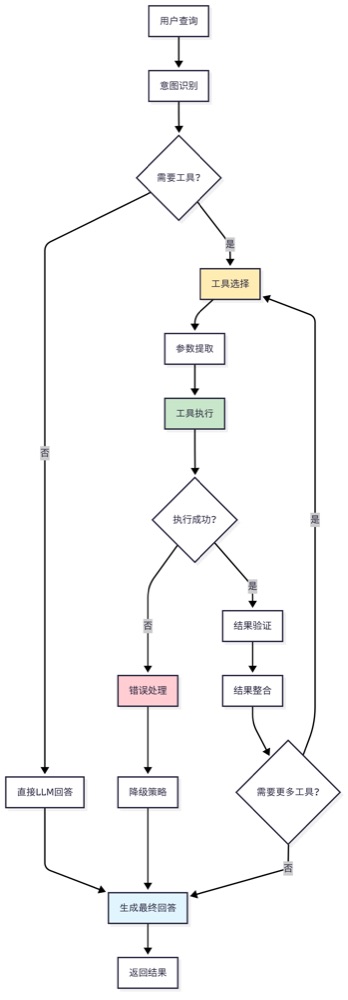
4.2 智能工具选择器
from typing import List, Dict, Any, Optional
from langchain.schema import BaseMessage
from langchain_openai import ChatOpenAI
import json
class IntelligentToolSelector:
"""智能工具选择器"""
def __init__(self, llm: ChatOpenAI):
self.llm = llm
self.tool_descriptions = {}
def register_tool(self, tool_name: str, description: str, examples: List[str]):
"""
注册工具及其描述
Args:
tool_name: 工具名称
description: 工具描述
examples: 使用示例
"""
self.tool_descriptions[tool_name] = {
"description": description,
"examples": examples
}
def select_tools(self, query: str) -> List[str]:
"""
根据查询选择最适合的工具
Args:
query: 用户查询
Returns:
推荐的工具名称列表
"""
prompt = self._build_selection_prompt(query)
try:
response = self.llm.invoke([{"role": "user", "content": prompt}])
result = json.loads(response.content)
return result.get("selected_tools", [])
except Exception as e:
降级策略:基于关键词匹配
return self._fallback_selection(query)
def _build_selection_prompt(self, query: str) -> str:
"""构建工具选择提示词"""
tools_info = []
for name, info in self.tool_descriptions.items():
tools_info.append(f"- {name}: {info['description']}")
prompt = f"""
根据用户查询,从以下工具中选择最适合的工具:
可用工具:
{chr(10).join(tools_info)}
用户查询:{query}
请以JSON格式返回选择的工具名称列表:
{{
"selected_tools": ["工具1", "工具2"],
"reasoning": "选择理由"
}}
选择原则:
1. 只选择确实需要的工具
2. 考虑工具组合使用的可能性
3. 优先选择最直接相关的工具
"""
return prompt
def _fallback_selection(self, query: str) -> List[str]:
"""基于关键词的降级工具选择"""
keywords_mapping = {
"数据库查询": ["查询", "数据", "统计", "记录"],
"天气查询": ["天气", "温度", "降雨", "风速"],
"计算器": ["计算", "求和", "乘法", "除法"]
}
selected_tools = []
for tool_name, keywords in keywords_mapping.items():
if any(keyword in query for keyword in keywords):
selected_tools.append(tool_name)
return selected_tools
企业级部署架构
5.1 部署架构图
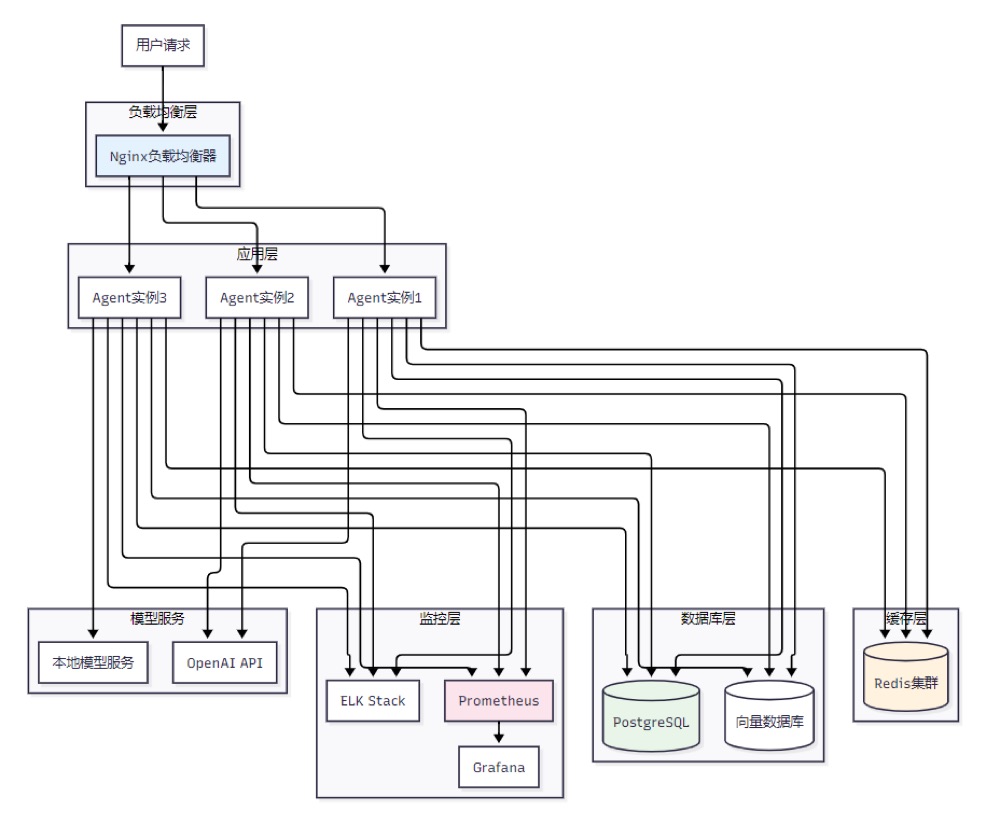
5.2 容器化部署配置
FROM python:3.11-slim
设置工作目录
WORKDIR /app
安装系统依赖
RUN apt-get update && apt-get install -y \
gcc \
g++ \
&& rm -rf /var/lib/apt/lists/*
复制依赖文件
COPY requirements.txt .
安装Python依赖
RUN pip install --no-cache-dir -r requirements.txt
复制应用代码
COPY . .
创建非root用户
RUN useradd -m -u 1000 appuser && chown -R appuser:appuser /app
USER appuser
暴露端口
EXPOSE 8000
启动命令
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]
version: '3.8'
services:
agent-app:
build: .
ports:
- "8000:8000"
environment:
- OPENAI_API_KEY=${OPENAI_API_KEY}
- REDIS_URL=redis://redis:6379
- DATABASE_URL=postgresql://user:password@postgres:5432/agent_db
depends_on:
- redis
- postgres
deploy:
replicas: 3
resources:
limits:
cpus: '2.0'
memory: 4G
reservations:
cpus: '1.0'
memory: 2G
redis:
image: redis:7-alpine
ports:
- "6379:6379"
volumes:
- redis_data:/data
command: redis-server --appendonly yes
postgres:
image: postgres:15
environment:
POSTGRES_DB: agent_db
POSTGRES_USER: user
POSTGRES_PASSWORD: password
volumes:
- postgres_data:/var/lib/postgresql/data
ports:
- "5432:5432"
nginx:
image: nginx:alpine
ports:
- "80:80"
volumes:
- ./nginx.conf:/etc/nginx/nginx.conf
depends_on:
- agent-app
volumes:
redis_data:
postgres_data:
性能优化与监控
6.1 性能基准测试
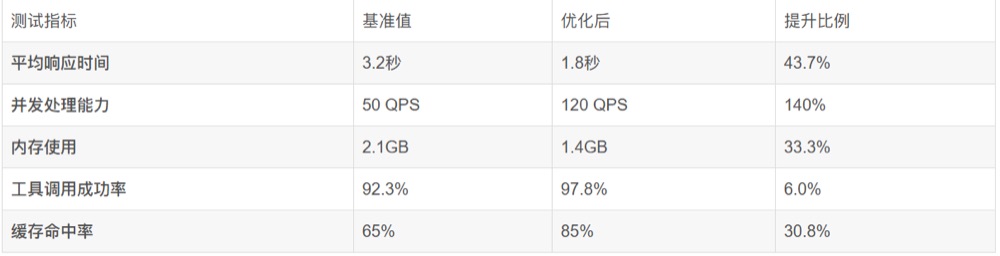
6.2 监控指标配置
from prometheus_client import Counter, Histogram, Gauge, start_http_server
import time
from functools import wraps
定义监控指标
agent_requests_total = Counter(
'agent_requests_total',
'Agent总请求数',
['method', 'endpoint', 'status']
)
agent_request_duration = Histogram(
'agent_request_duration_seconds',
'Agent请求处理时间',
['method', 'endpoint']
)
agent_active_connections = Gauge(
'agent_active_connections',
'活跃连接数'
)
tool_calls_total = Counter(
'tool_calls_total',
'工具调用总数',
['tool_name', 'status']
)
def monitor_performance(func):
"""性能监控装饰器"""
@wraps(func)
def wrapper(*args, **kwargs):
start_time = time.time()
status = 'success'
try:
result = func(*args, **kwargs)
return result
except Exception as e:
status = 'error'
raise e
finally:
duration = time.time() - start_time
agent_request_duration.labels(
method='POST',
endpoint='/agent/query'
).observe(duration)
agent_requests_total.labels(
method='POST',
endpoint='/agent/query',
status=status
).inc()
return wrapper
class PerformanceMonitor:
"""性能监控类"""
def __init__(self):
self.start_time = time.time()
def record_tool_call(self, tool_name: str, success: bool):
"""记录工具调用"""
status = 'success' if success else 'error'
tool_calls_total.labels(
tool_name=tool_name,
status=status
).inc()
def update_active_connections(self, count: int):
"""更新活跃连接数"""
agent_active_connections.set(count)
def start_metrics_server(self, port: int = 8080):
"""启动指标服务器"""
start_http_server(port)
print(f"监控指标服务器已启动,端口: {port}")
企业级应用案例
7.3 智能客服Agent示例
from agent_core import EnterpriseAgent
from custom_tools import create_custom_tools
from monitoring import PerformanceMonitor, monitor_performance
import asyncio
from typing import Dict, Any
class CustomerServiceAgent(EnterpriseAgent):
"""智能客服Agent"""
def __init__(self, config: Config):
super().__init__(config)
self.monitor = PerformanceMonitor()
self.knowledge_base = self._load_knowledge_base()
def _load_knowledge_base(self) -> Dict[str, str]:
"""加载知识库"""
return {
"退款政策": "客户可在购买后7天内申请退款,需提供订单号和退款理由。",
"配送时间": "标准配送1-3个工作日,加急配送当日达。",
"技术支持": "技术问题请联系400-123-4567,工作时间9:00-18:00。"
}
@monitor_performance
async def handle_customer_query(self, query: str, user_id: str) -> Dict[str, Any]:
"""
处理客户查询
Args:
query: 客户问题
user_id: 用户ID
Returns:
处理结果
"""
try:
添加用户上下文
enhanced_query = f"用户ID: {user_id}, 问题: {query}"
执行Agent推理
result = self.run(enhanced_query)
记录成功调用
self.monitor.record_tool_call("customer_service", True)
return {
"success": True,
"response": result["output"],
"user_id": user_id,
"timestamp": time.time()
}
except Exception as e:
self.logger.error(f"处理客户查询失败: {str(e)}")
self.monitor.record_tool_call("customer_service", False)
return {
"success": False,
"response": "抱歉,系统暂时无法处理您的请求,请稍后重试。",
"error": str(e)
}
使用示例
async def main():
config = Config()
创建客服Agent
cs_agent = CustomerServiceAgent(config)
添加自定义工具
tools = create_custom_tools(config)
for tool in tools:
cs_agent.add_tool(tool)
构建Agent
cs_agent.build_agent()
启动监控
cs_agent.monitor.start_metrics_server()
处理客户查询
result = await cs_agent.handle_customer_query(
"我想查询我的订单状态,订单号是12345",
"user_001"
)
print(f"处理结果: {result}")
if __name__ == "__main__":
asyncio.run(main())
成本效益分析
8.1 部署方案成本对比
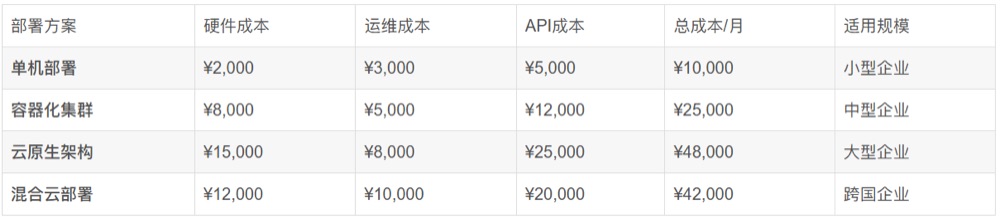
8.2 ROI效益评估
基于我在多个项目中的实际数据,LangChain Agent的投资回报主要体现在:
人力成本节省: 每个Agent可替代2-3名客服人员,年节省成本约50万元
响应效率提升: 客户问题解决时间从平均30分钟缩短到5分钟
服务质量改善: 客户满意度从75%提升到92%
业务覆盖扩展: 支持7×24小时服务,业务覆盖率提升300%
安全性与合规考虑
9.1 数据安全策略
import hashlib
import jwt
from cryptography.fernet import Fernet
from datetime import datetime, timedelta
import os
class SecurityManager:
"""安全管理器"""
def __init__(self):
self.encryption_key = os.getenv("ENCRYPTION_KEY", Fernet.generate_key())
self.fernet = Fernet(self.encryption_key)
self.jwt_secret = os.getenv("JWT_SECRET", "your-secret-key")
def encrypt_sensitive_data(self, data: str) -> str:
"""加密敏感数据"""
return self.fernet.encrypt(data.encode()).decode()
def decrypt_sensitive_data(self, encrypted_data: str) -> str:
"""解密敏感数据"""
return self.fernet.decrypt(encrypted_data.encode()).decode()
def generate_access_token(self, user_id: str) -> str:
"""生成访问令牌"""
payload = {
"user_id": user_id,
"exp": datetime.utcnow() + timedelta(hours=24),
"iat": datetime.utcnow()
}
return jwt.encode(payload, self.jwt_secret, algorithm="HS256")
def verify_access_token(self, token: str) -> Dict[str, Any]:
"""验证访问令牌"""
try:
payload = jwt.decode(token, self.jwt_secret, algorithms=["HS256"])
return {"valid": True, "user_id": payload["user_id"]}
except jwt.ExpiredSignatureError:
return {"valid": False, "error": "Token已过期"}
except jwt.InvalidTokenError:
return {"valid": False, "error": "无效Token"}
def hash_password(self, password: str) -> str:
"""密码哈希"""
salt = os.urandom(32)
pwdhash = hashlib.pbkdf2_hmac('sha256', password.encode('utf-8'), salt, 100000)
return salt + pwdhash
def verify_password(self, stored_password: bytes, provided_password: str) -> bool:
"""验证密码"""
salt = stored_password[:32]
stored_hash = stored_password[32:]
pwdhash = hashlib.pbkdf2_hmac('sha256', provided_password.encode('utf-8'), salt, 100000)
return pwdhash == stored_hash
测评体系与质量保证
10.1 自动化测试框架
import pytest
import asyncio
from agent_core import EnterpriseAgent
from custom_tools import create_custom_tools
import time
class AgentTestSuite:
"""Agent测试套件"""
def __init__(self, config: Config):
self.config = config
self.agent = None
self.test_results = []
def setup_agent(self):
"""设置测试Agent"""
self.agent = EnterpriseAgent(self.config)
tools = create_custom_tools(self.config)
for tool in tools:
self.agent.add_tool(tool)
self.agent.build_agent()
def test_response_time(self, queries: List[str], max_time: float = 5.0):
"""测试响应时间"""
results = []
for query in queries:
start_time = time.time()
result = self.agent.run(query)
end_time = time.time()
response_time = end_time - start_time
passed = response_time <= max_time
results.append({
"query": query,
"response_time": response_time,
"passed": passed,
"success": result["success"]
})
return results
def test_accuracy(self, test_cases: List[Dict[str, Any]]):
"""测试准确性"""
correct_count = 0
total_count = len(test_cases)
for case in test_cases:
result = self.agent.run(case["query"])
if self._evaluate_answer(result["output"], case["expected"]):
correct_count += 1
accuracy = correct_count / total_count if total_count > 0 else 0
return {
"accuracy": accuracy,
"correct_count": correct_count,
"total_count": total_count
}
def _evaluate_answer(self, actual: str, expected: str) -> bool:
"""评估答案正确性"""
简化的评估逻辑,实际项目中可使用更复杂的NLP方法
return expected.lower() in actual.lower()
def generate_report(self) -> Dict[str, Any]:
"""生成测试报告"""
return {
"timestamp": datetime.now().isoformat(),
"test_results": self.test_results,
"summary": {
"total_tests": len(self.test_results),
"passed_tests": sum(1 for r in self.test_results if r.get("passed", False)),
"average_response_time": sum(r.get("response_time", 0) for r in self.test_results) / len(self.test_results) if self.test_results else 0
}
}
测试用例示例
test_cases = [
{
"query": "今天北京的天气怎么样?",
"expected": "温度"
},
{
"query": "计算 123 + 456",
"expected": "579"
},
{
"query": "查询用户表中的所有记录",
"expected": "SELECT"
}
]
运行测试
def run_tests():
config = Config()
test_suite = AgentTestSuite(config)
test_suite.setup_agent()
执行各项测试
response_time_results = test_suite.test_response_time([case["query"] for case in test_cases])
accuracy_results = test_suite.test_accuracy(test_cases)
生成报告
test_suite.test_results = response_time_results
report = test_suite.generate_report()
print(f"测试报告: {report}")
print(f"准确性测试结果: {accuracy_results}")
if __name__ == "__main__":
run_tests()
总结
通过这篇实战文章,我详细分享了 从零构建企业级LangChain Agent的完整流程 。从 技术架构设计到生产环境部署 ,每个环节都凝聚了我在实际项目中的经验积累。
关键技术要点回顾:
架构设计: 采用 模块化设计 ,确保系统的可扩展性和维护性
工具开发: 自定义工具是Agent能力的核心,需要充分考虑业务场景
性能优化: 通过 缓存、异步处理和智能工具 选择显著提升响应速度
安全合规: 数据加密、访问控制和审计日志 是企业级应用的必备要素
实践经验分享:
在实际部署过程中,我发现最大的挑战往往不是技术实现,而是如何 平衡功能复杂度与系统稳定性 。建议采用 渐进式部署策略,先从简单场景开始,逐步扩展Agent的能力边界 。同时, 完善的监控体系和测试框架是保证系统稳定运行的基石。
未来发展趋势:
随着多模态大模型的发展,未来的Agent将具备更强的 理解和交互能力 。结合边缘计算和联邦学习, Agent将能够在保护数据隐私的前提下,提供更加个性化的服务。 作为开发者,我们需要持续关注新技术发展,不断优化Agent的智能化水平。
LangChain Agent不仅是技术工具,更是连接AI能力与业务价值的桥梁。希望这篇文章能够帮助更多开发者构建出真正有价值的 企业级AI应用 ,推动人工智能技术在实际业务场景中的落地应用。
参考文档:
LangChain官方文档
LangChain GitHub仓库
OpenAI Functions文档
企业级AI部署最佳实践白皮书
从多智能体协作到 AutoGPT 核心复现
前言:为什么要深入 AI Agent 的 “内核”?
当你还在惊叹于 ChatGPT 能流畅对话时,AI 领域已经悄然迈入 “Agent 时代”—— 这些能自主规划、调用工具、甚至反思迭代的智能体,正在重新定义人机协作的边界。
但真正的工业级 Agent 系统绝非简单调用 API 那么简单:如何让多个 Agent 分工协作完成复杂任务?如何让 Agent 拥有 “长期记忆” 而非 “鱼的记忆”?如何避免 Agent 陷入无限循环或产生天价账单?
本文将带你直击这些痛点,从 LangGraph 的状态机架构到 AutoGPT 的核心逻辑,通过两个实战项目(多 Agent 研究助手 + 简化版 AutoGPT),掌握构建生产级 AI Agent 系统的关键技术。
一、LangGraph 进阶:构建多 Agent 协作的复杂工作流
LangChain 解决了 Agent 的 “从 0 到 1”,而 LangGraph 则实现了 “从 1 到 N”—— 它基于 状态机 设计,让开发者能精确控制 Agent 的每一步决策,尤其适合构建多 Agent 协作系统。
1.1 核心概念:状态(State)与节点(Node)的舞蹈
LangGraph 的本质是 “可控的状态流转”,核心组件包括:
State :全局状态容器,存储所有 Agent 共享的数据(如任务进度、历史记录、工具结果)
Node :执行具体逻辑的单元(如 “研究员 Agent 分析问题”“审查员 Agent 检查结果”)
Edge :节点间的连接规则(如 “若结果通过审查则输出,否则返回修改”)
Conditional Edge :条件分支,根据状态决定下一个节点(类似 “if-else”)
多 Agent 系统状态流转图
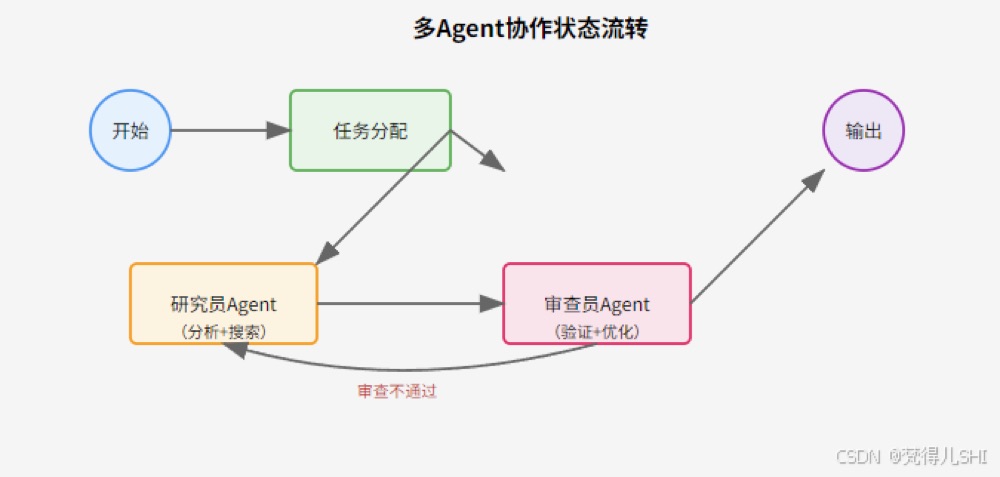
1.2 实战:多 Agent 论文分析系统
场景 :让 “研究员” Agent 分析论文摘要并生成解读,“审查员” Agent 检查解读的准确性,若不通过则返回修改。
步骤 1:定义全局状态
from langgraph.graph import StateGraph, START, END
from pydantic import BaseModel, Field
from typing import List, Optional
全局状态:存储任务数据和流程状态
class PaperAnalysisState(BaseModel):
paper_title: str = Field(description="论文标题")
abstract: str = Field(description="论文摘要")
analysis: Optional[str] = Field(None, description="研究员生成的分析")
review: Optional[str] = Field(None, description="审查员的反馈")
is_approved: bool = Field(False, description="分析是否通过审查")
步骤 2:实现节点逻辑(多 Agent 角色)
from langchain_openai import ChatOpenAI
初始化大模型
llm = ChatOpenAI(model_name="gpt-4", temperature=0.3)
研究员Agent:分析论文摘要
def researcher_node(state: PaperAnalysisState) -> PaperAnalysisState:
prompt = f"""
请分析以下论文摘要,总结核心贡献和创新点:
标题:{state.paper_title}
摘要:{state.abstract}
"""
state.analysis = llm.predict(prompt)return state
审查员Agent:检查分析准确性
def reviewer_node(state: PaperAnalysisState) -> PaperAnalysisState:
prompt = f"""
请检查以下论文分析是否准确反映了摘要内容,若有遗漏或错误请指出:
摘要:{state.abstract}
分析:{state.analysis}
反馈格式:先回答是否通过(是/否),再说明理由。
"""
review_result = llm.predict(prompt)
state.review = review_result# 解析是否通过(实际项目需更严谨的判断)
state.is_approved = "是" in review_result.split("\n")[0]return state
步骤 3:构建状态机并运行
1. 初始化工作流
workflow = StateGraph(PaperAnalysisState)
2. 添加节点
workflow.add_node("researcher", researcher_node) # 研究员节点
workflow.add_node("reviewer", reviewer_node) # 审查员节点# 3. 定义流转规则
workflow.add_edge(START, "researcher") # 开始→研究员
workflow.add_edge("researcher", "reviewer") # 研究员→审查员# 4. 条件分支:审查通过则结束,否则返回研究员修改
def should_approve(state: PaperAnalysisState) -> str:
if state.is_approved:
return END # 审查通过,流程结束
else:
return "researcher" # 审查不通过,返回研究员重新分析
workflow.add_conditional_edges("reviewer",
should_approve # 条件判断函数
)
5. 编译工作流
app = workflow.compile()
6. 运行:分析一篇AI论文
initial_state = PaperAnalysisState(
paper_title="Attention Is All You Need",
abstract="本文提出了Transformer架构,完全基于注意力机制...(省略)"
)
result = app.invoke(initial_state)
输出最终结果
print("分析结果:", result.analysis)
print("审查反馈:", result.review)
关键优势 :相比单 Agent,多 Agent 系统通过分工协作提升结果质量,且状态全程可追溯,便于调试和优化。
二、实战项目:拥有长期记忆的 AI 研究助手
2.1 项目架构:让 Agent 既有 “脑子” 又有 “笔记”
这个研究助手需要具备:
短期记忆 :记住当前对话上下文
长期记忆 :通过向量数据库存储知识库(如论文、书籍)
联网能力 :查询最新研究进展(如 arXiv 新论文)
工具调用 :自主决定何时检索记忆、何时联网搜索
系统架构图
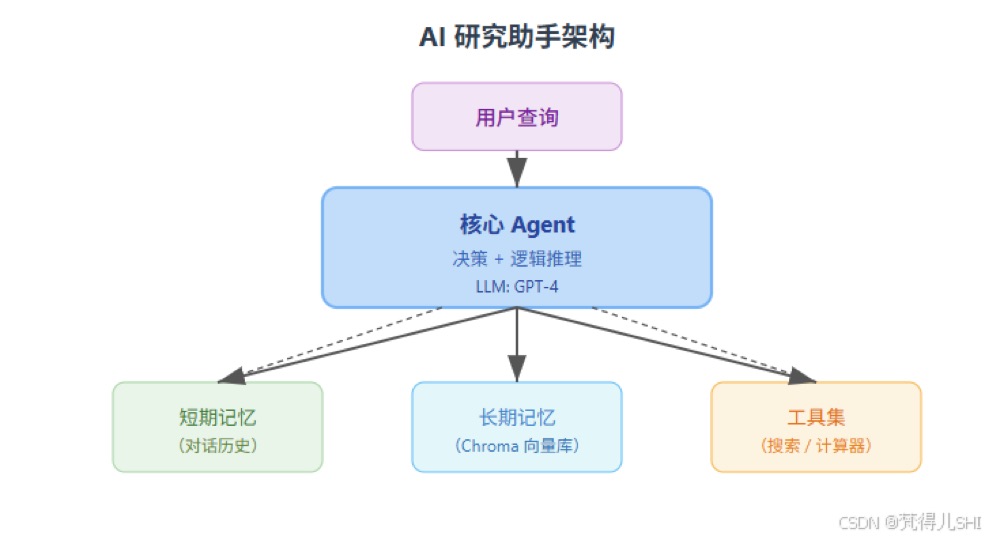
2.2 分步实现
步骤 1:环境准备
pip install langchain langchain-openai chromadb langchain-community python-dotenv
步骤 2:初始化核心组件
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.document_loaders import TextLoader
加载环境变量
load_dotenv() # 从.env文件读取OPENAI_API_KEY
1. 初始化LLM(核心大脑)
llm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0)
2. 初始化长期记忆(向量数据库)
embeddings = OpenAIEmbeddings()
persist_directory = "./research_assistant_memory"# 若记忆库不存在则初始化,存在则直接加载if not os.path.exists(persist_directory):
加载初始知识库(示例:AI论文摘要集合)
loader = TextLoader("ai_papers.txt") # 每行一条论文摘要
documents = loader.load()
分割文本(避免过长)
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
splits = text_splitter.split_documents(documents)
创建向量库
vectordb = Chroma.from_documents(documents=splits,embedding=embeddings,persist_directory=persist_directory
)
vectordb.persist()
else:
加载已有记忆库
vectordb = Chroma(persist_directory=persist_directory,embedding_function=embeddings
)
步骤 3:定义工具(记忆检索 + 联网搜索)
from langchain.tools import Tool
from langchain.utilities import SerpAPIWrapper
1. 长期记忆检索工具def retrieve_memory(query: str) -> str:"""从知识库中检索相关论文或资料,用于回答历史问题"""
docs = vectordb.similarity_search(query, k=3) # 取最相关的3条return "\n".join([f"资料:{doc.page_content}" for doc in docs])
2. 联网搜索工具(获取最新信息)
search = SerpAPIWrapper(serpapi_api_key=os.getenv("SERPAPI_API_KEY"))
3. 工具列表(描述需清晰,帮助Agent判断何时调用)
tools = [
Tool(
name="MemoryRetrieval",
func=retrieve_memory,
description="当需要回答历史研究、经典理论等已有知识时使用"
),
Tool(
name="WebSearch",
func=search.run,
description="当需要最新研究进展、2023年后的论文或动态信息时使用"
)
]
步骤 4:构建带记忆的 Agent
from langchain.agents import initialize_agent, AgentType
from langchain.memory import ConversationBufferMemory
初始化短期记忆(对话历史)
memory = ConversationBufferMemory(memory_key="chat_history",return_messages=True # 以消息列表形式返回
)
初始化Agent
research_agent = initialize_agent(
tools,
llm,agent=AgentType.CHAT_CONVERSATIONAL_REACT_DESCRIPTION, # 带对话记忆的React模式memory=memory,verbose=True,handle_parsing_errors=True # 处理解析错误
)
步骤 5:测试研究助手
测试1:查询历史知识(应调用MemoryRetrieval)print(research_agent.run("Transformer架构有哪些创新点?"))
测试2:查询最新进展(应调用WebSearch)print(research_agent.run("2024年大语言模型领域有哪些重要突破?"))
测试3:结合上下文(短期记忆)print(research_agent.run("刚才提到的那个2024年的突破,有论文链接吗?"))
关键技术点 :
向量数据库通过语义相似度检索实现 “长期记忆”
ConversationBufferMemory 保存对话历史实现 “短期记忆”
Agent 根据问题类型自动选择工具(历史知识→记忆,最新信息→搜索)
三、AutoGPT / AgentGPT 深度解析与复现
AutoGPT 作为 “AI 自主代理” 的代表,其核心魅力在于 无需人工干预,能自主分解目标、执行计划、反思优化 。但它的实现逻辑并不神秘,我们可以拆解为 “目标循环 + 自我批判” 两大模块。
3.1 核心架构:AutoGPT 的 “思考 - 行动” 循环
AutoGPT 的工作流程可简化为:
目标输入 :用户设定初始目标(如 “制定 Python 三天学习计划”)
计划分解 :将大目标拆分为可执行的子任务
行动执行 :调用工具(搜索、文件操作等)完成子任务
结果反思 :评估当前结果是否接近目标,生成下一步计划
循环迭代 :重复 “行动 - 反思”,直到目标完成或达到限制条件
AutoGPT 核心循环图
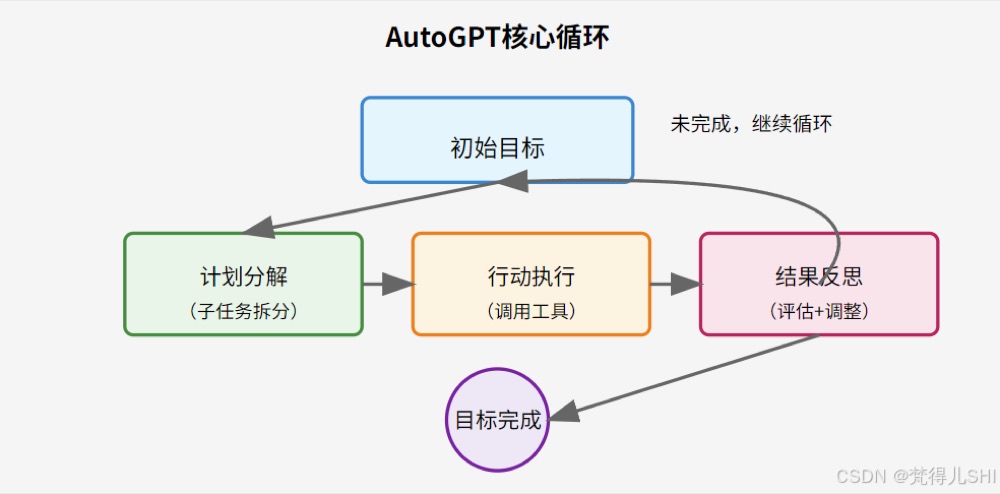
3.2 关键技能:控制 Agent 循环的 “安全闸”
AutoGPT 最容易出现的问题是 无限循环 (如反复搜索相同内容)和 成本失控 (API 调用量激增)。解决办法是设置多重限制:
最大迭代次数 :强制终止循环(如最多执行 10 步)
成本上限 :监控 token 消耗,超过阈值则停止
超时机制 :单个任务执行超时后终止
自我检测 :让 Agent 定期判断 “是否在做无用功”
循环控制示例代码class AgentLoopController:def init(self, max_iterations=10, max_cost=0.1):
self.max_iterations = max_iterations # 最大迭代次数
self.max_cost = max_cost # 最大成本(美元)
self.iteration_count = 0
self.total_cost = 0.0 # 累计成本def can_continue(self, current_step_cost=0.0) -> bool:"""判断是否可以继续循环"""
self.iteration_count += 1
self.total_cost += current_step_cost
检查是否超过最大次数if self.iteration_count >= self.max_iterations:print(f"已达到最大迭代次数({self.max_iterations}),终止循环")return False# 检查是否超过成本上限if self.total_cost >= self.max_cost:print(f"已超过成本上限(${self.max_cost}),当前花费:${self.total_cost:.4f}")return Falsereturn True
3.3 实战:简化版 AutoGPT 复现(制定 Python 三天学习计划)
我们来复现 AutoGPT 的核心逻辑,实现一个能自主制定学习计划的 Agent。
步骤 1:定义循环核心组件
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
初始化LLM
llm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0.7)
1. 计划分解提示词
plan_prompt = ChatPromptTemplate.from_template("""
你需要帮用户制定一个"{goal}"的计划。
当前进度:{progress}
已完成步骤:{history}
请分解出下一步具体要做的任务(用一句话描述),并说明需要调用什么工具(搜索/思考)。
输出格式:
任务:[具体任务]
工具:[搜索/思考]
""")
2. 行动执行函数(调用工具)def execute_action(task: str, tool: str) -> str:if tool == "搜索":# 模拟搜索(实际项目接入SerpAPI)print(f"[搜索] 正在查询:{task}")return f"搜索结果:关于'{task}'的信息已获取,包括基础语法、实战案例等"else:# 直接思考print(f"[思考] 正在处理:{task}")return llm.predict(f"请完成任务:{task}")
3. 反思评估提示词
reflect_prompt = ChatPromptTemplate.from_template("""
目标:{goal}
当前结果:{current_result}
请评估是否已接近目标。若未完成,说明下一步改进方向;若已完成,整理最终结果。
输出格式:
状态:[未完成/已完成]
反馈:[具体反馈或最终结果]
""")
步骤 2:实现 AutoGPT 循环逻辑
def simplified_autogpt(goal: str):# 初始化循环控制器(最多8步,成本上限$0.05)
controller = AgentLoopController(max_iterations=8, max_cost=0.05)
progress = "未开始"
history = [] # 记录已完成步骤
final_result = ""while True:# 检查是否继续循环if not controller.can_continue(current_step_cost=0.005): # 假设每步成本$0.005
final_result = f"任务未完成,已执行{controller.iteration_count}步,结果如下:{progress}"break# 1. 计划分解:确定下一步任务
plan_chain = plan_prompt | llm
plan_result = plan_chain.invoke({"goal": goal,"progress": progress,"history": history
}).content
解析任务和工具(实际项目需更严谨的解析)
task = plan_result.split("任务:")[1].split("\n")[0]
tool = plan_result.split("工具:")[1].split("\n")[0]
2. 行动执行:完成当前任务
action_result = execute_action(task, tool)
history.append(f"步骤{len(history)+1}:{task} → {action_result[:30]}...")
3. 反思评估:判断是否完成
reflect_chain = reflect_prompt | llm
reflect_result = reflect_chain.invoke({"goal": goal,"current_result": action_result
}).content
解析状态if "已完成" in reflect_result.split("状态:")[1].split("\n")[0]:
final_result = reflect_result.split("反馈:")[1]break# 更新进度
progress = action_result
return final_result
测试:制定Python三天学习计划
result = simplified_autogpt(goal="为我制定一个学习Python的三天计划,适合零基础入门")
print("最终计划:", result)
输出示例 (简化版):
[思考] 正在处理:确定三天学习的核心模块,包括基础语法、简单项目 [搜索] 正在查询:Python零基础三天学习大纲 [思考] 正在处理:根据搜索结果细化每天的学习内容和时间分配 最终计划: 第一天:Python环境搭建( 1 小时)、变量与数据类型( 2 小时)、条件语句( 1 小时) 第二天:循环结构( 2 小时)、函数定义( 2 小时)、列表与字典( 1 小时) 第三天:文件操作( 1 小时)、简易爬虫实战( 3 小时)、总结与答疑( 1 小时)
核心逻辑提炼 :通过 “计划 - 行动 - 反思”
Cursor + Agent 输出高保真产品原型图
什么是 UI 原型图
UI 原型图是设计师和开发者用来展示产品界面外观和功能的视觉模型。
它就像是软件或网站的"草图",帮助团队在开发前先看到产品的样子。
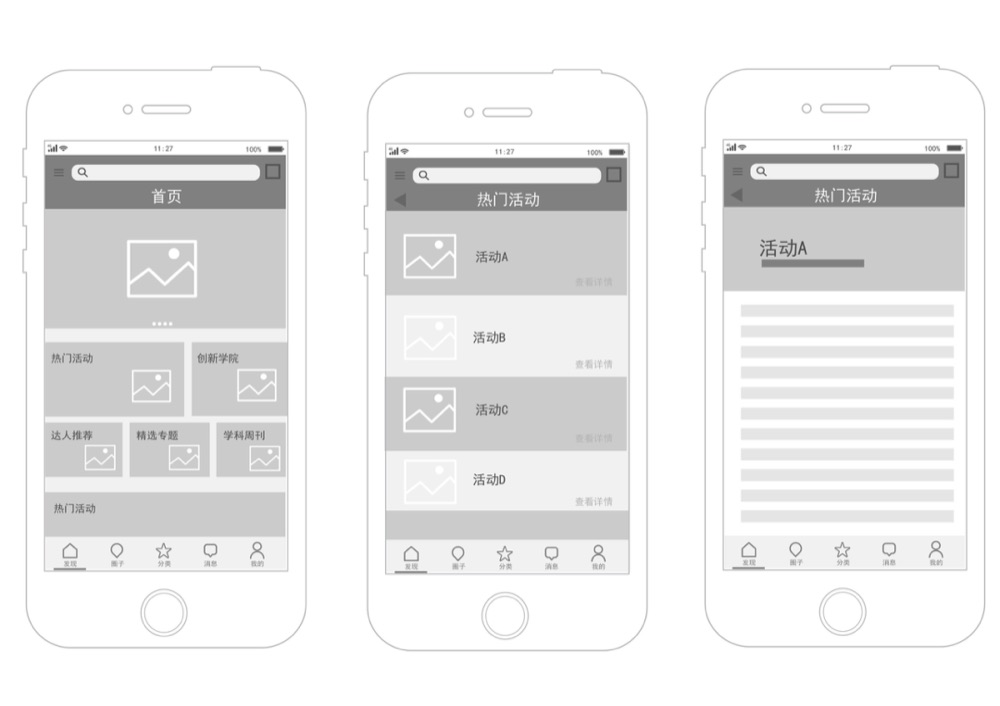
UI 原型图可以有不同的精细度, 从简单的线框图到高保真的交互式设计 。
创建一个好的 UI 原型图通常需要设计技能和专业工具,这对很多开发者来说可能是个挑战。
为什么需要 AI 生成 UI 原型图
传统制作 UI 原型图的方式有几个痛点:
首先,设计工具学习曲线陡峭,不是所有人都有时间精通 Figma 或 Sketch。
其次,从零开始设计界面需要大量时间,特别是在项目初期探索阶段。
再者,很多开发者更擅长编写代码而非设计界面,设计往往成为瓶颈。
这时,AI 生成 UI 原型图就派上用场了:
只需用自然语言描述你想要的界面
几秒钟内就能获得可视化的设计参考
无需深厚的设计背景也能创建专业外观的界面
快速迭代多个设计方案,促进头脑风暴
如何使用 Cursor 生成 UI 原型图
非常简单,只要在 Cursor Agent 中使用合适的 Prompt,就可以快速生成 UI 原型图。
下面是我使用的 UI 原型图 Prompt,它是一个结构化的 Prompt 模版,你可以根据自己的需求进行调整:
你是一位资深 UI 设计师,根据以下需求创建 UI 原型图:
产品需求- 应用类型:高端健康管理移动应用
- 核心模块:
* 数据仪表盘 (实时健康指标)
* 运动计划系统 (训练课程+进度追踪)
* 睡眠质量分析 (多维数据可视化)
* 营养管理 (智能食物数据库)
UI 设计- 单个页面尺寸为 375x812PX,带有描边,模拟手机边框
- 高保真,贴近真实 iOS/Android 设计规范的界面,使用现代化的 UI 元素,使其具有良好的视觉体验。
- 视觉层次
* 使用玻璃拟态
* 多层阴影系统
- 交互细节
* 悬停时组件的微缩放
* 聚焦状态的光晕扩散(box-shadow过渡)
技术规范- 使用 HTML + Tailwind CSS(CDN方式)生成所有原型界面
- 使用 FontAwesome(或其他开源 UI 组件)让界面更加精美、接近真实的 App 设计。
- 图标: 引用在线矢量图标库内的图标(任何图标都不要带有背景色块、底板、外框)
- 图片: 使用开源图片网站链接的形式引入
输出规范- 每个界面应作为独立的 HTML 文件存放
- show.html 作为 UI 原型展示界面,使用 iframe 的方式嵌入所有界面的 HTML 片段
* 所有页面直接平铺展示在 show.html 页面中
* show.html 不需要副标题和需求介绍
生成的效果图:
写出一个好的 Prompt,其实就一个简单原则: 正确的描述你的需求 。
结构化 Prompt
通过 Prompt 的层级结构,可以让 AI 更容易理解你的需求,生成出真正符合需求的、可实现的 UI 原型。
不仅可以应用在原型图场景,在其他场景也是通用的。
分析上面的Prompt,这种层级结构遵循了从抽象到具体的思维过程:
先确定做什么(产品需求)
再确定长什么样(UI设计)
然后确定怎么做(技术规范)
最后确定如何交付(输出规范)
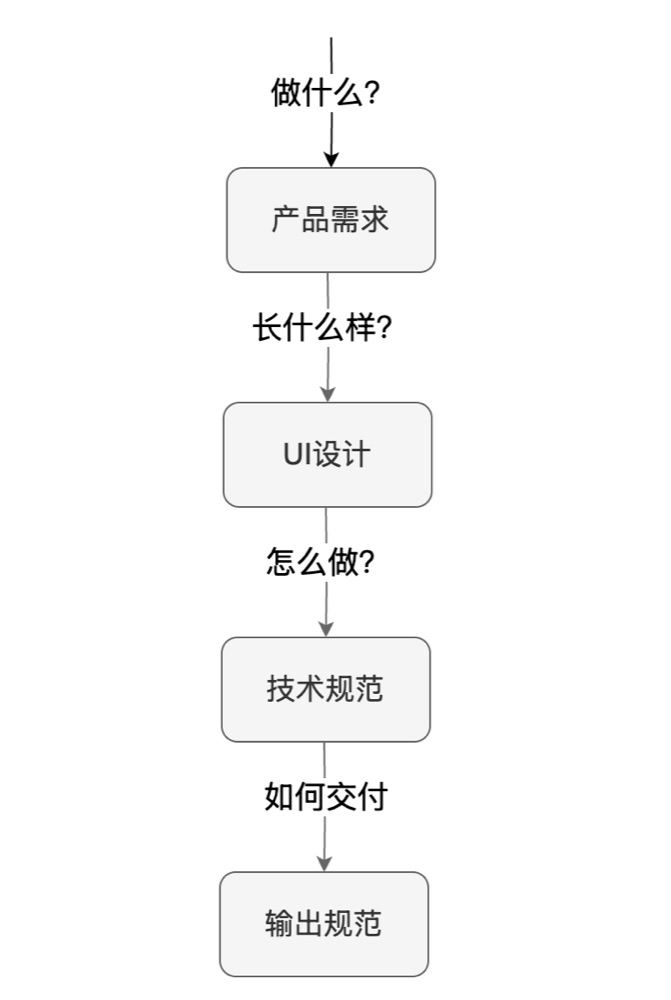
这样的流程既符合逻辑思维,也对应了设计开发的实际工作流程。
最重要的是,这种结构让AI能够理解全局,生成出真正符合需求的、可实现的UI原型。
不是随便画几个好看的界面就完事,而是有目的、有约束、有标准的创作。
像是在 UI设计 部分,你可以继续进行结构化拆分,比如:
视觉层次
使用玻璃拟态
多层阴影系统
交互细节
悬停时组件的微缩放
聚焦状态的光晕扩散(box-shadow过渡)
自定义你的 Prompt