LLM大模型
3 章 · 约 27 千字
目录
从零开始搞定 LLM 搭建全流程
本文完整展示ai大语言模型的搭建全流程,以及在实际应用中的能力边界、如何更好的使用。
一、模型输入
1.1 模型输入
首先我们要知道的是,输入给到大语言模型的是一个组合文本(称之为 上下文 )。
包括:
系统提示词(对应"你是个智能助手,回答时要可爱些"这种)
可用工具列表描述(对应Function Call能力)
历史对话(包括之前的问题和回答)
用户最新提问
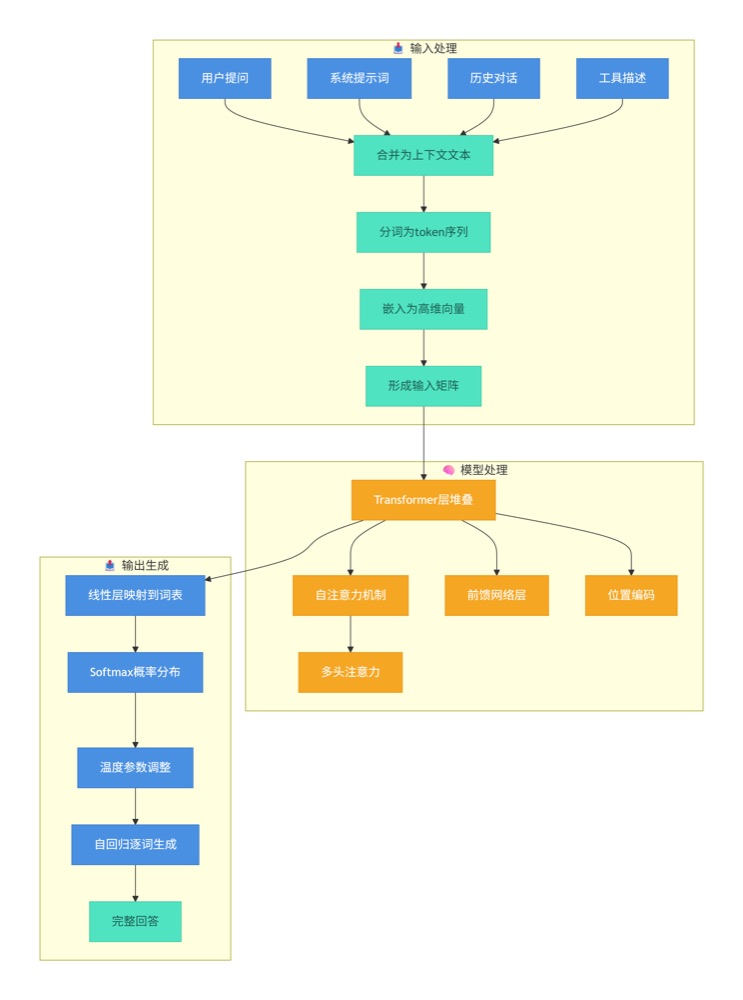
示例:
如下为目前共识的OpenAI API协议输入示例,这些都将合并作为大模型调用的一次输入(省略了部分工具描述信息,仅做理解):
messages = [
{"role": "system", "content": "你是个智能助手,回答时要可爱些"}, // 系统提示词
{"role": "user", "content": "你好"}, // 历史提问
{"role": "assistant", "content": "你好,有什么能帮到你呀"}, // 历史回答
{"role": "user", "content": "查询下今日天气"}, // 最新提问
]
tools = [{"type":"function","function":{"name":"get_weather","description":"Get current weather information"}}]
敲黑板: 这部分需要理解的是输入实际是个文本,并且每次调用大模型都是独立的,能够与用户互动是因为工程上在每次调用时将历史对话加了进去。因此在一轮对话中每次调用时输入的组合文本(即上下文)会越来越长,这点很重要。
1.2 分词与嵌入
理解了输入文本,那么文本如何实际转换为大模型计算时需要的矩阵呢(这里需要知道的是,大模型核心是进行大量的数学运算,主要是矩阵乘法),这里主要是分词和嵌入两步。
分词
相当于把文本"切碎"成更小的单元token。比如:
中文文本中,"北京"可能被切分为1个token,"的"也是1个token
英文,单词"unhappy"可能被拆成"un"和"happy"两个token
每个符号、数字都会单独处理作为一个token
需要注意的是这里分词的规则在不同的大模型里是不一样的,有的模型可能一个汉字平均1 token,有的可能平均要0.5 token。
嵌入
嵌入过程则更加精妙。模型通过一个可学习的嵌入矩阵,将每个token的数字ID转换为固定维度的向量。
如此,输入文本开始先转换为n个token,经过嵌入后转换为n个512维的向量,合并即为n×512的输入矩阵。
敲黑板: 这部分需要理解的是文本在给到模型计算之前会转换为token序列,这里对应token的长度n就是文本中“词”的数量,这里n就是最终输入的上下文长度。
1.3 上下文长度的限制
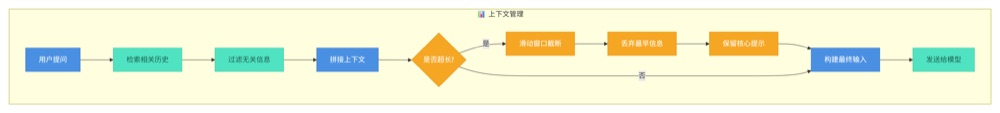
需要注意的是,目前大模型都会对上下文长度有严格限制,当给到的上下文长度超过限制大小时会直接报错(这里是对应DeepSeek V3开源代码的实现),不过大部分工程实践上在累计内容超过上下文窗口时,会自动丢弃最早的数据,保留最新的内容,确保总长度不超过模型的处理能力。
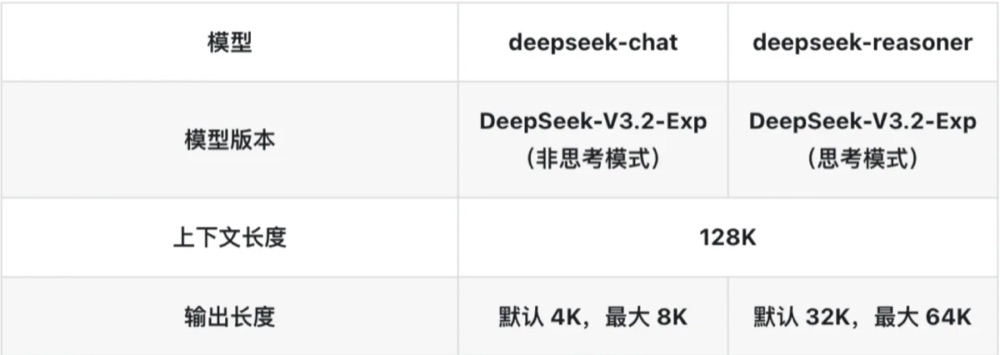
敲黑板: 上下文长度有限制,不能无限增加,而且需要注意的是这里上下文长度限制是包含输出长度的,即理论上最大的输入上下文长度为128k - 4k = 124k(以DeepSeek-Chat默认为例),为什么后面会解释。
通过这一系列精密的转换过程,人类的自然语言最终变成了模型能够进行数学计算的矩阵形式,为后续的理解和生成奠定了基础。
二、Transformer架构与自注意力机制
现在我们已经有了一个包含词义的输入矩阵,接下来就要进入大模型的核心计算环节——Transformer架构。这个架构的精髓在于自注意力机制,它让模型能够真正“理解”文本中各个词语之间的复杂关系。
2.1 自注意力
想象一下你阅读一段文字时,大脑会自动关注与当前理解最相关的词语,自注意力机制就是让模型实现类似的能力。
Q、K、V矩阵
每个输入token经过与上述三个不同的权重矩阵相乘,分别生成三个矩阵:
Query(Q)矩阵: 代表"我想要什么信息",用于主动询问其他token
Key(K)矩阵: 可以理解为"该token拥有什么信息",用于回应其他token的询问
Value(V)矩阵: 可以理解为该token的包含内容信息的多少
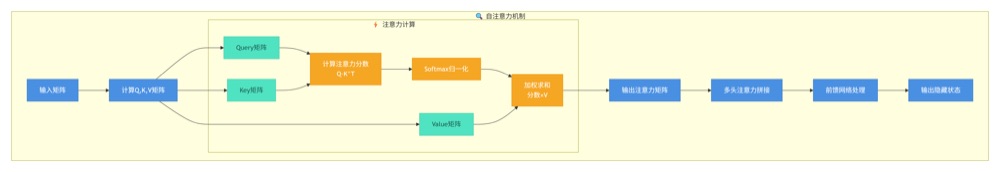
信息的三种角色
这三个矩阵可以理解为信息交流的三个角色:Q是提问者,K是应答者,V是实际要传递的内容。
计算注意力分数: 用当前token的Query和之前所有token的Key内积计算得到对应注意力分数,可以理解为当前token与之前token在这个注意力模块下的关联程度。分数越高,代表该部分信息越重要。
生成加权平均输出: 最后,用上一步得到的注意力分数作为权重,分别与之前所有token的Value相乘并求和得到最终的注意力信息(注:实际计算要复杂些,这里不做展开),这里可以理解为融合了之前所有序列上下文信息的新的向量。
经过上面的计算后,得到了每个token与上下文关联的信息,这个过程确保了模型的回复是基于整个上下文生成的,而不仅仅是孤立的最新问题。
敲黑板: 简单来讲,自注意力机制就是将每个token与之前所有token通过计算得到相关信息,需要着重理解的是最后一个token的注意力信息包含了整个上下文所有信息。
2.2 多头注意力
单一注意力机制可能不够全面,因此Transformer采用了多头注意力设计。
不同注意力头就像不同的“专家”,各自关注文本的不同方面,所有头的计算结果最终拼接在一起,通过线性变换融合成完整的输出。
这种设计让模型能够同时从多个角度理解文本,大大增强了表达能力。
2.3 前馈网络层
一个完整的Transformer层主要包括多头自注意力层以及前馈网络层(还有别的模块,偏技术细节不影响理解这里不做展开)。
理解过程
自注意力层: 相当于你听取了一场讨论,了解了每个人(每个词)的观点以及它们之间的关联。
前馈网络层: 相当于你回到自己的办公室,独自消化和深入思考刚才听到的所有信息,形成自己更深刻、更抽象的理解。
如此,一个 transformer 层结构可以简略表示为下图:
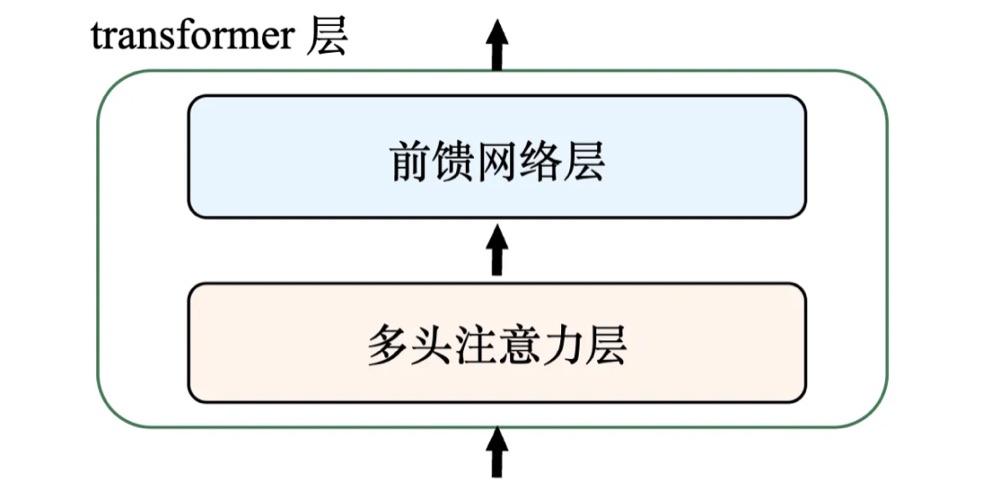
敲黑板: 实际上可以简单理解,通过注意力机制让模型能够学到利用并关联上下文信息,通过前馈网络层让模型能学到特征的进一步提取和转换。
2.4 大模型
都说大模型,大模型到底大在何处?
参数量
参数量是衡量模型复杂度的核心指标,Transformer架构的大模型通常拥有数百亿甚至数千亿参数,这么多参数都体现在哪?
以DeepSeek V3为例,其注意力层为潜在多头注意力层(MLA,这个是为了减少缓存的使用,不展开介绍),头数为128,对应有128个自注意力模块,
前馈网络层包括257个专家(包括一个共享专家,256个可选专家,这里可以理解为257个前馈网络层并行,这跟多头很类似,区别是这里专家是选择使用的),
然后这样的Transformer层在DeepSeek V3中有58层,还有3层无专家的Transformer层,共61层。
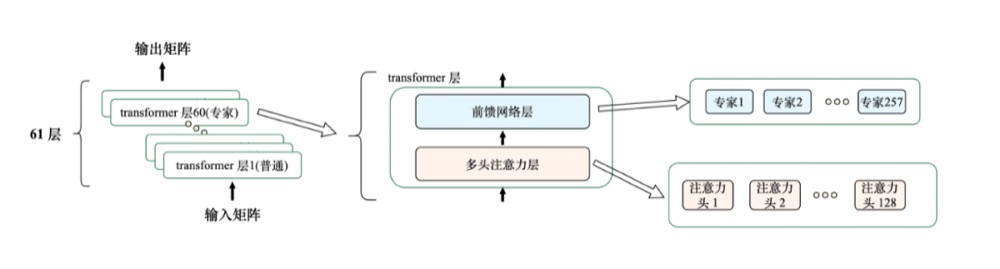
其中参数量主要由专家组成,一共14906个专家,每个专家有7168×2048×3 = 44,040,192个参数,一共有6564.6亿个参数,算上其他的参数,总共是6710亿。
训练量
大模型这么大的参数量,每个参数的取值都是逐渐调整的,训练数据要求非常大。
以DeepSeek V3为例,其预训练阶段就使用了14.8万亿token的数据集进行预训练,需要知道的是,大模型在训练时每条数据都不会只用来训练1次,而是训练多次。
三、模型输出
接下来需要完成最关键的一步:将这些抽象的高维向量“翻译”回人类能够理解的自然语言。
3.1 线性层
隐藏状态矩阵中的每个向量都浓缩了对应token的上下文信息,但这些向量仍然处于模型内部的表示空间。
为了生成人类可读的文字,模型需要通过线性层将这些向量映射到词汇表空间。
线性层将每个token对应的高维向量转换为一个长度等于词汇表大小的新向量。
如果词汇表包含5万个词,那么线性层的输出就是一个5万维的向量,每个维度对应词汇表中一个特定词的可能性得分。
因为我们输入时n个token,所以这里会得到n个向量,分别对应该位置下一个词的得分向量,在最终输出时使用最后一个。
3.2 Softmax
线性层输出的向量包含的是原始得分(raw scores),这些得分被称为logits。每个logits数组看起来可能像这样: [2.1, -0.3, 1.8, ..., 0.02] ,其中每个数值代表对应词汇的"倾向程度"。
核心作用
Softmax的核心作用是将logits转换为标准的概率分布:
将所有logits值映射到0到1之间
确保所有概率值的总和恰好等于1
保持数值间的相对大小关系(得分高的词概率仍然高)
经过Softmax处理后,原来的logits数组变成了类似 [0.15, 0.02, 0.25, ..., 0.001] 的概率分布,每个数值明确表示对应词汇被选中的概率。
到这里大模型终于能返回一个词了,具体输出哪个呢,一般是根据上面的概率分布来随机抽取,每个位置的值对应输出词表中这个位置的词的概率。
需要注意的是,一般情况这个概率分布会比较集中,即某个词或某几个词的概率很大,其他很小。
3.3 自回归生成
经过上面那么复杂的计算,我们发现大模型只输出了一个词,那么完整输出对应的后面的词是怎么来的呢。
生成过程
这里大模型生成文本的过程是自回归的,这意味着模型不是一次性生成整个回答,而是像人类思考一样,一个词一个词地逐步构建:
初始预测: 基于完整的输入上下文,模型预测第一个词的概率分布(即上面的过程)
词选择: 根据概率分布选择一个词(可能是概率最高的词,也有可能是概率低的词)
迭代扩展: 将已生成的词作为新的输入的一部分,预测下一个词
重复直到结束: 持续这个过程,直到生成完整的回答或达到长度限制
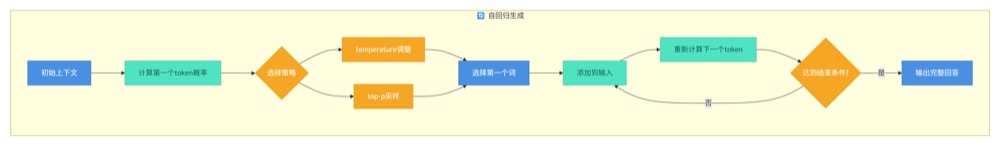
这种“滚雪球”式的生成方式确保了前后文的连贯性,每个新词的产生都基于之前所有已生成的内容。
敲黑板: 大模型经过Transformer层提取的特征在经过计算后最终输出的是词表中每个词的概率分布,根据相应概率抽取最终输出的词。接下来将生成的词添加到输入后继续上述流程接着预测输出,整体上是一个一个token输出。这也是为什么上下文限制要包括输出长度的原因。
3.4 生成策略
对于概率分布,模型有多种选择策略,一般是按照概率分布进行抽取。在创造性的场景中可能体现为每次的输出结果不同,这对诗词创造等比较有用。
目前来说,模型一般会提供两个参数来给用户用以调整,这在我们平时使用的元宝等平台都会开放给用户修改。
temperature:
调整模型原始输出的概率分布(logits)的"尖锐"或"平滑"程度,通过改变概率分布的形状来控制随机性。可以理解为值小于1时原本概率高的调整后会更高,进而更容易被选择,等于0时就变成了只选择概率最高的词
top-p:
像一个动态的候选词筛选器,从概率最高的词开始累加,仅从累积概率达到阈值p的最小候选集合中采样。可以理解为在抽取时只从概率较高的前几个词中抽取
在实际应用中可以结合使用场景来调整参数以达到我们期望的性能,这里不做展开。
注:这里在DeepSeek V3的代码中只看到了temperature参数的支持。
四、位置编码和长文本外推
到这里我们已经谈得上大致理解了大模型从输入到输出的基本工作原理,不过在介绍中刻意忽略了一个细节,斟酌再三还是决定单独介绍这部分,因为这个非常重要!
4.1 位置编码
上面我们提到了Transformer架构核心在自注意力机制,通过计算每个token和其他token的相关性得分来获取相关信息。
其中核心计算是token之间的矩阵运算,然而这种计算方式丢失了位置信息,要知道"我咬狗"和"狗咬我"这种相同词组成的短句含义是相差甚远的。
因此引入了位置编码的概念,将位置信息添加在输入矩阵中,一般分为绝对位置编码和相对位置编码。
绝对位置编码:
给每个位置一个"唯一身份证",Transformer架构原版的实现。核心是通过编码的方式将位置信息添加到每个token的输入向量中,缺点是当输入长度超过模型训练长度时,模型没见过对应位置编码,会导致性能急剧下降。
相对位置编码:
关注的相对距离而不是绝对距离。在计算注意力分数时,注入两个词之间的相对距离信息。
这里只介绍目前主流方案 RoPE(旋转位置编码) ,核心思想是将每个token的位置信息转换为对应高维空间的角度信息。
相比于绝对编码,相对编码中模型学到的是相对位置关系,即使输入长度超过模型训练长度时,模型也能复用训练中学到的相对位置规律。
敲黑板: 核心是通过巧妙的数学编码将相对位置信息加在了自注意力得分的计算上,有个很重要的细节是,在编码上通过设计使得相对位置越远的token间注意力得分会相对较低。
4.2 长文本外推
但是,即使相对编码比绝对编码在长文本时更具优势,但是其学到的相对位置关系的距离也是有限的,当输入长度过长时,其性能也会下降,这时候就需要外推策略。
为了保证模型对长输入文本也能有个较高的性能,研究人员相继提出了多种方法。这里简单介绍:
一种是 基于插值的方式
基本思想是对于训练时的0-4k这样的距离,在实际使用时将0-32k压缩到0-4k的表示(模型更熟悉这个范围的距离)。
当然这个方式不够灵活,目前业界较优的方案是YaRN,可以理解为对不同长度的相对距离进行不同的插值策略。
一种是 基于选择策略的方式。
基本思想是对超长文本,在计算时不再计算与全局所有token的注意力关系,避免超长文本计算的耗时过长。
比较典型的方案是滑动窗口计算的方式,每个词只关注固定窗口长度中相邻词的信息,也有通过某些策略从全局中挑选部分区间进行计算,整体方案是有损的,不过通过设计尽量降低对模型效果的影响。
4.3 长文本训练
也许你会疑惑如果大模型学到了相对距离的概念,那理论上距离变长也应该可以的才对。
这就要提到前面说的大模型的大在训练量了。
模型的性能直接取决于训练量,在4k长度下训练的模型即使学会了相对位置的概念,到了32k甚至更长的距离时表现也会变差,因为缺乏训练。
(这可以类比于,在人机模式打了很多把游戏,你的能力有了显著提升,并且已经学会了技能的使用和对线的技巧,但接下来让你跟真人高玩对线,用的技能和英雄还是那些,但就是打不过)
既然如此,为什么不直接用长文本进行训练呢?这里主要有两个原因:
计算复杂度与成本爆炸
基于前面的自注意力机制计算的原理,我们知道每个token都要和上下文中前面的所有token进行注意力计算,因此上下文越长,计算量和中间结果就会越多,这直接与长度的平方成正比。因此在大训练量的需求下,直接对长文本进行训练的资源和时间消耗都是非常大的。
训练数据的稀缺性和质量难题
即使是互联网时代,长文本的训练数据仍然本身较少,大部分还是短文。并且高质量的可训练数据更为稀缺。
短文本预训练 + 长文本微调(主流方法)
目前主流方式都是在短文本下进行大量训练得到基础模型,然后通过少量的长文本数据进行微调。
阶段一(基础预训练): 在大量高质量的较短文本(如2K、4K、8K)上完成核心的语言模型预训练。这个阶段让模型学会基本的语言能力、常识和推理逻辑。成本相对可控。
阶段二(长度扩展微调): 使用外推技术,在相对较少的长文本数据上对模型进行微调。这里DeepSeek V3是先扩展至32k,然后扩展至128k。
为什么有效?
因为模型在阶段一已经学会了"如何思考"。阶段二只是教它"如何在更长的上下文中运用这种思考能力"。这比从零开始学习所有东西要高效得多。
注:大模型的发展日新月异,目前有些模型已经支持了 1M 长度上下文了
敲黑板: 针对长文本的支持,主流方式仍是采用大量短文本数据进行预训练的方式,并在此基础上通过少量长文本的训练来提高模型对长文本输入的支持。这里重点是什么,重点在于即使做了非常多的工作来增加长文本的支持。
五、模型实现
到这里你已经大致了解大语言模型的工作原理和实现细节,那么知道了这些对我们实践应用有哪些指导意义呢?
5.1 多模态输入
已知使用的DeepSeek V3输入是文本,那猜测这里大概率的工程实现是对图片做图像识别,得到一个识别结果的文本,将这个文本和问题一起给到大模型作为输入。
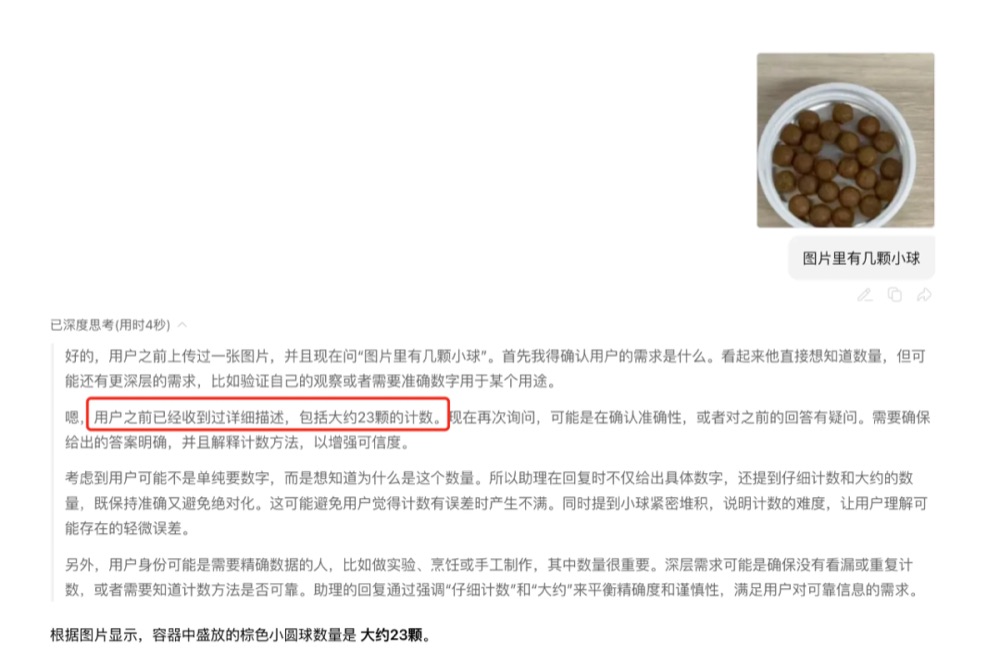
这里也测试了混元(已知混元是多模态的大模型,在输入时是支持输入图像的,简单理解应该是通过编码器将图片转换成跟token类似的输入向量给到Transformer架构),结果也是不对,而且看思考过程很难看出来是真的用了图片特征token还是单纯的在瞎说。
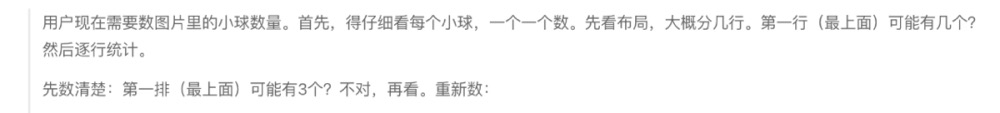
这里想说的是,像DeepSeek这类大语言模型目前主要还是以输入文本为主,对于非文本的需求大概率是通过特殊的工程方案来实现的。
5.2 上下文限制
我们知道模型在短文本(一般是4k)进行了大量训练,理论上这个区间模型效果和稳定性都是最高的,那么在工程实践中应尽量避免长上下文的情况。以Agent为例,关键就是他的prompt(系统提示词)和可用工具列表描述,这部分不应过多(提示词一般对应规则,工具描述对应能力)。
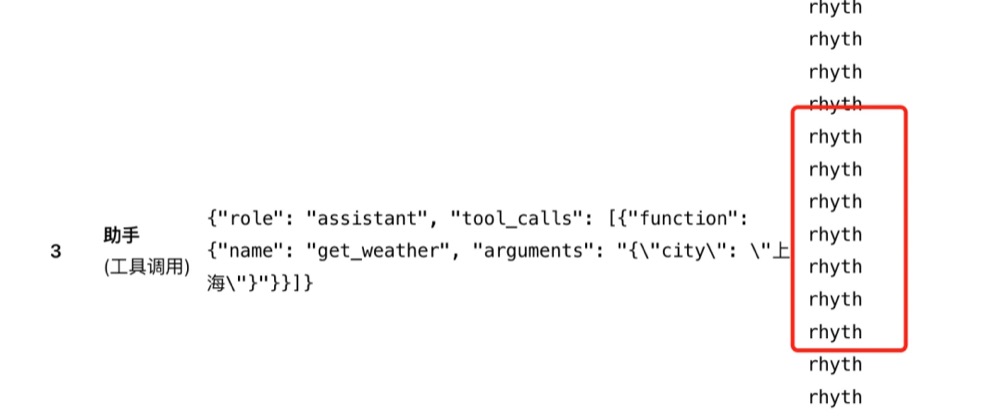
并且过多的规则和可用工具容易导致模型出现混乱,最终输出的格式不符合预期,如下示例实际模型是想输出的调用工具的能力,但是由于输出时格式不对,导致解析失败。
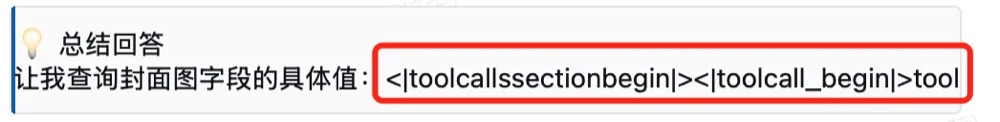
这只是不稳定的变现的一种,有时还会出现循环输出的情况如下图,看完文章你应该能理解这种问题出现的原因(输出是概率预测)
5.3 耗时影响
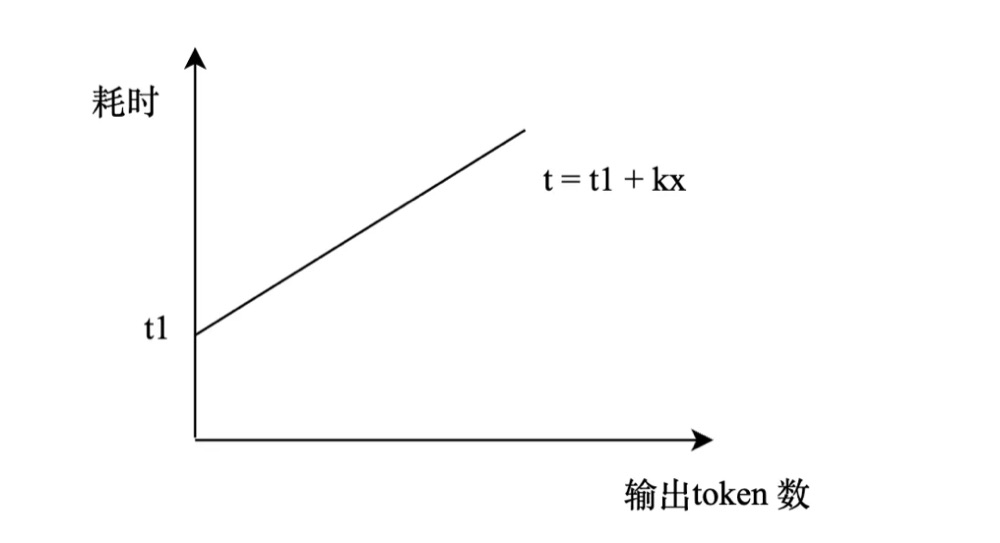
每次调用的耗时由什么决定呢,以上理解我们知道第一个token的输出需要将所有输入上下文全部计算后得到。
这个耗时完全取决于上下文长度,越长则耗时越高(并且是与长度的平方成正相关),随后依次输出。
每个token输出的间隔耗时取决于上下文长度(这里会利用之前计算过的缓存,但仍需要将新的token与上下文所有token进行计算)
所有token输出总耗时取决于输出的字数。因此一次调用耗时的曲线近似可以理解为如下图所示,其中t1与上下文长度平方成正比,直线斜率k与上下文长度成正比。
知道了耗时组成,那么在实践中如果想每次调用耗时降低,我们能做什么呢?
还是减少上下文长度,因为总耗时与长度平方成正比
限制模型单词输出的长度,这里一般可以通过prompt规则或者接口参数限制,因为很多时候大模型会有啰里啰嗦的特性!
5.4 有效减少上下文
实践中我们会发现很多时候模型不总会按预期输出,因此我们会增加很多的规则来提醒模型怎么做,当我们就是有这么多要求怎么办呢,也许你需要拆分了。
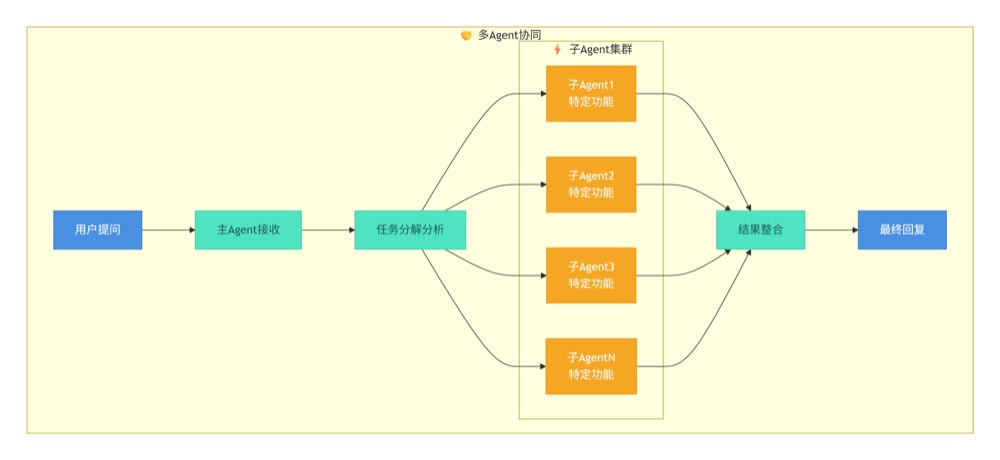
通过 多Agent协同 的方式将你期望的功能进行拆分,每个子Agent对应一部分能力,通过一个主Agent进行统筹规划。
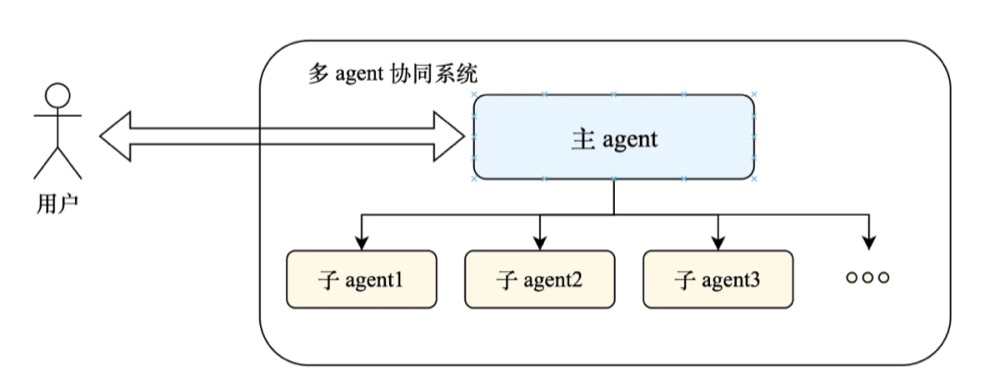
这里主Agent只需要知道每个子Agent能做什么,而不需要知道其对应prompt的具体规则,因此其上下文可以做到尽量的缩小,耗时也会有效降低。
在使用时主Agent只需要将用户提问拆分为不同子任务交由子Agent执行即可。同时每个子Agent的功能相对简单,因此上下文也不会太长。
5.5 历史对话
历史对话过多也会导致上下文的膨胀,不过很多时候用户的问题并不需要历史信息做参考,或者历史信息里包含的有用信息很少,用户很多时候单纯是懒得清理上下文。
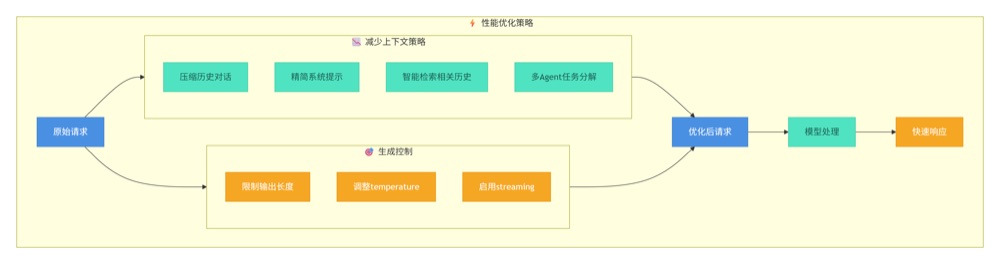
因此工程上可以通过一些方式减少历史对话,一种可行的方案可能是,将历史对话存储起来,在用户提问时,先检索有没有相关记录,并仅将相关记录附在历史对话里。
万字长文讲透LLM核心:Transformer架构原理解析
最近AI的发展实在是太快了,如图就是让Nano Banana Pro结合《Attention Is All You Need》给的架构图,让孙悟空讲解Transformer的原理,架构图完美还原,接下来还可以用来生成动漫视频,十分有趣。
近期B站上AI二创视频、AI让西游记角色唱歌的视频很火,也尝试做了简单复现,用银角大王唱个歌《奉命张狂》,还是感叹AI的强大。
Nano Banana Pro的强大,特别是其出色的“思考”与“理解”能力,核心来源于它基于以Transformer架构为基础的大模型LLM。
为了更好地理解,本文会结合一个案例, 看看Transformer如何把"Transformer is powerful."翻译成"Transformer很强大。" 。
机器是如何像人类一样理解原文,并翻译成功, 期间会遇到哪些挑战?
机器只懂数字0和1,机器如何理解文字?请看分词章节。
机器如拿到了数字坐标,但文字顺序会让句子含义天差地别,如“狗咬人”和“人咬狗”,机器如何理解文字顺序?请看位置编码章节。
机器知道了语序,但词与词之间的关联关系,如“powerful”是修饰前面“Transformer”的?机器如何理解词与词之间的关系?请看注意力机制章节。
LLM 架构解析
LLM重要论文《Attention Is All You Need》提出的Transformer架构,是当前深度学习模型的基础。 其核心架构就是开头孙悟空讲解的架构图,核心思想就是注意力机制。
attention is all you need Paper.pdf
Transformer架构的核心是Encoder-Decoder结构,编码器负责将输入序列转换为上下文表示,解码器则基于编码器的输出和已生成的输出序列生成下一个输出。
当前主流的LLM架构是只有解码器的模型 (Decoder-only Transformer) 。
但是,模型太深,计算量太大,导致训练困难,所以层数通常是经验和实战的选择。
在确认LLM架构后,就可以开始构建模型了,构建模型时,需要做三件事以把大象装进冰箱:数据、模型、训练。
数据的处理包括:文本数据采集、文本数据预处理、文本数据嵌入。
模型包括:模型架构、模型参数。
训练包括:模型训练、模型评估、模型优化。
为了更好理解 Transformer,还要从另一个视角讲一下文本数据预处理和文本数据嵌入,有助于理解Transformer。
文本数据预处理包括:分词、词嵌入。
Token数据流示例
举例把 "Transformer is powerful." 翻译成 "Transformer很强大。" 时,翻译到 "Transformer很" 时,解码器已经生成了序列。
此时解码器需要根据已生成序列和上下文向量,预测下一个中文词,即 "强" ,已知的Tokens "Transformer很" 输入时,数据流是如则经过每一层的。
生成Q向量:
此时,解码器已经生成了“Transformer 很”。这个已生成的部分序列经过解码器内部的掩码自注意力层处理后,会生成一个代表当前状态(即准备生成下一个词)的查询向量 Q_decoder。
提供K、V向量:
编码器已经为英文句子“Transformer is powerful.”生成了一个完整的输出矩阵。这个矩阵中的每一行都是一个K-V对,分别代表了“Transformer”、“is”、“powerful”和“.”的键和值信息。
计算注意力权重:
模型会计算 Q_decoder 与所有英文词的K向量的点积,得到一个注意力分数向量。经过Softmax归一化后,这个分数向量就变成了权重向量。我们期望在这个权重向量中,对应“powerful”的权重会非常高。
加权求和:
最后,模型用这个权重向量对所有英文词的V向量进行加权求和,得到一个上下文向量。这个向量主要包含了来自“powerful”的信息,并被传递给解码器的下一层,用于最终预测出下一个中文词“强”。
通过这个过程,模型成功地将源语言中的“powerful”与目标语言中的“强”对齐了起来,实现了精准的翻译。
这个过程把一层Transformer过了一遍。 自此,Transformer的主流程已经讲清楚,接下来,我们再来看看Transformer的细节,如果对Transformer的每个“零件”感兴趣,可以接着看本章内容。
分词(token)
举个例子,比如“Transformer is powerful.”,分词后得到“Transformer”、“is”、“powerful”、“.”,其中“.”是句子结束符,表示句子结束,不参与预测。
还想补充的是一种理解方式,可以认为分词就是为了得到一本字典的索引(目录),在transformer预测下一个词时,根据当前用户的输入以及已有的预测输出,去匹配字典中的词,找到最匹配的词,然后输出。
在分词之后,下一步是为所有可能出现的词元构建一个词汇表(Vocabulary)。词汇表是一个从词元到唯一整数ID的映射。
例如,可以为英文和中文分别构建词汇表:
英文词汇表示例:
词元 (Token)
索引 (Index)
(填充符)
0
(未知词)
1
(起始符)
2
(结束符)
3
Transformer
4
is
5
powerful
6
.
7
中文词汇表示例:
词元 (Token)
索引 (Index)
(填充符)
0
(未知词)
1
(起始符)
2
(结束符)
3
Transformer
4
很
5
强
6
大
7
。
8
嵌入(embedding)
把我们的示例词嵌入向量 (维度=4):
词元 (Token)
索引 (Index)
示例向量 (Vector)
Transformer
4
[0.2, -0.5, 0.8, 0.1]
is
5
[0.1, 0.0, -0.2, 0.9]
powerful
6
[0.3, -0.4, 0.7, 0.2]
.
7
[-0.1, 0.1, 0.0, 0.1]
字典的类比
分词是得到了一本字典的目录,想要知道下一个词是什么,就需要去字典里找与上下文最相关的那个词。
但如果只有字典目录,也就是只有字,没有词的释义,很难匹配出最相关的词,于是只能随机表达,让肌肉无规律抽搐。
所以我们需要给每个词一个 “释义”,这个释义就是词嵌入,也就是把词(token)转换为数学表示映射到高维空间中,这样就可以通过计算两个词的距离,来计算两个词的相关性。
中文字典的索引和字的解析如下图:
包括大语言模型在内的深度神经网络模型,没法直接处理我们平时看到的原始文本。
为什么呢?因为文本数据是 “离散” 的 —— 简单说就是一个字、一个词都是单独的个体,不像数字那样能直接算,所以没办法直接用它做神经网络训练时需要的数学运算。
这时候就需要一个办法:把单词变成一种 “连续值向量” 的格式,这样才能让模型用起来。
词嵌入的过程
详细的过程以看下面的动图,是一个3个词元,48维度的词元嵌入过程:
2_3个词元,48维度的词元嵌入过程.gif
3个词元,48维度的词元嵌入过程
这里维度占据存储空间取决于模型运行时使用的数值精度(数值数据类型)。在深度学习领域,最常见的数据类型是32位浮点数(FP32)和16位浮点数(FP16/BF16)。
不仅是文本,像视频、音频这些不同类型的数据,也能通过专门的神经网络层,或者借助另一个提前训练好的神经网络模型,转换成这种神经网可用的数据格式,这个过程就叫 “嵌入”。
嵌入的分类:
说到底,嵌入的本质其实很简单: 把那些离散的东西(比如单个单词、一张图片,甚至一整篇文档),对应到一个连续的向量空间里,变成一个个 “点”。 这么做的主要目的,就是把文字、图像这种非数值的数据,转成神经网络能读懂、能处理的格式。
另外,词嵌入中 “维度” 可以从 1 维到几千维不等。一般来说, 维度越高,越能捕捉到数据里那些细微的关系 —— 比如单词之间更复杂的关联。维度越高我们的计算代价就更高,计算起来会更慢,效率会下降,所以还需要做出权衡。
为更清晰直观理解词嵌入,这里举例tensorflow上Word2Vec词嵌入模型在200维度的情况对71291个词元的嵌入结果,再降维到3D,并可视化后的情况,可以直观的看到词元之间的空间情况。可以跳转网页上直观感受动画效果。
词嵌入外,在AI常见应用中,还有句子嵌入、段落嵌入、文档嵌入等,如RAG应用。
位置编码(Positional Encoding)
Transformer模型的一个核心特点是其并行计算能力,它不像循环神经网络(RNN)那样按顺序处理序列。
然而,这种并行性也带来了一个问题:模型本身无法感知词语在序列中的位置或顺序。
为了解决这个问题,Transformer引入了位置编码(Positional Encoding)机制。
以下为案例中的句子“Transformer is powerful.”添加位置编码。假设嵌入维度是4,可以使用简化的位置编码函数来生成每个位置的编码向量。
词元 (Token)
位置 (Position)
词嵌入向量 (Embedding)
位置编码向量 (Positional Encoding)
最终输入向量 (Final Input)
Transformer
0
[0.2, -0.5, 0.8, 0.1]
[0.0, 1.0, 0.0, 1.0]
[0.2, 0.5, 0.8, 1.1]
is
1
[0.1, 0.0, -0.2, 0.9]
[0.8, 0.6, 0.8, 0.6]
[0.9, 0.6, 0.6, 1.5]
powerful
2
[0.3, -0.4, 0.7, 0.2]
[0.9, -0.9, 0.9, -0.9]
[1.2, -1.3, 1.6, -0.7]
.
3
[-0.1, 0.1, 0.0, 0.1]
[-0.9, 0.9, -0.9, 0.9]
[-1.0, 1.0, -0.9, 1.0]
在这个例子中,每个位置的词元生成了一个独特的位置编码向量,并将其与词嵌入向量逐元素相加,输入嵌入=词元嵌入矩阵+位置编码矩阵。
位置编码的实现方式有很多种,大致分为两种:
绝对位置编码:直接与序列中的特定位置相关联。
相对位置编码:关注的是词元之间的相对位置或距离,而非它们的绝对位置。输入嵌入经过归一化后,可以传递到注意力层。
神经网络
神经网络(Neural Network,NN)是受生物神经网络启发而建立的一种数学模型,它由大量的人工神经元相互连接构成。
4层神经网络
输入层 ——输入层由 n 个神经元组成,即 x1、x2、x3、……、x_n。
隐藏层 ——第一个隐藏层由 n-1 个神经元组成,即 h21、h22、h23、……、h_n-1,第二个隐藏层由两个神经元组成,即 h31 和 h32。
输出层 ——输出层有输出 O1,O2,……,On-2。
并初始化一些随机权重 W1,W2,………,W_n。
输入层由偏差 b1 组成。
再来看一个复杂的神经网络:
图中每一个红框都是一层神经网络,如davinci版本包含96层神经网络,DeepSeek R1的61层MoE + 前3层密集层Kimi K2的神经网络层数为61层,其中1层为密集层,其余60层为MoE层,最近发布的Kimi K2 thinking也是一样的层数设计。
注意力机制
编码器(Encoder)是Transformer模型的核心组件之一,其主要任务是接收经过预处理的输入序列(即融合了位置信息的词嵌入向量),并将其转换为一个富含上下文信息的特征表示。这个特征表示捕捉了输入句子中所有词语之间的复杂关系,包括语法结构和语义依赖。
为什么需要注意力机制?解决的是在预测下一个词时,要理解上下文的关系,才能更好的预测下一个词,让模型表现更好。
这就需要使用注意力机制捕捉数据依赖关系,是现代深度学习模型中非常常见的做法。
注意力机制包括:自注意力机制、多头注意力机制、位置编码、注意力机制的变体等。
注意力机制
原理
传统的注意力机制关注的是两个不同序列元素之间的关系。在自注意力机制中,“自”指的是该机制通过关联单个输入序列中的不同位置来计算注意力权重的能力。
核心思想:让每个词关注句子中的其他词。
它可以评估并学习输入各个部分之间的关系和依赖,如句子中的单词或图片中的像素。如下图中的"doc"就需要计算整个输入序列中各个元素之间的关系,从而计算出每个元素对应的权重 $$\text{w} $$ ,再以此计算出上下文向量 $$z^{(i)} $$ 。
在自注意力机制中,我们的目标是为输入序列中的每个元素计算上下文向量。上下文向量(context vector)可以被理解为一种包含了序列中所有元素信息的嵌入向量。
一个输入序列,记为x,它由T个元素组成,分别表示为x((1))到x((t))。
嵌入化词元序列之间的注意力权重α= 注意力分数w的归一化
注意力分数w=词元x((n))与其他词元的点积而得;点积值越大则这两个词元相似度越高(即对齐度越高)
注意力分数归一化softmax后得到每一个词元的注意力权重α,即获得总和为1的注意力权重
最后上下文向量Z((n))=SUM(所有X((i))与其注意力权重α ✖️ 嵌入化词元本身的矩阵),即注意力权重和词元嵌入矩阵相乘后,再求和。
位移词元下标i,循环以上步骤,将所有词元的注意力权重都计算出来。
图中是列举 i=2 的此词元注意力上下文向量。
从RNN的缺陷到自注意力机制
与传统的 RNN 和 CNN 相比,Transformer 具有两大显著优势:
长距离依赖问题解决:
传统的 RNN 难以捕捉序列中相距较远词语的关系,而 Transformer 的自注意力机制可以直接建模任意位置之间的依赖关系,就是允许解码器访问编码器的所有隐藏状态。
并行计算能力:
RNN 的时序依赖特性导致无法充分利用 GPU 并行能力,而 Transformer 的并行处理能力使其能够高效利用现代硬件资源。
自注意力机制也叫做点积缩放点积注意力(scaled dot-product attention)。
具有可训练权重的自注意力机制,引入了在模型训练期间会更新的权重矩阵(Wq、Wk、Wu),这三个矩阵用于将嵌入的输入词元x((i))投影为查询向量、键向量和值向量,使得模型(特别是模型内部的注意力模块)能够学习产生“良好”的上下文向量。
案例拆解:分析“powerful”如何关联到“Transformer”
回到案例 “Transformer is powerful.” ,并聚焦于单词 “powerful” 。在自注意力机制中,当模型处理 “powerful” 这个词时,它会生成一个查询向量 Q_powerful 。
同时,句子中的每个词(包括 “Transformer” 、 “is” 和 “.” )都会生成自己的键向量K和值向量V。接下来, Q_powerful 会与 K_Transformer 、 K_is 、 K_dot 进行点积运算,计算出 “powerful” 与句子中其他每个词的相关性得分。
由于 “powerful” 是用来描述 “Transformer” 的,我们可以预期Q_powerful与K_Transformer的点积结果会是一个较高的值。这个得分经过Softmax函数归一化后,会得到一个较高的注意力权重。
因此,“powerful”的最终表示将主要包含“Transformer”的信息,从而建立起“powerful”和“Transformer”之间的强关联。
为什么是Q、K、V?
在注意力机制的上下文中,K“键”、Q“查询”和V“值”这些术语是从信息检索和数据库领域借鉴来的,在这些领域中,类似的概念被用于存储、搜索和检索信息。
“查询”(query)类似于数据库中的搜索查询。它代表模型当前关注或试图理解的项目(例如,句子中的一个词或 Token)。查询用于探查输入序列的其他部分,以确定应该给予它们多少注意力。
“键”(key)类似于数据库中用于索引和搜索的键。在注意力机制中,输入序列中的每个项目(例如,句子中的每个词)都有一个关联的键。这些键用于与查询匹配。
“值”(value)在这个上下文中类似于数据库中键值对的值。它代表输入项目的实际内容或表示。一旦模型确定哪些键(哪些输入部分)与查询(当前关注项目)最相关,它就检索相应的值。
在计算得到注意力分数w((21))-w((2T))后,我们要进一步计算出注意力权重α((21))-α((2T)),再将注意力分数转换为注意力权重,通过缩放注意力分数并应用softmax函数来计算注意力权重。
最后,将每个词元的值向量u((1))-u((t))-分别与权重矩阵α((21))-α((2T))相乘再求,得到上下文向量z((2))。
回顾整个计算过程,总结为一张图:
因果注意力机制
因果注意力,也称为遮蔽注意力(masked attention),是自注意力的一种特殊形式。它限制模型在处理任何给定 Token 时,只考虑序列中之前和当前的输入。这与标准的自注意力机制形成对比,后者允许一次访问整个输入序列。
当然还存在利用dropout随机掩码的机制,来减少大语言模型中的过拟合问题。
多头注意力机制
接下来将多头注意力机制引入到模型中,以获得更强的表示能力。
案例说明:一个头关注语法,另一个头关注语义
以“Transformer is powerful.”为例,来具体说明多头注意力是如何工作的。假设有两个注意力头(Head 1 和 Head 2)。
Head 1 (关注语法结构) : 这个头可能会学习到句子的语法结构。当它处理“is”这个词时,它可能会将大部分注意力权重分配给“Transformer”和“powerful”,因为它识别出这是一个“主语-系动词-表语”的结构。它的输出将主要编码这种语法关系。
Head 2 (关注语义关系) : 这个头可能更关注词汇之间的语义关系。它会发现“powerful”是描述“Transformer”的一个形容词,因此当处理“Transformer”时,它会特别关注“powerful”这个词。它的输出将主要编码这种语义上的修饰关系。
通过组合这两个头的输出,模型可以获得一个更丰富、更多维度的上下文表示,从而更全面地理解句子的结构和含义。
以下是两个注意力头的例子:
一个注意力头数为3,词元数量为3,嵌入维度为48的注意力计算过程:
1、注意力层是由N多个头组成的,举例GPT-2注意力头数是12,GPT-3注意力头数是96头,GPT-4、GPT-5尚未公开,DeepSeek R1也未公布,估计与GPT-3相当。我们为了方便,仅看其中一个注意力头,这里列出了列出注意力投的Q、K、V权重。
2、我们先只看其中一列的V向量计算过程;为了生成其中一个向量,我们执行矩阵向量乘法并添加偏差。每个输出单元都是输入向量的某种线性组合。例如,对于 Q 向量 ,这可以通过 Q 权重矩阵的一行与输入矩阵的列之间的点积来实现。
3_V向量计算过程.gif
V向量计算过程
3、我们重复上一步,将Q、K、V与输入的点积度计算出来。
4_Q、K、V与输入的点积度计算.gif
Q、K、V与输入的点积度计算.gif
4、然后再将Q与K的向量求和,得到注意力权重矩阵,再将权重矩阵做softmax归一化,将归一化的注意力权重矩阵的每个元素与V向量矩阵对应的相乘,最终我们的到了这一列的V向量矩阵。
5_Q与K的向量求和.gif
Q与K的向量求和.gif
5、接着我们将其他列的向量也计算出来,如此一来,我们将其中一个注意力头的注意力分数算出来了。
6_注意力头的注意力分数.gif
注意力头的注意力分数.gif
6、我们要把每一个注意力头的注意力分数叠在一起,然后执行投影来获得该层的输出。这是一个简单的矩阵向量乘法,基于每列进行,并添加了一个偏差。现在我们得到了自注意力层的输出。我们不是将其直接传递到下一个阶段,而是将其逐个元素地添加到输入嵌入中。这个过程用绿色垂直箭头表示,称为残差连接或残差通路 。
7_矩阵向量乘法.gif
矩阵向量乘法.gif
往后还有一层MLP和归一化之后再输出本层输出。
FFN/MLP(多层感知机)
举例一个两层神经网络的MLP,追踪其中一个向量的MLP计算过程:
在 MLP 中,将每个 C = 48 长度的列向量(独立地)放入每个 MLP 层。然后,我们应用 GELU 激活函数,然后再次将向量投影回长度 C。GELU 是一个非线性激活函数,它将输入向量中的每个元素映射到 0 到 1 之间的值。这有助于模型学习更复杂的函数,而不仅仅是线性函数。
1、首先进行矩阵向量乘法,将向量扩展为长度 4 * C 的向量(动图中示例为92),添加了偏差(MLP Bias)的线性变换 。
2、对向量中的每个元素应用 GELU 激活函数。这是所有神经网络的关键部分,通过它为模型引入一定的非线性特性。所使用的 GELU 函数看起来与 ReLU 函数(计算方式为 max(0, x))非常相似,但它具有平滑的曲线而非尖锐的转角。
3、然后,通过另一个带偏置的矩阵向量乘法,将向量投影回长度为 C 的维度。与自注意力+投影部分类似,将多层感知器的计算结果逐元素地加到其输入上。
接下来,对输入中的所有列重复此过程,最终多层感知机部分已完成。于是,我们现已获得Transformer 其中一层的输出结果,该结果已准备就绪,可传递至下一层。
堆叠Transformer层
正如深度学习中常见的情况一样,很难确切地说出每一层的具体功能,但有一些大致的思路:
较靠前的层往往专注于学习较低级别的特征和模式,而较靠后的层则学习识别和理解较高级别的抽象概念和关系。
在自然语言处理的语境中,较低层可能学习语法、句法和简单的词语联想,而较高层可能捕捉更复杂的语义关系、篇章结构以及依赖于上下文的含义。
图中每一个红框是一层Transformer,每个Transformer包含N个头,以及一个前馈神经网络(FFN/MLP)子层。
案例讲解:逐步生成翻译
现在,让我们完整地模拟解码器是如何一步步生成“Transformer很强大。”这个翻译结果的。这个过程是自回归的,每一步都依赖于前一步的输出。
第一步:生成“Transformer”
输入: <START> 标记。
过程: 解码器接收到 <START> 标记,并结合编码器提供的关于整个英文句子的上下文信息。通过编码器-解码器注意力机制,模型发现当前最相关的信息是整个句子的主语“Transformer”。
输出: 模型预测出第一个词是“Transformer”。
第二步:生成“很”
输入: <START> Transformer 。
过程: 解码器现在知道已经生成了“Transformer”。它通过掩码自注意力机制处理这个部分序列,并通过编码器-解码器注意力机制关注英文句子。此时,模型需要决定如何翻译系动词“is”。在中文里,“is”在这里被翻译为程度副词“很”,用来修饰后面的形容词。
输出: 模型预测出下一个词是“很”。
第三步:生成“强”
输入: <START> Transformer 很 。
过程: 解码器处理已生成的部分,并通过编码器-解码器注意力机制,将注意力高度集中在英文单词“powerful”上。模型开始翻译“powerful”这个形容词,并首先生成其第一个字“强”。
输出: 模型预测出下一个词是“强”。
第四步:生成“大”
输入: <START> Transformer 很 强 。
过程: 解码器继续处理,并再次关注“powerful”。它意识到“强大”是一个更完整的翻译,因此生成第二个字“大”来完成这个形容词。
输出: 模型预测出下一个词是“大”。
第五步:生成句号“。”
输入: <START> Transformer 很 强 大 。
过程: 解码器注意到英文句子以句点“.”结束,并且根据已生成的完整中文句子,判断翻译已经完成。因此,它会生成一个对应的中文句号“。”。
输出: 模型预测出下一个词是“。”。
至此,整个翻译过程结束。
可视化注意力权重
下面是一个模拟的注意力热图,展示了英文源句“Transformer is powerful.”与中文目标句“Transformer很强大。”之间的对齐情况。
注:*颜色越深表示注意力权重越大,数值代表注意力权重的概率分布。
“Transformer”与“Transformer”的高权重连接
从上表可以看出,当解码器生成第一个中文词“Transformer”时,它对英文单词“Transformer”的注意力权重高达0.95(深色区域)。
这表明模型正确地识别出这是一个专有名词,应该被直接“复制”到目标句子中,而不是翻译成“变形金刚”。
这种高权重的连接清晰地展示了模型如何进行直接的词汇对应。
“powerful”与“强”、“大”的权重连接
在生成中文形容词“强大”时,模型的注意力主要集中在英文单词“powerful”上。
具体来说,生成“强”时,对“powerful”的权重是0.50,生成“大”时,对“powerful”的权重是0.35。
这表明模型将“powerful”的语义信息拆分并映射到了中文的两个字上。这种一个源语言词对应多个目标语言词的情况,在翻译中非常常见,注意力机制能够很好地处理这种复杂的对齐关系。
“is”与“很”的权重连接
英文中的系动词“is”在中文里被翻译为程度副词“很”。在注意力热图中,我们可以看到当生成“很”时,模型对“is”的注意力权重达到了0.80。
这揭示了模型超越了简单的字面翻译,而是理解了“is”在这里的语法功能,并找到了其在中文里最恰当的对应表达。
这种对语法和语义的深层理解,正是Transformer强大能力的体现。
在理解了transformer最核心的知识注意力机制、FFN 、多层感知机(MLP)、规范层(Layer Norm)、归一层(Softmax)。就可以开始构建大语言模型架构了,之后就是预训练、微调、部署模型了。
当前LLM架构
主流LLM
主流大模型版本迭代速度非常快,很多模型甚至都带来了独特的创新,能在特定领域达到SOTA。其中特别是开源的模型,给AI平权带来很大的力量。如下图所示:
LLM架构变化
一篇详细比对LLM架构的文章:
The Big LLM Architecture Comparison From DeepSeek-V3 to Kimi K2: A Look At Modern LLM Architecture Design
文中观点一些旗舰开源大语言模型(LLM)在架构上的发展变化。虽部分组件如位置编码、注意力机制、激活函数有改进,但整体架构基础变化不大。当前头部的LLM架构都是在Decoder-only Transformer上不断做优化,使得训练出来的模型表现越来越好。
小结
在理解AI应用的时候,可以思考模型本身为什么需要这种应用模式才能表现出这样的能力,从而更深入触及模型的原理,知其长短优劣,知其然知其所以然。
如下图,蚂蚁集团9月份发布的《大模型开源开发生态全景》报告可以看到,100天的时间,很多应用出局了,甚至很多基础设施项目也在不断更迭,大名鼎鼎的TensorFlow已经被抛弃了,而PyTorch却越来越受欢迎。
有很多观点认为某种应用形态是伪需求,是过度设计,这是基于当前模型能力而言的。如最近在提的Context Engineering,许多人就提出RAG很快就会消亡的观点。
万变不离其宗, 模型能力是根本,应用形态是是上层建筑。 在模型能力不足的情况下,应用形态会不断演变,以弥补模型能力的不足。在模型能力足够的情况下,应用形态会逐渐消亡。
于是,既要关注模型能力的提升,也要关注应用形态的演变。只有两者结合,才能让模型发挥出最大的价值。
MiniMax M2.7:核心亮点解析 + 真实Agent实战测试
就在最近,距离上一次发布 MiniMax M2.5 仅过去一个月,MiniMax 再次迎来重磅更新!
MiniMax M2.7 是 MiniMax 最新发布的旗舰大模型版本,它提出了 “模型自我进化(Self‑Evolution)” 的全新范式 。与以往版本相比,它首次实现了 深度参与自身训练与优化过程的能力 , 标志着 AI 模型从“被动工具”向“具备自我进化能力的智能系统”迈出了关键一步。
一、核心技术亮点解析- 模型自我进化机制
M2.7 最重要也是最创新的特点是—— 它能参与自身的训练/优化流程,而不是单纯依靠工程师去改代码和调参
1、什么叫“模型自我进化”?
对比人类传统的大模型训练流程,M2.7 直接参与到了 对自身的训练与提升循环中 。这让它不仅是“工具”,更像是一个 自己会学习的“智能体”级系统 。
生成清晰无水印图片.png
2、“自我进化”的执行循环直观模型
可以把 M2.7 的自我进化想象成一个 持续反馈循环, 每一轮循环都会让模型逐步逼近更优结果:
执行任务 → 评估结果 → 分析失败点 → 生成反馈 → 更新策略 → 再次执行 → 重复
在官方提供的例子中,M2.7 实际运行过 超过 100 轮这种循环 : 模型不断分析失败轨迹、制定修改策略、执行评测,然后决定是保留更改还是回退,从而实现了最终约 30% 的性能提升 。
二、MiniMax M2.7 真实性能评分
从官方公布的多项测试来看,MiniMax M2.7 在本次更新中的最大亮点依旧是 代码能力显著提升 。
在衡量编程实力的 SWE Bench Pro 测试中,M2.7 取得 56.2 分 ,几乎与 Opus 4.6 的 57.3 分 和 GPT-5.4 的 57.7 分 持平,可见其在真实开发任务中的竞争力。
更值得注意的是,在 Multi-SWE Bench (更贴近真实开发场景的综合测试)中,M2.7 得分 52.7 分 ,不仅超过 MiniMax M2.5 的 51.3 分,还反超 Sonnet 4.6、Opus 4.6,甚至 GPT-5.4,直接跃升至该测试排行榜前列。
针对最近热门的 OpenClaw 应用场景,MiniMax 基于其中常用任务构建了评测集 MM-Claw , 覆盖个人学习规划、办公文档处理、 定时信息调研与投资建议、代码开发与维护等工作与生活场景。 在该测试中,M2.7 的正确率达到 62.7% ,接近 Sonnet 4.6 的水平,显示了模型在实际多任务处理中的可用性与稳定性。
当然,M2.7 在部分项目(如 GDPval-AA、Toolathlon)上仍略低于 GPT-5.4、Opus 4.6,但考虑到 仅用一个月时间迭代完成的性能提升 ,其增长速度已经相当惊人。
附表: MiniMax M2.7 的各个 Benchmark 测评内容:
Benchmark
主要评测能力
通俗含义
SWE Bench Pro
编程、改 bug
让 AI 修真实代码问题
Multi-SWE Bench
真实开发、多任务代码能力
让 AI 处理更复杂的软件开发任务
VIBE-Pro
做产品、前后端实现
让 AI 直接做一个能用的网站/应用
MLE-Bench lite
数据处理、建模、调参
让 AI 做机器学习实验
GDPval-AA
分析、判断、执行任务
看 AI 能不能完成真实工作任务
Toolathlon
工具使用、自动化操作
看 AI 会不会调用各种工具
MM-ClawBench
Agent 能力、复杂任务处理
看 AI 作为助手能不能把复杂任务做完
Artificial Analysis
整体能力
相当于综合总分榜
三、快速使用 MiniMax M2.7
最简单的方法,就是去 MiniMax Agent 的官网,目前已经全部放量,所有用户都可以免费用上最新的 MiniMax M2.7 模型。
1、输入任务
在输入框输入你的任务指令,例如:
办公类 :制作 Excel 表格、Word 文档、PPT 汇报
金融类 :分析报表、生成投资简报
编程类 :代码生成、调试、任务自动化
点击提交,MiniMax M2.7 会立即开始处理任务,并根据任务类型自动调用内部 Agent 或专家套件。
2、使用专家套件
页面下方提供分类 专家套组 :
办公 :Word / Excel / PPT / PDF 等日常文档处理
金融 :数据分析、报表生成
编程 :代码生成、调试、自动化
可以直接点击套组图标,快速启动任务模板,降低学习成本。
四、在 Claude Code 使用 MiniMax M2.7
1、订阅套餐
如果你是有 Coding Plan 的专业用户,那可以马上切换到 M2.7 模型,如果没有的话,可以买一个,最便宜的一个月才 29 元。
2、获取 API Key
访问 接口密钥 > 创建 Token Plan Key
3、测试 API 调用(可选)
通过 Anthropic API 兼容,快速测试 MiniMax M2.7
安装 Anthropic SDK
pip install anthropic
配置环境变量
export ANTHROPIC_BASE_URL=https://api.minimaxi.com/anthropic
export ANTHROPIC_API_KEY=${YOUR_API_KEY}
调用 API
import anthropic
client = anthropic.Anthropic()
message = client.messages.create(
model="MiniMax-M2.7",
max_tokens=1000,
system="You are a helpful assistant.",
messages=[
{
"role": "user",
"content": [
{
"type": "text",
"text": "Hi, how are you?"
}
]
}
]
)
for block in message.content:
if block.type == "thinking":
print(f"Thinking:\n{block.thinking}\n")
elif block.type == "text":
print(f"Text:\n{block.text}\n")
4、接入 Claude Code
在 Claude Code 中使用 MiniMax-M2.7 模型进行 AI 编程。
安装 Claude Code
输入以下命令:
curl -fsSL https://claude.ai/install.sh | bash
配置 MiniMax API
为了方便切换模型,最好再安装一个 CC-Switch 。
brew tap farion1231/ccswitch
brew install --cask cc-switch
brew upgrade --cask cc-switch
添加 MiniMax 配置
在 CC-Switch 里面,点击右上角 ”+” ,选择预设的 MiniMax 供应商,并填写 MiniMax API Key。
配置模型名称
将模型名称全部改为 MiniMax-M2.7,完成后点击右下角的 “添加”。
测试使用
一切配置就绪,在命令行输入 Claude 打开 Claude Code,问它背后用的是什么模型,就发现已经用上了 MiniMax-M2.7。
五、真实案例测试
1、办公任务:出报告、图表和PPT
办公任务,直接用MiniMax Agent网页端进行测试。复刻MiniMax官方案例,任务是:
提示词:基于快手2025年财报信息,构建快手的营收模型,读取多个研报,设计对应的假设,基于最新的信息对快手营收建模,然后选择合适的 PPT 模版产出 PPT ,并写一个 Word 文档研究报告和 Excel 图表。
关于财务分析模型,生成的内容是非常全面的,包括财务数据概览、营收模型预测、甚至可灵AI业务分析,需要的部分都提到了,而且图表布局非常合理,几乎无需人工调整,已经是一个初级分析师的水平了,而且在具体的数据方面也没有差错,极大得减少了人工审查成本。
关于Word研究报告,整整10页,字数超2k,结构完整,数据准确,研报该有的它都有。虽然部分字体、格式、排版还是会有点小问题,但整体上问题不大。 以及,这份两千字的研报,它竟然没有出现任何的幻觉问题,这说明M2.7 会根据上下文和内部反馈自动修正格式和逻辑,它让产出结果真实、可信,可以直接走进我们的真实工作流。
关于生成的PPT,样式专业、高端,几乎可直接用于管理汇报了。
最重要的是,以上的全部内容,是一个Prompt完成。M2.7在复杂任务上的指令遵循能力得到了非常大的提升,它可以同时处理数据分析、文档生成和视觉排版。
2、编程任务-3D
通过测试3D的Case,我们可以判断模型的空间想象和逻辑推理能力,看它能否准确理解指令,并创建一个零BUG的视觉图形。案例使用经典的3D魔方,提示词如下:
提示词:Create a single HTML file containing a fully functional 3D Rubik's Cube simulation using Three.js (via CDN). The cube must be able to automatically solve itself.
中文:创建一个HTML文件,其中使用Three.js(通过CDN方式引入)来实现一个功能完备的3D魔方模拟程序。该魔方必须能够自动完成自己的“解谜”过程。
结果非常符合预期,所有功能实现正确,生成速度快,精度高,几乎无需人工修改,而且可直接在浏览器运行。再次证明了M2.7 的复杂任务处理能力,能够处理多线程逻辑和 3D 渲染任务。
1_3D魔方.mov
3、编程任务-前端
同步测试一下它写前端的能力,我们虚构一个AI 键盘“小key”,让M2.7创建它的的产品宣传页,需要视觉美观、功能完备、响应式布局。
提示词:给一款AI键盘「小key」设计产品宣传页。
结果也非常好,页面交互逻辑完整,按钮和链接可直接使用,几乎可作为实际产品宣传页直接发布了。